-
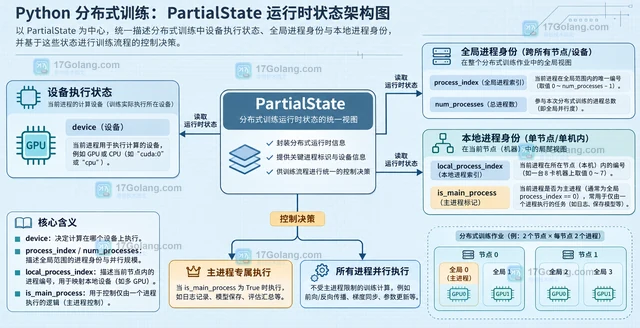
只需要读取分布式脚本的当前设备、全局进程编号、本机进程编号和进程总数时,可以直接使用 Hugging Face Accelerate 的 PartialState。本文用一个最小示例拆开四个属性的区别,并说明主进程输出与多机逻辑的写法。
-
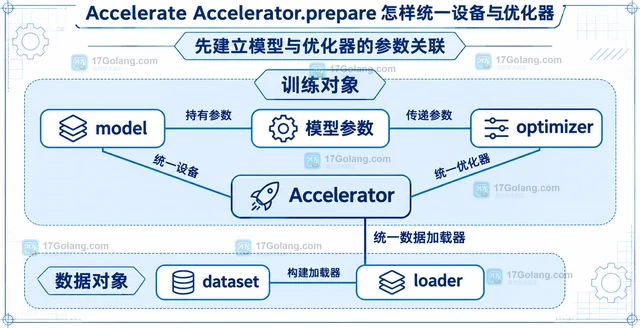
说明 Accelerate Accelerator.prepare 如何一起准备模型、优化器和数据加载器,给出普通训练循环迁移示例,澄清返回值顺序、设备放置、反向入口与分布式启动的责任。
-
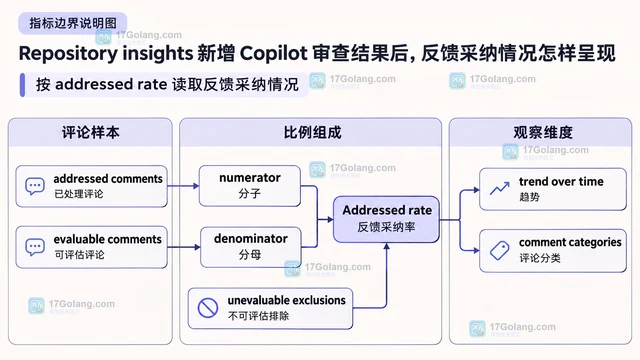
GitHub 公告新增 Repository insights,用四类摘要信号展示 Copilot code review 反馈的处理情况,并补充 addressed rate、趋势、评论分类及 repos-1-day 使用指标 API。本文按公告范围解释怎样读这些数据、页面和 API 的访问前提,以及团队复盘时不应越界解读的部分。
-
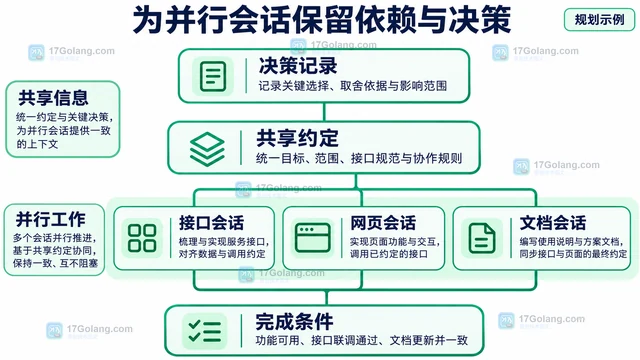
结合 GitHub 官方公布的 Copilot projects 多仓库并行会话能力,用订单详情功能的原创规划案例说明目标拆分、仓库交付项、共享决策与可跟踪的完成条件。
-
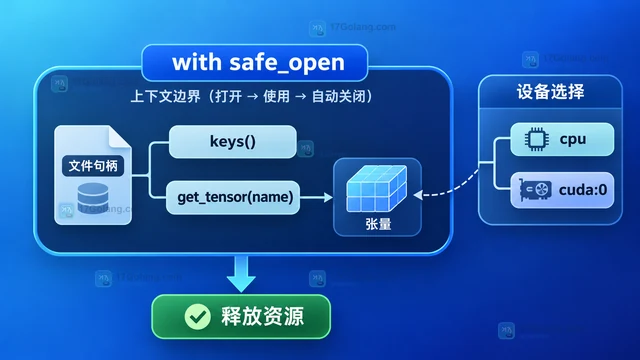
用 safe_open 读取 Safetensors 中的单个张量时,先确认真实键名,再在上下文管理器中调用 get_tensor,并正确处理 framework、device 与键名错误。
-
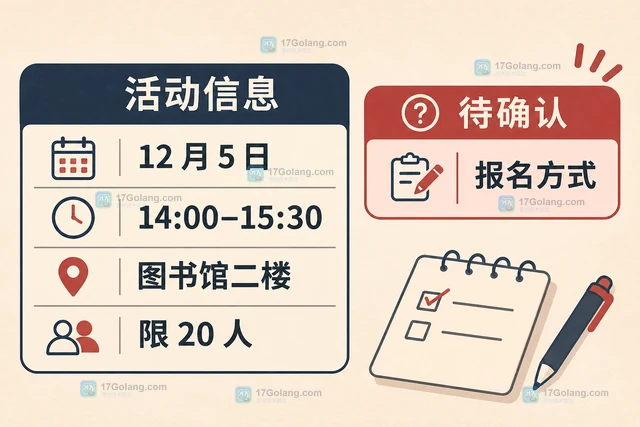
以读书分享会为例,用同一组活动信息在讯飞绘文写校内公告和群通知,逐项核对时间、地点和人数,单独处理待确认的报名方式。
-
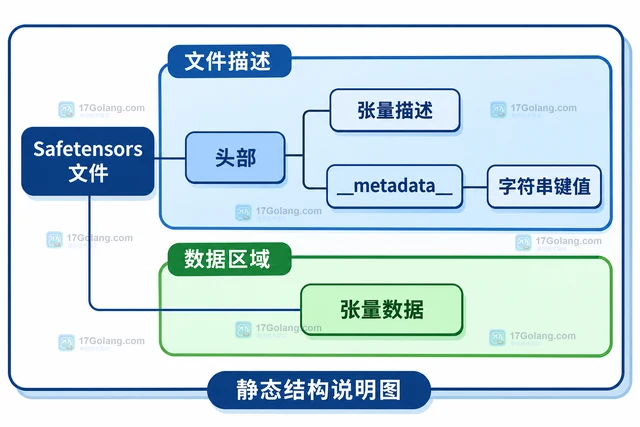
通过safe_open和metadata()读取Safetensors文件级字符串标签,区分None、字段缺失与读取失败,并用临时小文件说明元数据与张量结构、配置文件的区别。
-
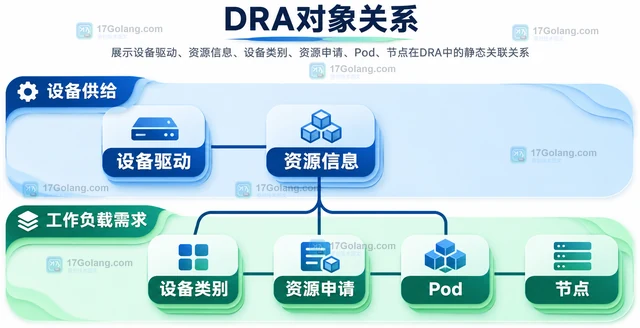
结合 CNCF 公告与 Kubernetes 文档,解释 DRA 如何连接设备类别、资源申请和 Pod,并用 AI 任务规划示例说明采用职责、等待处理与适用范围。
-
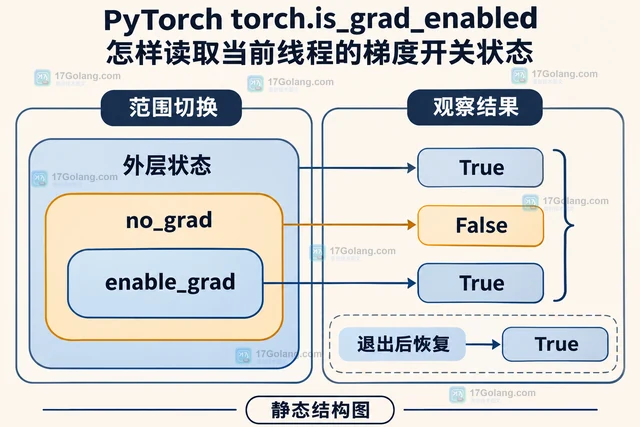
torch.is_grad_enabled() 用于读取当前执行上下文是否开启梯度记录。本文用最小示例说明它在默认模式、no_grad 和 enable_grad 中的变化,并区分它与 requires_grad、model.eval()、inference_mode 的职责。
-
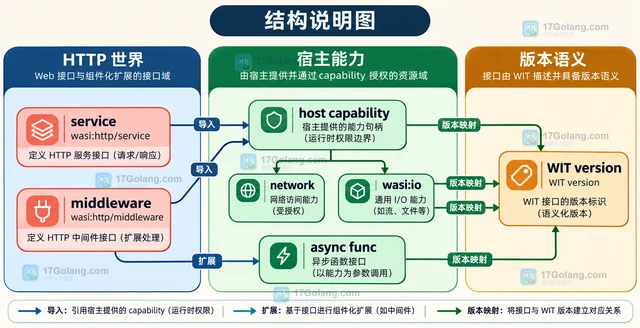
WASI HTTP 的组件化边界不等于一组 URL 路由,而是由 WIT 接口、world 的导入导出、request/response 资源和宿主 capability 共同组成。本文结合 WASI 0.3 的 service 与 middleware 设计,说明怎样划分服务契约、横切逻辑和运行时权限,并提醒 0.2/0.3 的版本边界。
-
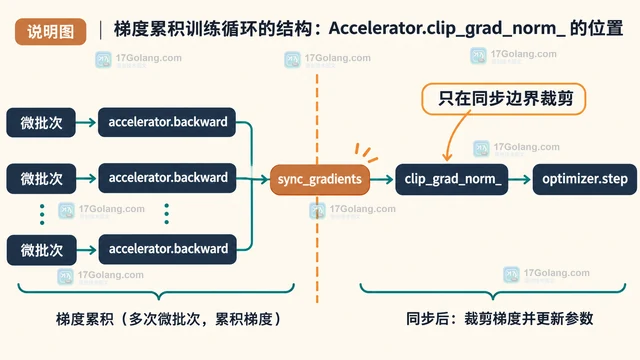
在 Accelerate 的梯度累积和混合精度训练中,使用 Accelerator.clip_grad_norm_ 统一裁剪模型梯度;本文说明调用时机、参数含义、返回值和与 sync_gradients 的配合方式。
-
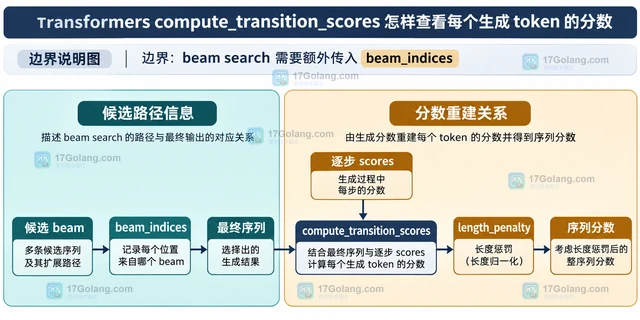
用 Transformers 的 compute_transition_scores 对齐 generate 选中的 token,查看每个 token 的转移分数、对数概率和概率,并区分贪心生成与 beam search 的参数差异。
-
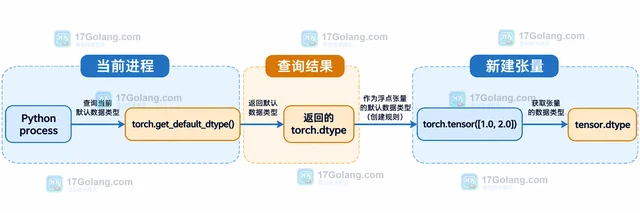
用 torch.get_default_dtype() 读取 PyTorch 当前默认浮点类型,分清已有张量 dtype、显式 dtype 与新建张量默认类型之间的关系。
-
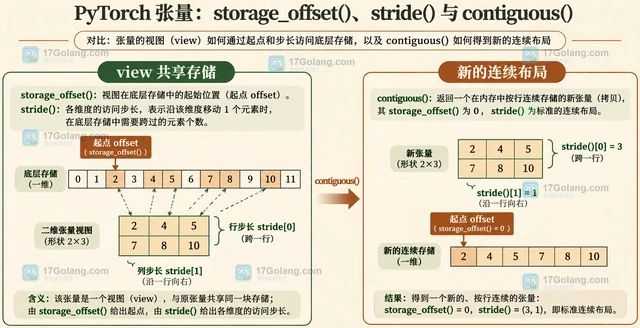
用切片和转置示例说明 PyTorch Tensor.storage_offset() 的读取方式,解释返回值是底层 storage 的元素偏移而非字节数,并把 storage_offset、stride、numel 与 contiguous() 放在同一套布局排查方法中。
-
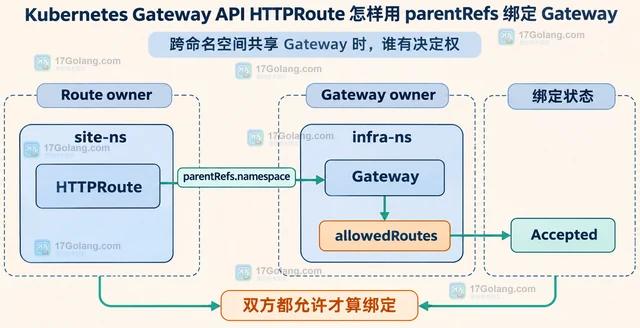
HTTPRoute 通过 spec.parentRefs 声明要绑定的 Gateway;同命名空间通常只写名称,跨命名空间还要写目标 namespace,并满足 Gateway Listener 的 allowedRoutes 约束。本文用原创说明图和 YAML 示例讲清绑定方式、sectionName 选择与 Accepted 状态排查。
