-
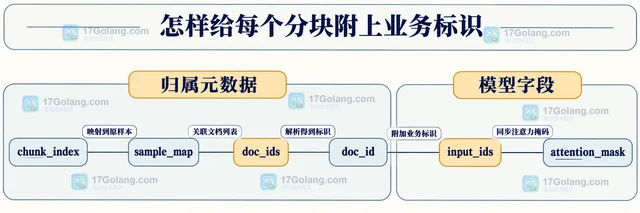
说明 Transformers BatchEncoding 的 overflow_to_sample_mapping 如何关联分块与原批样本,给出 truncation、stride 和业务文档 ID 的处理示例,并澄清分块编号与样本下标的区别。
-
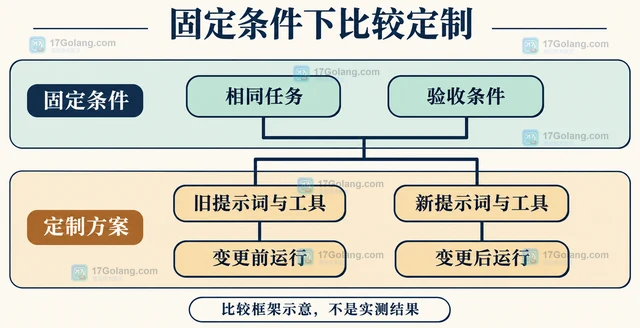
GitHub Copilot Evals 进入公开预览,支持针对技能、代理和 MCP 工具比较定制变更前后的行为。文章区分公告能力与团队采用建议,说明固定任务、验收条件和过程观察的重要性。
-
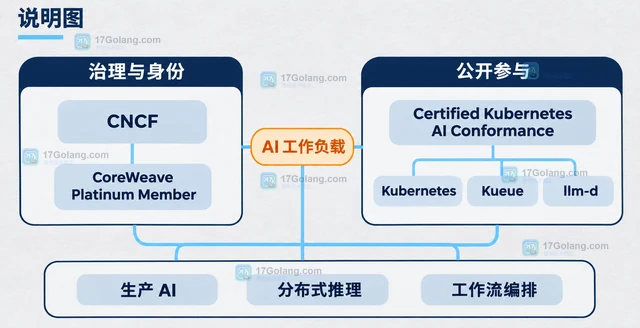
CNCF 公告确认 CoreWeave 升级为白金会员,并列出其参与 Kubernetes AI Conformance、贡献 Kubernetes、Kueue 与 llm-d。本文区分公告事实、可观察的生态信号和不能直接推出的采购、性能与路线图结论。
-
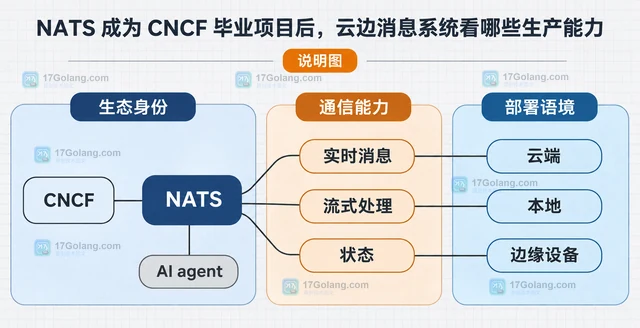
CNCF 公告宣布 NATS 毕业,并将其定位为连接云端、本地和边缘分布式应用的实时通信系统。本文区分消息、流式与状态能力,解释安全审计和治理信号的含义,再给出平台团队评估是否试点的判断清单。
-
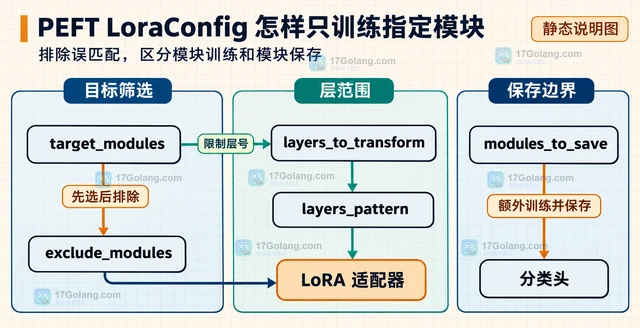
PEFT 的 LoraConfig 怎样只训练指定模块?本文围绕 target_modules 的列表后缀与字符串正则匹配,说明 exclude_modules、modules_to_save、all-linear 的边界,并给出按真实模块名收窄 LoRA 训练范围的 Python 示例。
-
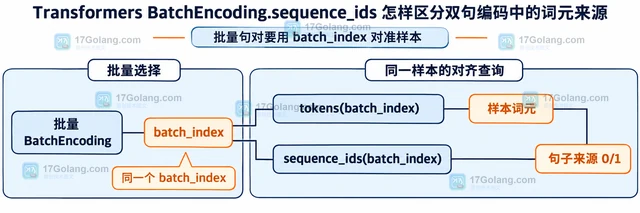
Transformers 的 BatchEncoding.sequence_ids 可以把双句编码中的词元映射回来源序列:特殊词元为 None,第一句为 0,第二句为 1。本文说明 Fast tokenizer、批量下标、padding 以及它和 token_type_ids 的边界。
-
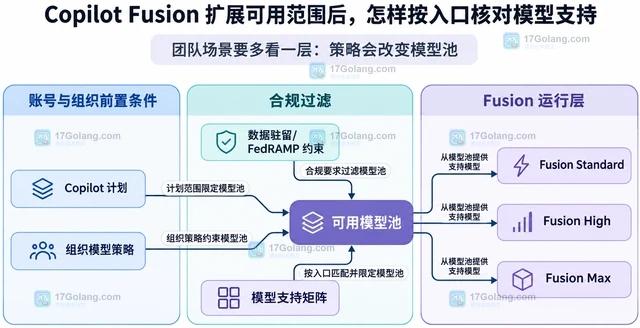
GitHub 于 2026 年 11 月 17 日宣布 Copilot Fusion 扩展到更多入口并加入新模型。本文把公告入口、官方模型矩阵、Fusion effort level 与团队策略拆开,给出一套不误判支持范围的核对顺序。
-
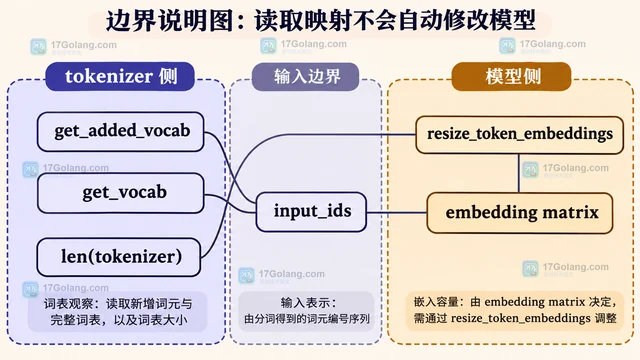
用 Transformers 的 get_added_vocab 读取新增词元到 token id 的映射,并区分 get_vocab、add_tokens 返回值与模型嵌入矩阵之间的边界。
-
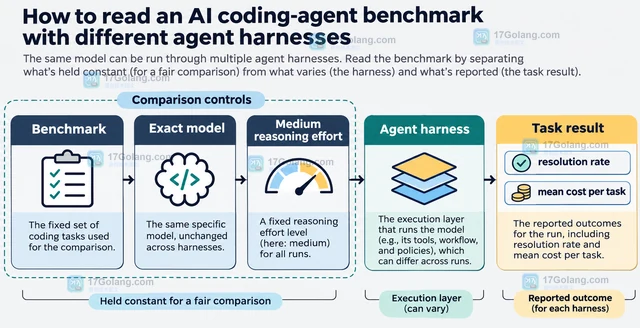
GitHub Copilot 基准站新增 Harnesses 视图并加入 Terminal-Bench-Science 0.1,均处于 public preview。本文按公告范围拆解模型、harness、resolution rate、单任务成本和配对统计,帮助团队正确阅读成绩而不过度外推。
-
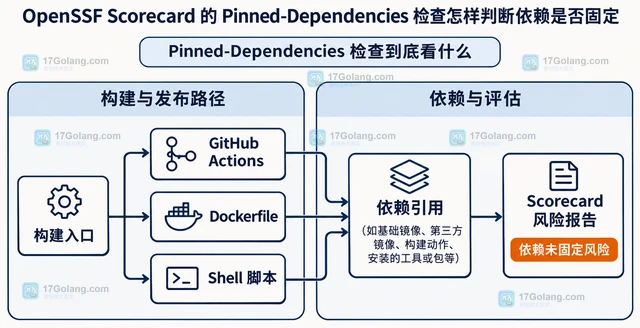
围绕 OpenSSF Scorecard 的 Pinned-Dependencies 检查,解释它看哪些构建依赖、怎样理解报告边界,以及如何把浮动引用改成可复现的版本或摘要引用。
-
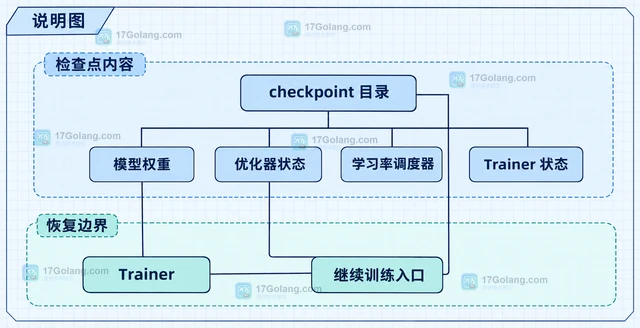
Transformers Trainer 继续训练时,不能只加载模型权重,而要把完整 checkpoint 交给 train(resume_from_checkpoint=...)。本文说明优化器、调度器、global_step、检查点目录和 ignore_data_skip 的关系,并给出显式路径与自动寻找最近检查点的写法。
-
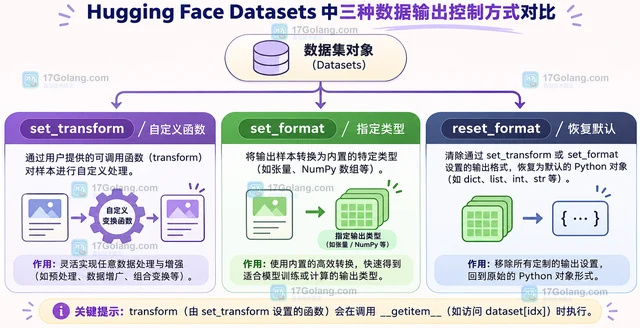
Hugging Face Datasets 的 set_transform 可以在索引或切片取样时按需生成模型输入和派生字段。本文说明 columns、output_all_columns、reset_format 与 with_transform 的边界,并给出保留原始列和生成 tokenizer 字段的原创示例。
-
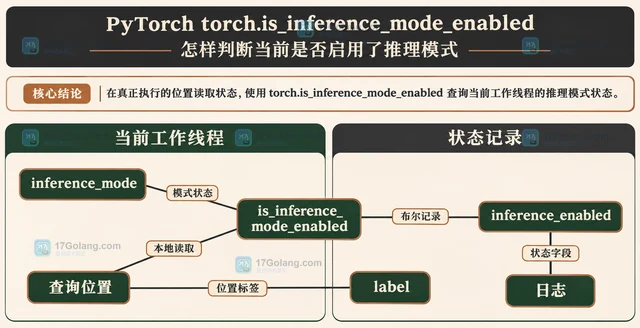
用局部上下文和预测入口示例说明 PyTorch 推理模式查询,解释布尔返回、线程局部性,并区分梯度开关、模型训练标记与推理状态。
-
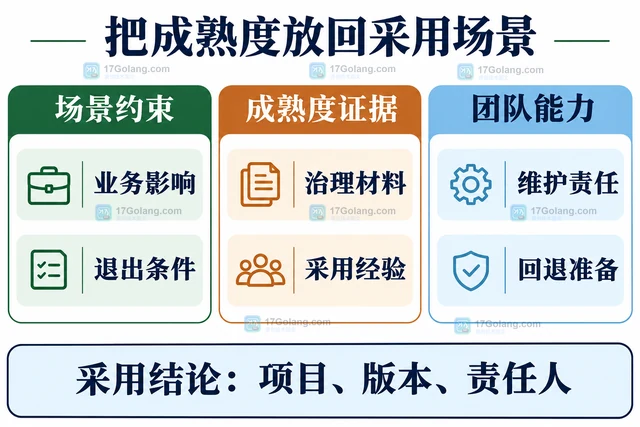
从基础设施选型场景解释 CNCF 孵化与毕业的成熟度含义,比较治理、采用证据和维护责任,并说明怎样将等级纳入工程决策。
-
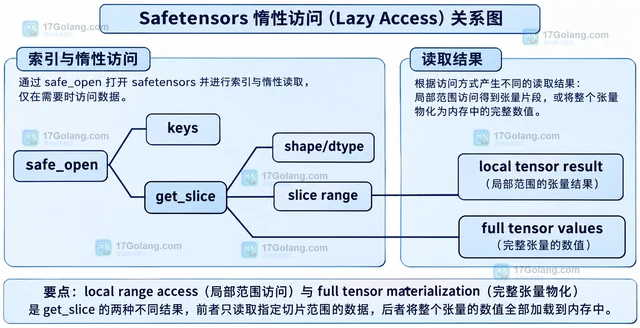
用 safe_open 读取 Safetensors 的张量名、dtype、shape 和文件 metadata,并用 get_slice 按需访问局部数据,避免查看模型结构时加载全部权重。
