-
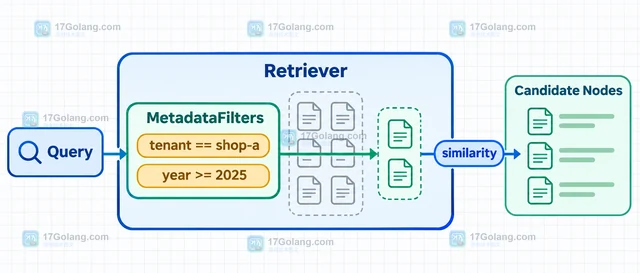
用 LlamaIndex 的 MetadataFilter 和 MetadataFilters 按租户、分类、年份等元数据筛选检索节点,并说明 AND/OR 组合、字段类型和向量库支持边界。
-
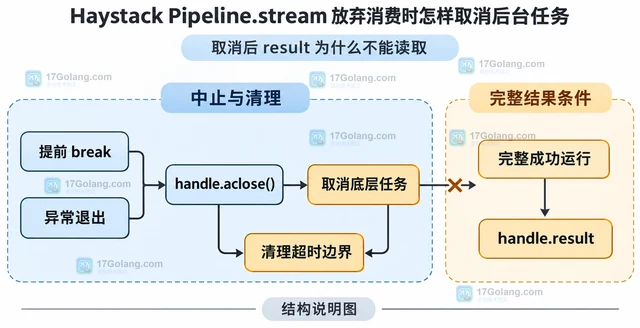
Haystack Pipeline.stream 返回可异步迭代的 PipelineStreamHandle。停止消费流式结果时,建议在 try/finally 中显式调用 await handle.aclose(),取消底层任务并完成有界清理;取消后的 handle.result 不可作为最终结果读取。
-
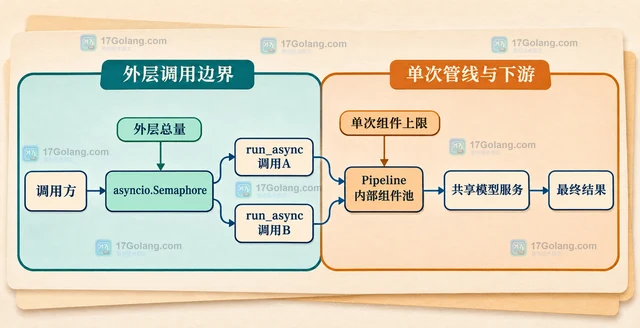
Haystack 的 Pipeline.run_async 可以用 concurrency_limit 限制一次异步管线中同时运行的组件数量。本文区分单次管线、多个调用和组件内部线程池三个边界,并给出 Python 调用示例。
-
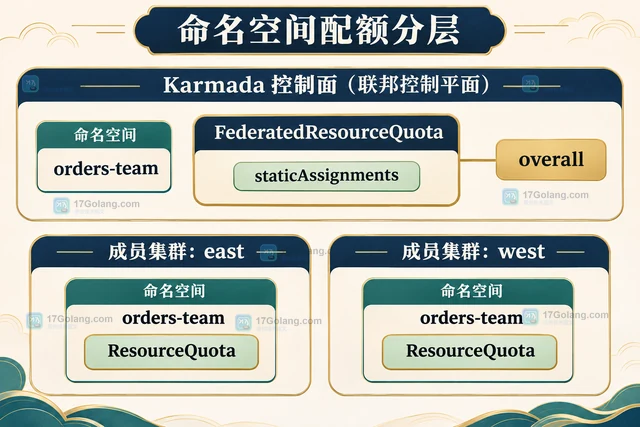
解读 Karmada 按命名空间管理跨集群资源配额的方法,区分 overall、staticAssignments、控制面执行与成员 ResourceQuota,并说明扩容和排查顺序。
-
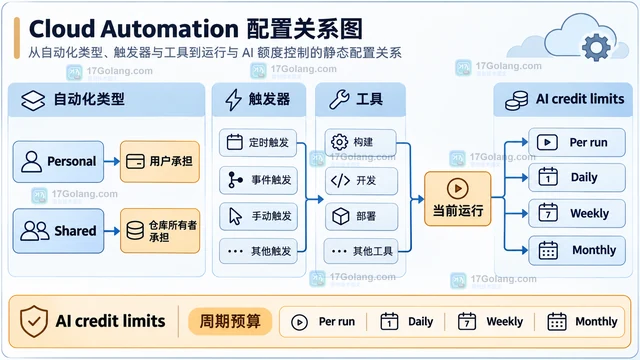
GitHub Copilot Automations 的 Per run 限额会在单次运行达到阈值时停止该运行,最低为 30 AI credits;Daily、Weekly、Monthly 只阻止新运行启动。本文按自动化归属、触发规模和工具权限给出一套可落地的额度配置方法。
-
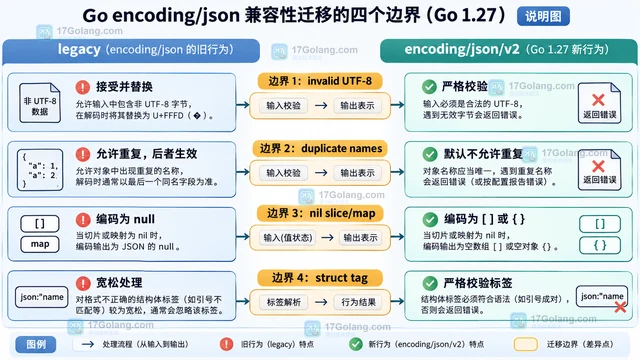
Go 1.27正式提供encoding/json/v2,但它并不是把旧包强制替换掉。本文从无效UTF-8、重复键、nil切片和结构化标签四个边界出发,说明怎样用DefaultOptionsV1分阶段迁移,以及哪些项目应该先保持原有语义。
-
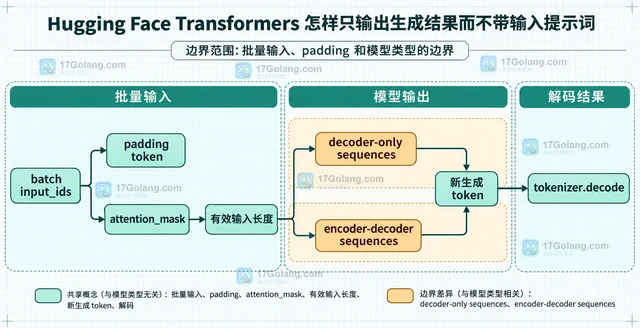
Hugging Face Transformers 的 generate 返回序列可能同时包含输入提示词和新生成 token。本文按 decoder-only、encoder-decoder、批量 padding 三种边界说明如何只解码新增内容,并解释 max_new_tokens、return_dict_in_generate 与 pipeline 输出的区别。
-
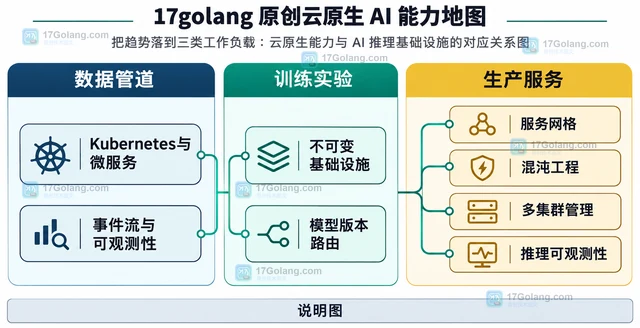
CNCF 2026 年云原生报告显示,Kubernetes 生产使用已较普及,但 AI 模型持续部署仍处于早期。本文按数据管道、训练实验和生产服务拆解推理基础设施趋势。
-
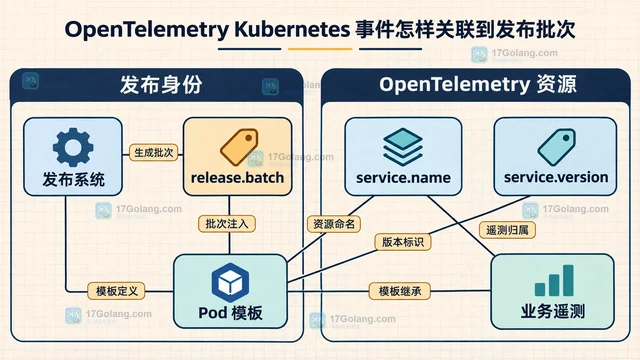
Kubernetes Event 本身不是稳定的发布审计日志。本文用发布批次标签、Pod 模板注解、k8sobjectsreceiver 和 k8sattributesprocessor,把事件与 OpenTelemetry 遥测按同一批次身份关联,并说明事件保留期、重复和语义变化的边界。
-
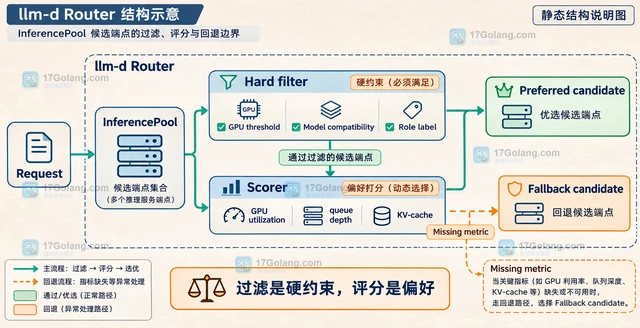
llm-d 并不是把请求直接绑定到某个 GPU 编号,而是由 Router 的 EPP 在 InferencePool 候选端点中综合静态能力、DCGM 利用率、队列、运行请求数和 KV-cache 等信号进行过滤、评分与选择。本文说明怎样拆分这些信号并设计可解释的回退边界。
-
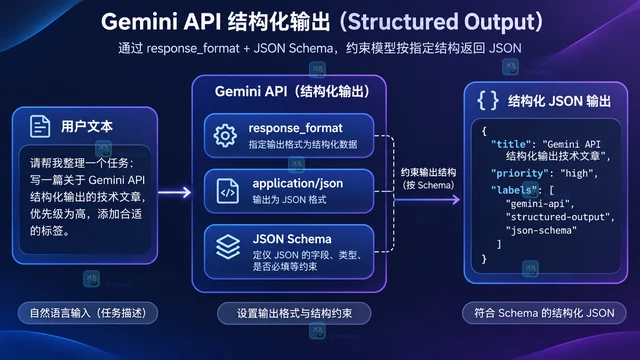
Gemini API structured output 可以让模型按 JSON Schema 返回稳定的对象结构。本文用一个工单字段抽取小例子说明 response_format、application/json、object、enum、array 和本地解析之间的关系,并区分结构约束与业务校验。
-
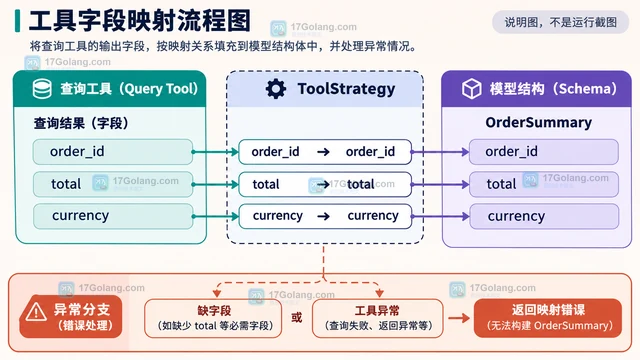
LangChain 的工具返回值不是最终数据模型。本文用 Pydantic 与 ToolStrategy 拆开工具消息、结构化响应和错误边界,说明怎样把查询结果稳定地交给业务代码。
-
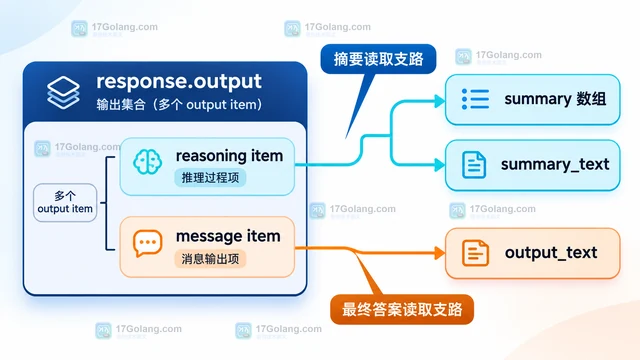
Responses API 不会默认返回 reasoning summary。本文用 reasoning.summary 开启摘要,遍历 reasoning output item 读取 summary_text,并说明 effort、output_text 与模型支持差异。
-
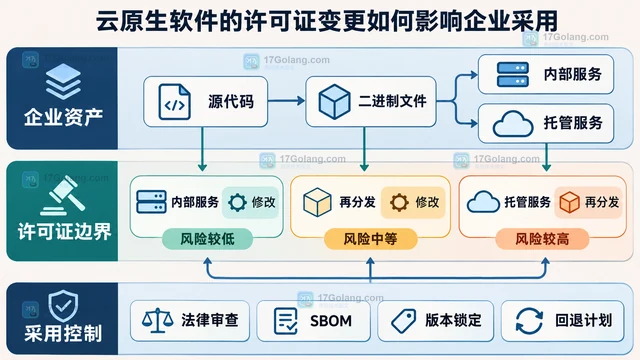
云原生项目改换许可证后,企业真正要判断的不是“还能不能下载”,而是内部运行、修改分发、托管服务和嵌入式产品分别落在哪条许可边界。本文用 CNCF、HashiCorp、Redis 与 OpenTofu 的公开资料,整理版本冻结、供应链审计和替代方案的落地方法。
-
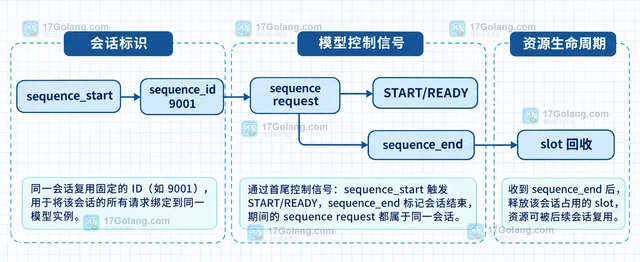
本文围绕 Triton sequence batcher 的 direct scheduling,说明 sequence_id、模型实例、batch slot 和 sequence 控制信号如何配合,让同一会话持续落到同一有状态模型实例;同时区分 direct 与 oldest 策略中 correlation ID 的职责。
