-
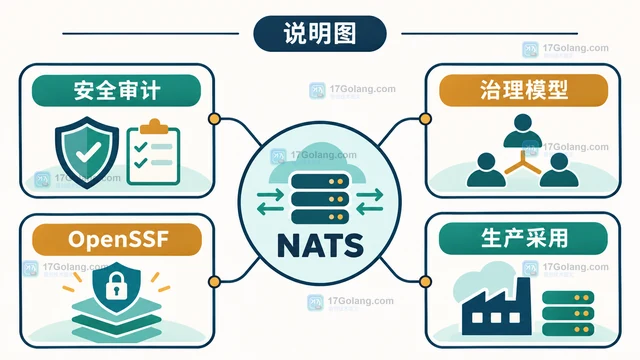
NATS 从 CNCF Incubating 进入 Graduated 后,生产团队应该怎样解读这条信号?本文拆解治理、安全、消息语义和上线检查边界。
-
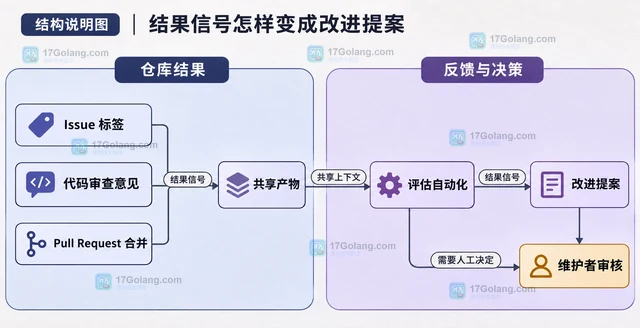
解释 GitHub Copilot automations 如何利用 Issue 标签、代码审查反馈和 Pull Request 合并结果提出改进,并说明人工批准、最小权限、未信任事件过滤与审计边界。
-
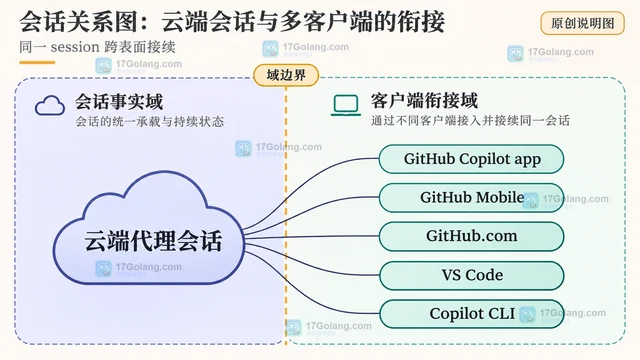
GitHub Copilot session continuity 让同一云端代理会话跨 GitHub Copilot app、GitHub Mobile、GitHub.com、VS Code 与 CLI 接续。本文按运行手册说明如何找回、接管、复盘和停止会话。
-
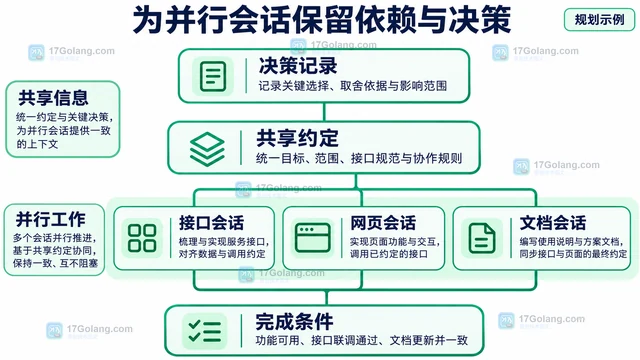
结合 GitHub 官方公布的 Copilot projects 多仓库并行会话能力,用订单详情功能的原创规划案例说明目标拆分、仓库交付项、共享决策与可跟踪的完成条件。
-
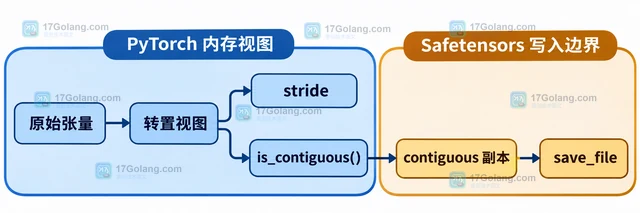
Safetensors 保存转置张量时,关键是在 save_file 边界把非连续视图转换为连续且稠密的 Tensor。本文解释 transpose 的布局变化、contiguous 的复制边界、字典批量处理方式,以及普通张量与共享权重保存的区别。
-
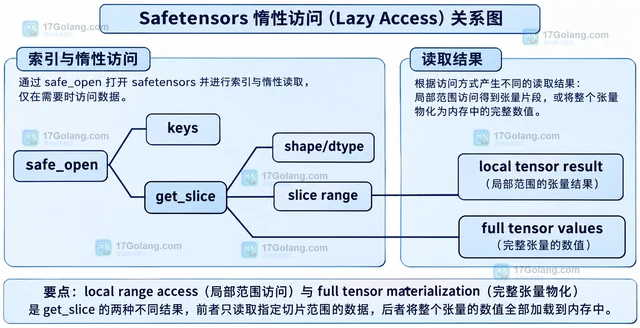
用 safe_open 读取 Safetensors 的张量名、dtype、shape 和文件 metadata,并用 get_slice 按需访问局部数据,避免查看模型结构时加载全部权重。
-
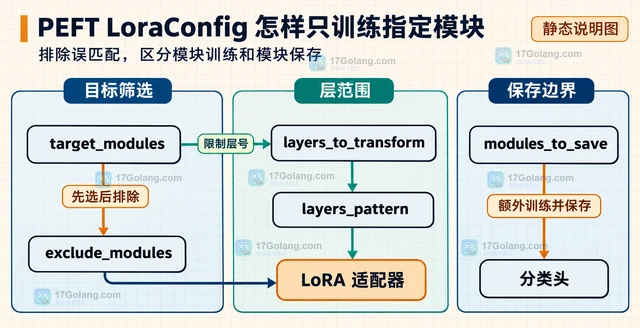
PEFT 的 LoraConfig 怎样只训练指定模块?本文围绕 target_modules 的列表后缀与字符串正则匹配,说明 exclude_modules、modules_to_save、all-linear 的边界,并给出按真实模块名收窄 LoRA 训练范围的 Python 示例。
-
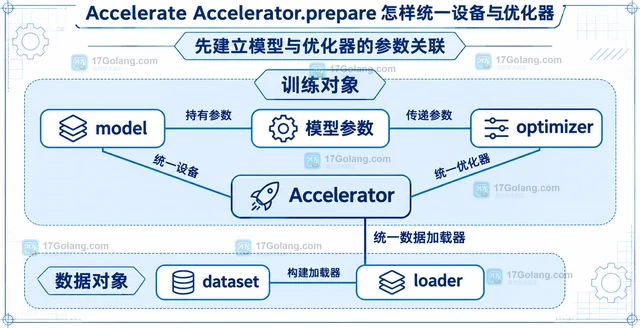
说明 Accelerate Accelerator.prepare 如何一起准备模型、优化器和数据加载器,给出普通训练循环迁移示例,澄清返回值顺序、设备放置、反向入口与分布式启动的责任。
-
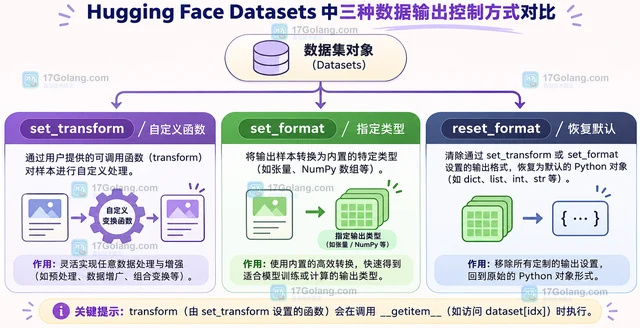
Hugging Face Datasets 的 set_transform 可以在索引或切片取样时按需生成模型输入和派生字段。本文说明 columns、output_all_columns、reset_format 与 with_transform 的边界,并给出保留原始列和生成 tokenizer 字段的原创示例。
-
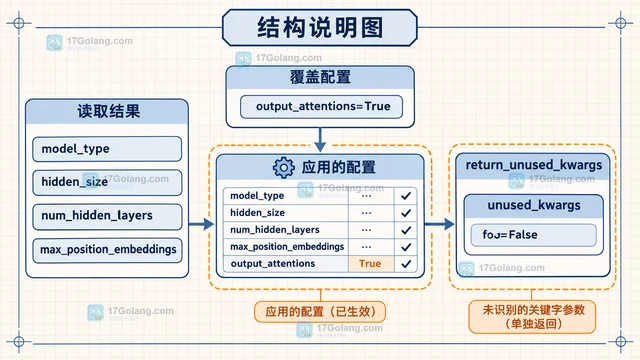
Transformers 的 AutoConfig.from_pretrained 可以在加载模型权重前读取配置对象。本文用一个窄而实用的流程说明如何查看 model_type、hidden_size、num_hidden_layers 和 max_position_embeddings,怎样覆盖配置字段,以及如何用 return_unused_kwargs 识别拼写或边界错误。
-
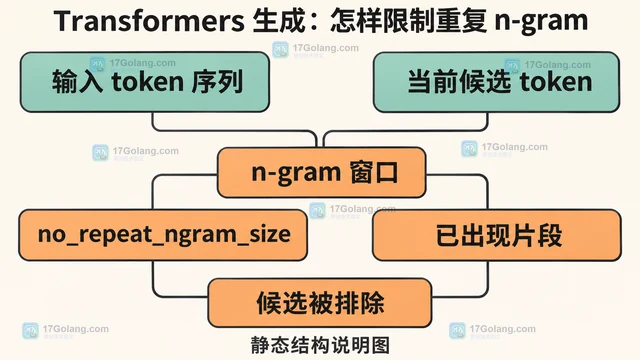
介绍 Transformers generate 中 no_repeat_ngram_size 的工作边界、最小配置和取值思路,解释 token 级 n-gram 约束与 repetition_penalty 的区别,并给出短文本、术语密集文本和 encoder-decoder 场景的落地清单。
-
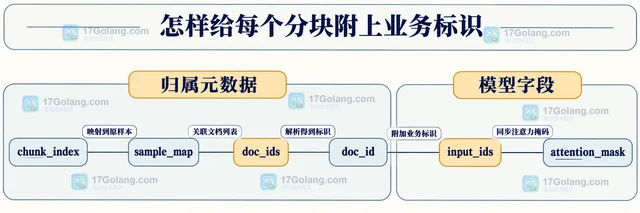
说明 Transformers BatchEncoding 的 overflow_to_sample_mapping 如何关联分块与原批样本,给出 truncation、stride 和业务文档 ID 的处理示例,并澄清分块编号与样本下标的区别。
-
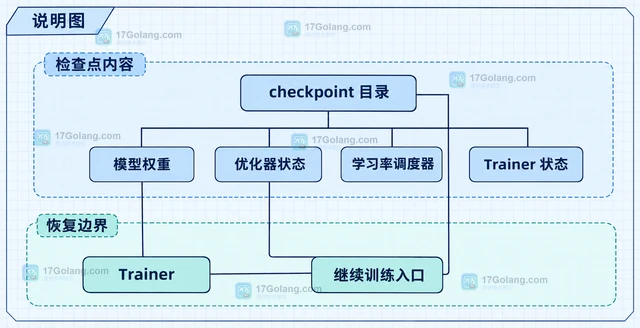
Transformers Trainer 继续训练时,不能只加载模型权重,而要把完整 checkpoint 交给 train(resume_from_checkpoint=...)。本文说明优化器、调度器、global_step、检查点目录和 ignore_data_skip 的关系,并给出显式路径与自动寻找最近检查点的写法。
-
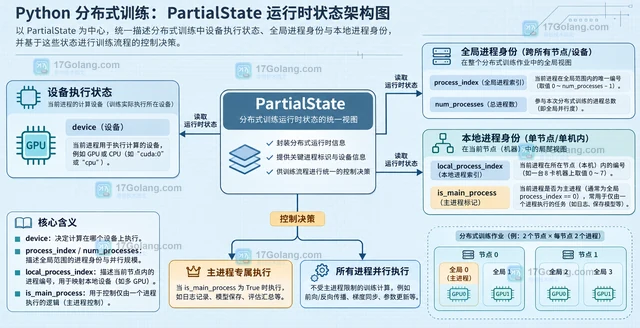
只需要读取分布式脚本的当前设备、全局进程编号、本机进程编号和进程总数时,可以直接使用 Hugging Face Accelerate 的 PartialState。本文用一个最小示例拆开四个属性的区别,并说明主进程输出与多机逻辑的写法。
-
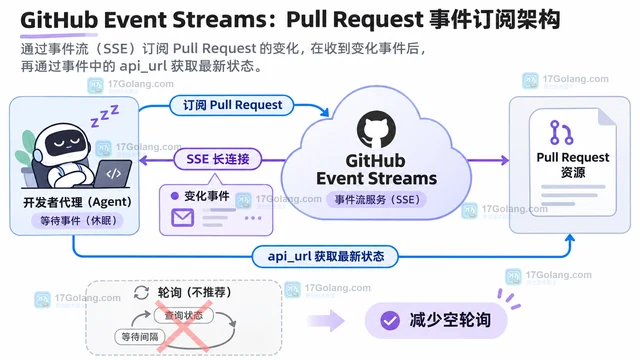
GitHub Event Streams 进入预览后,代理可以订阅 Pull Request 并通过 SSE 接收变化,再按 api_url 拉取最新状态。本文梳理接入顺序、事件边界、waitlist、令牌、过期、断线与重复乱序限制,帮助团队判断是否适合试用。
