
Go语言技术文章
-
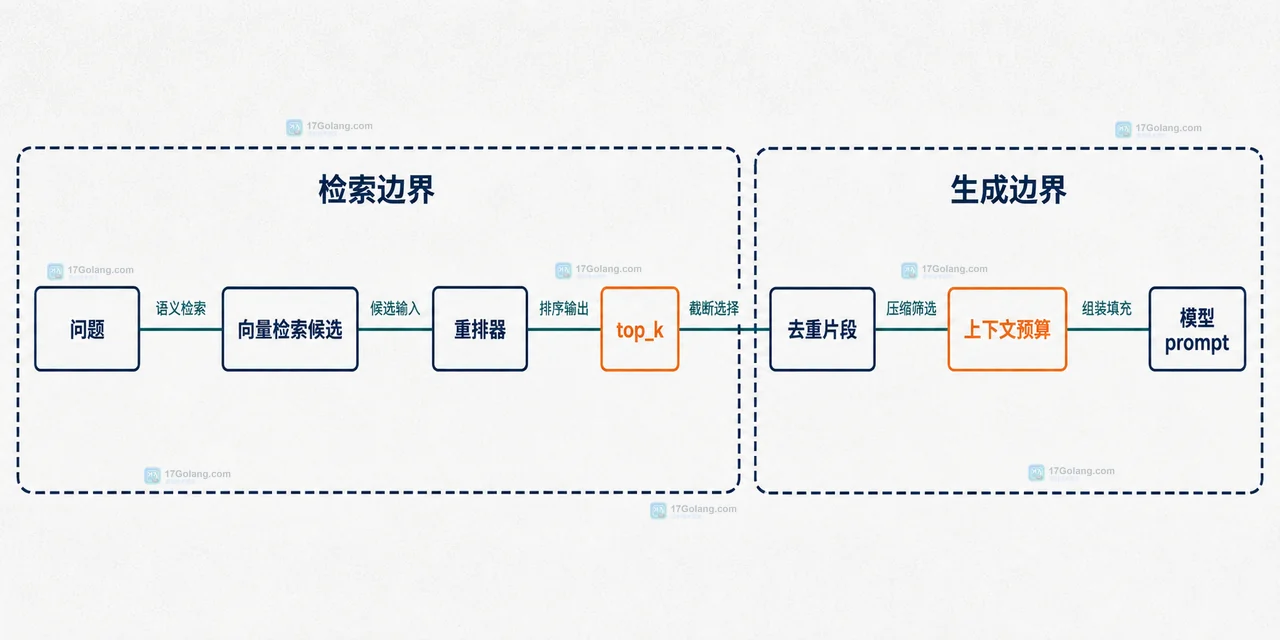 RAG 文档切片太大或重叠过高,都会让召回上下文变长并拖慢回答。本文按 chunk size、overlap、top_k 和上下文预算拆开排查,用固定问题集找到兼顾证据完整性与延迟的参数组合。277 收藏
-
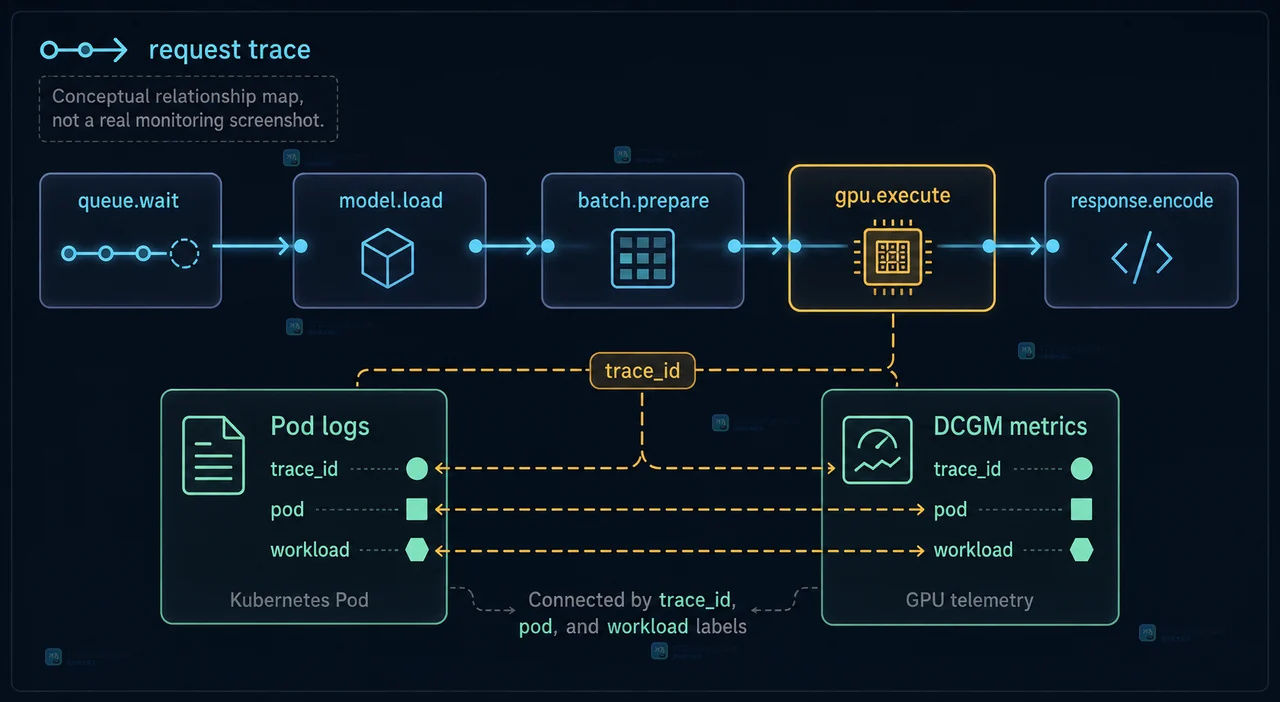 GPU 集群扩展后,单看显卡利用率很难解释任务变慢。本文按设备、工作负载和请求链路三层设计可观测性,并给出指标、Trace、告警与回滚检查清单。356 收藏
-
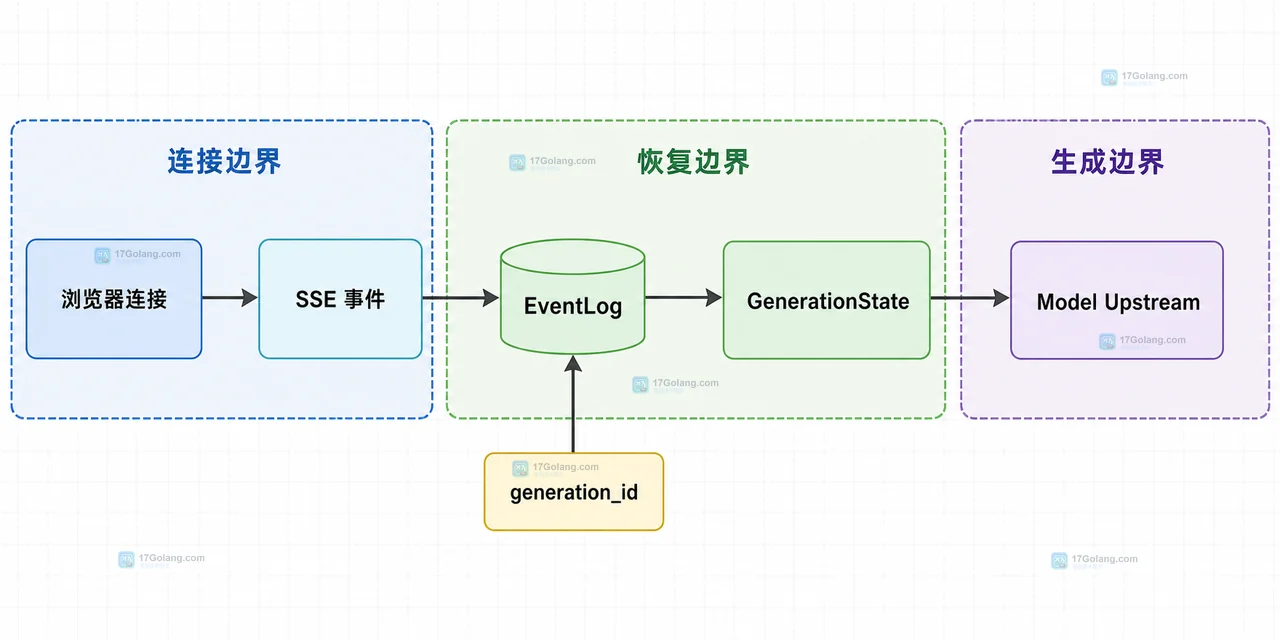 LLM 流式输出不能只把增量文本放在浏览器内存里。本文用 generation_id、递增序号和持久化事件日志保存检查点,说明断线后如何回放缺失事件、避免重复写入,并区分传输恢复与模型重新生成。177 收藏
-
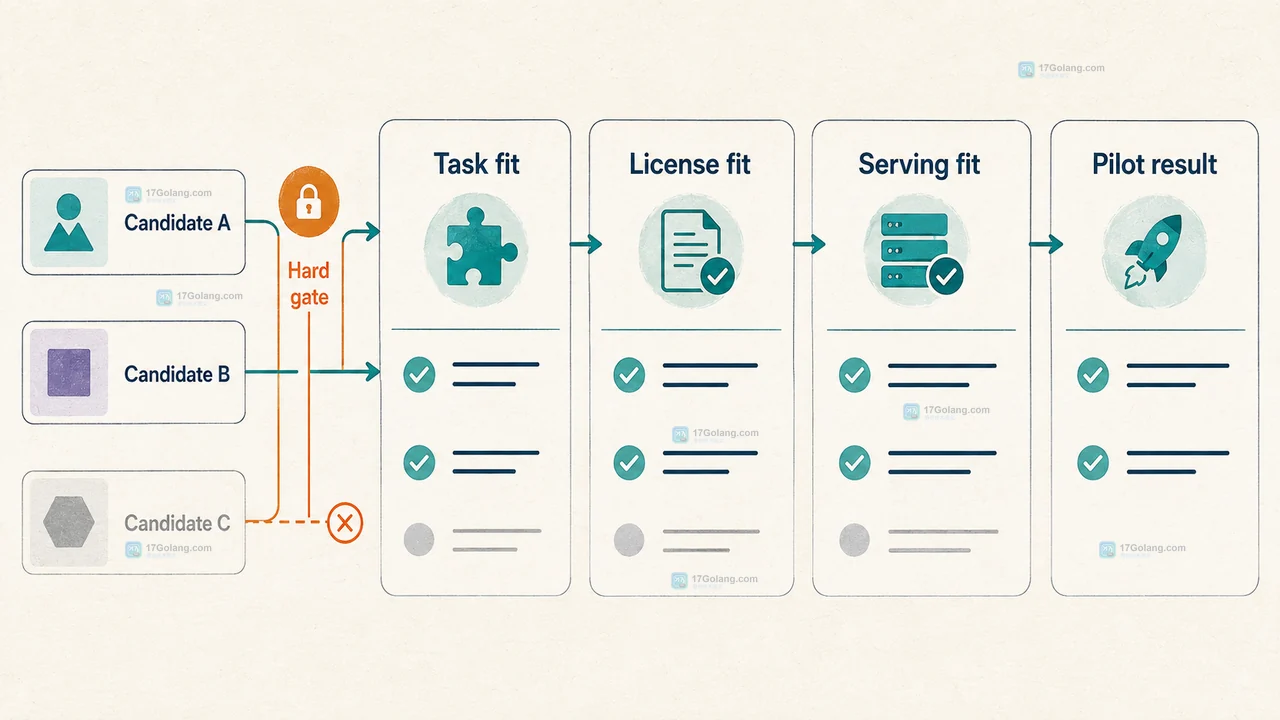 开源 AI 模型榜单适合做候选池,不适合直接决定生产模型。本文用一个轻量评分卡拆开任务集、人工偏好、许可证和真实推理成本,给出可复核的选型步骤。116 收藏
-
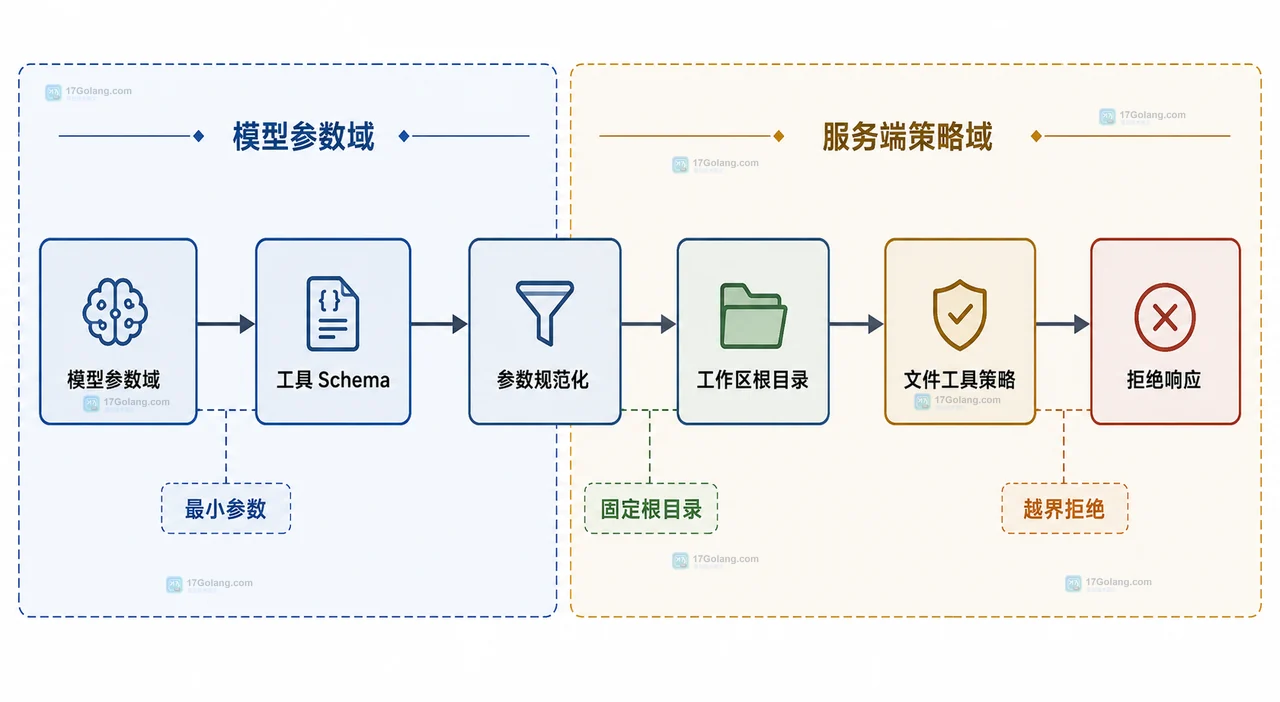 通过最小化工具参数、固定工作区根目录、规范化路径和区分读写审批,限制 AI Agent 越权访问文件,并用结构化拒绝结果和日志保留可追踪性。261 收藏
-
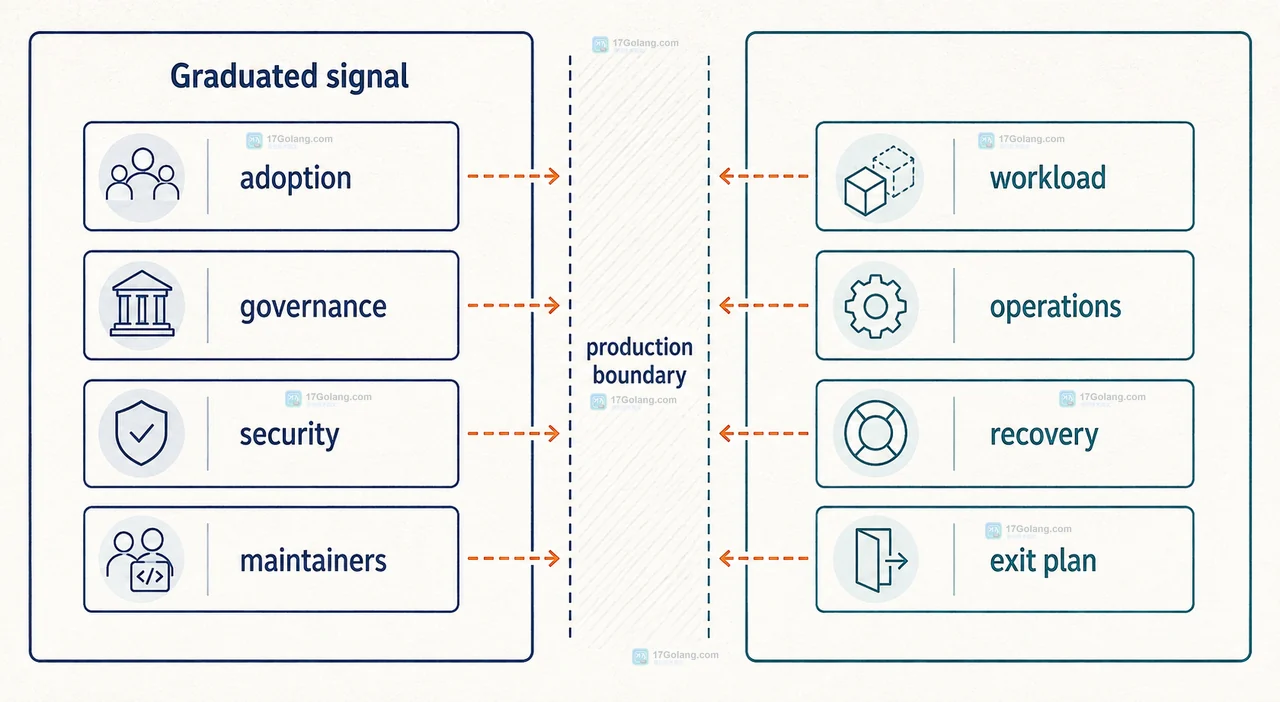 CNCF 项目毕业说明它在稳定性、社区治理、安全实践和生产采用证据方面达到更高成熟度,但不等于适配所有企业场景。本文从毕业信号、采用者证据、容量安全验证、灰度和退出成本五个方面整理生产采用判断清单。113 收藏
-
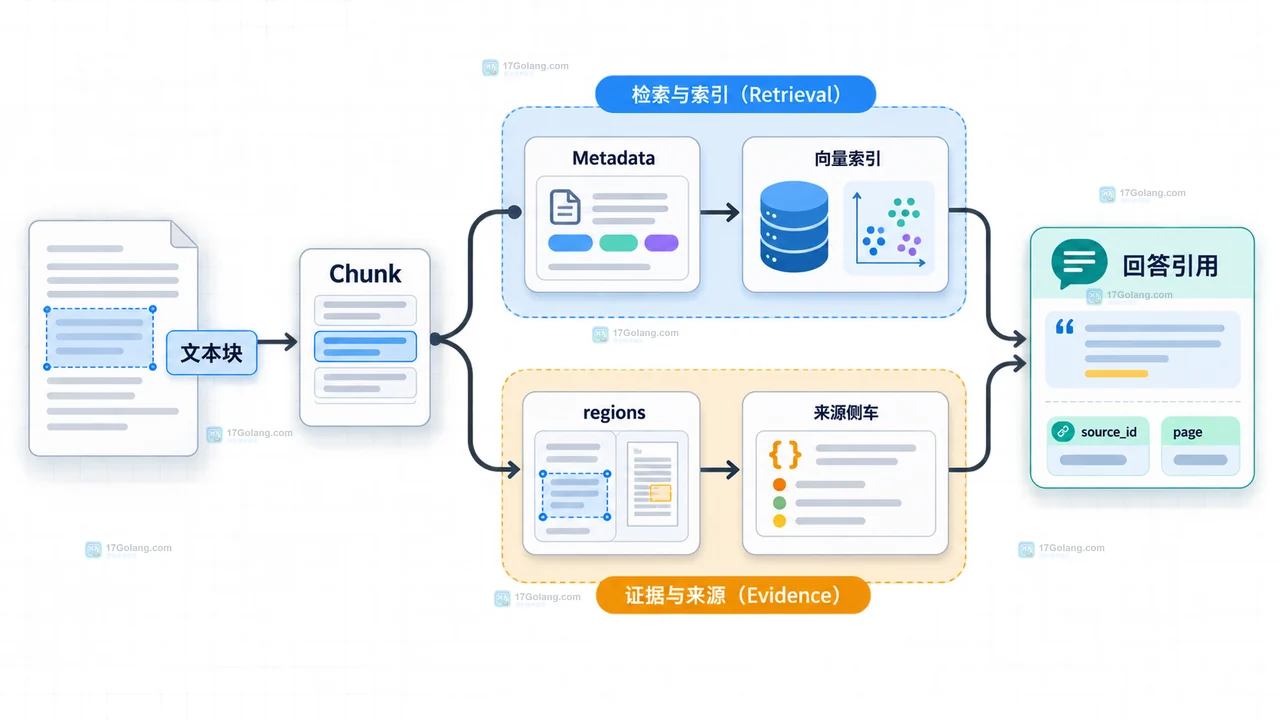 OCR 结果进入 RAG 前不要只保留拼接文本。本文用统一文本块保存 source_id、页码、版面多边形和字符范围,并说明切块、向量召回与回答引用如何保持同一条证据链。233 收藏
-
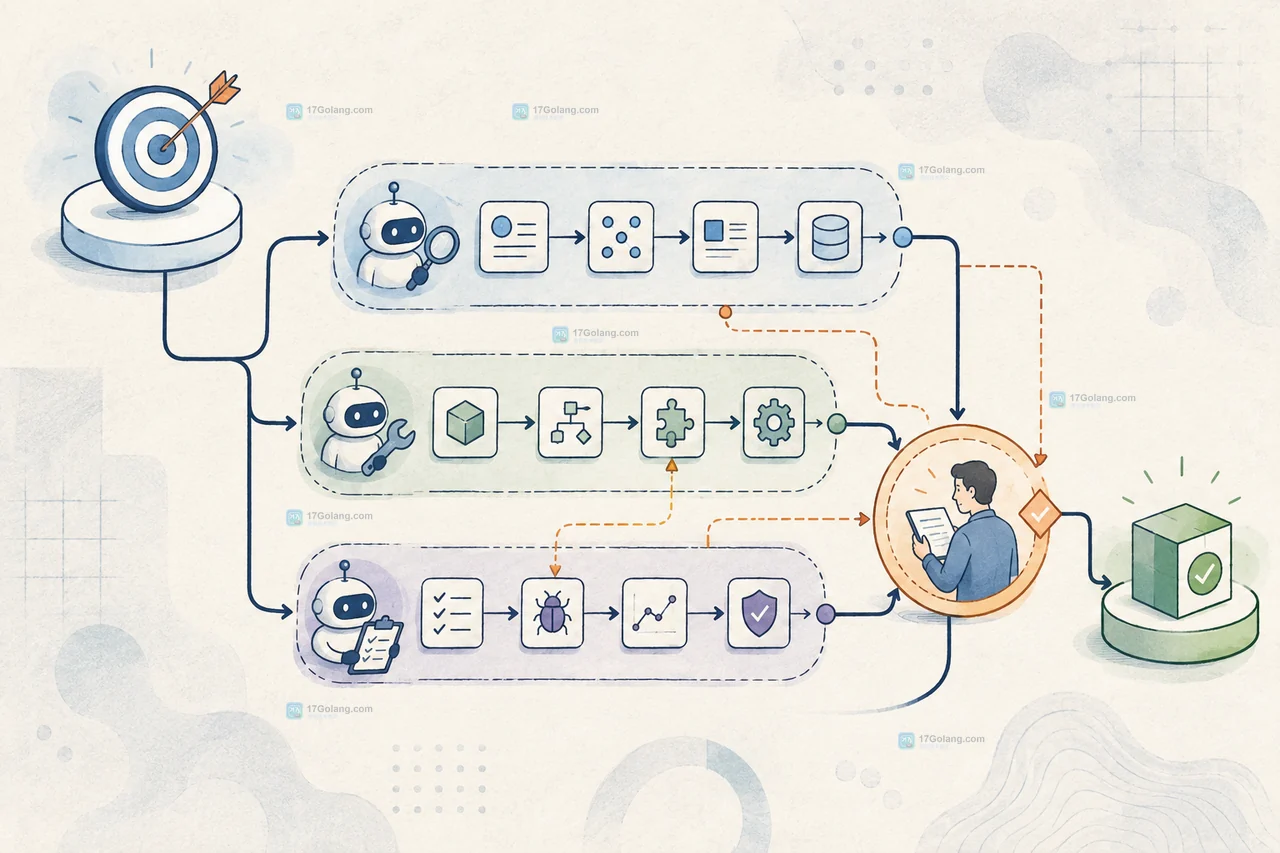 OpenAI 近期公开的代理工作研究显示,工程团队正在从短对话转向长任务、并行代理和人工监督。真正值得借鉴的不是盲目放权,而是把任务拆成有依赖、有验收条件、可复盘的工作单元。478 收藏
-
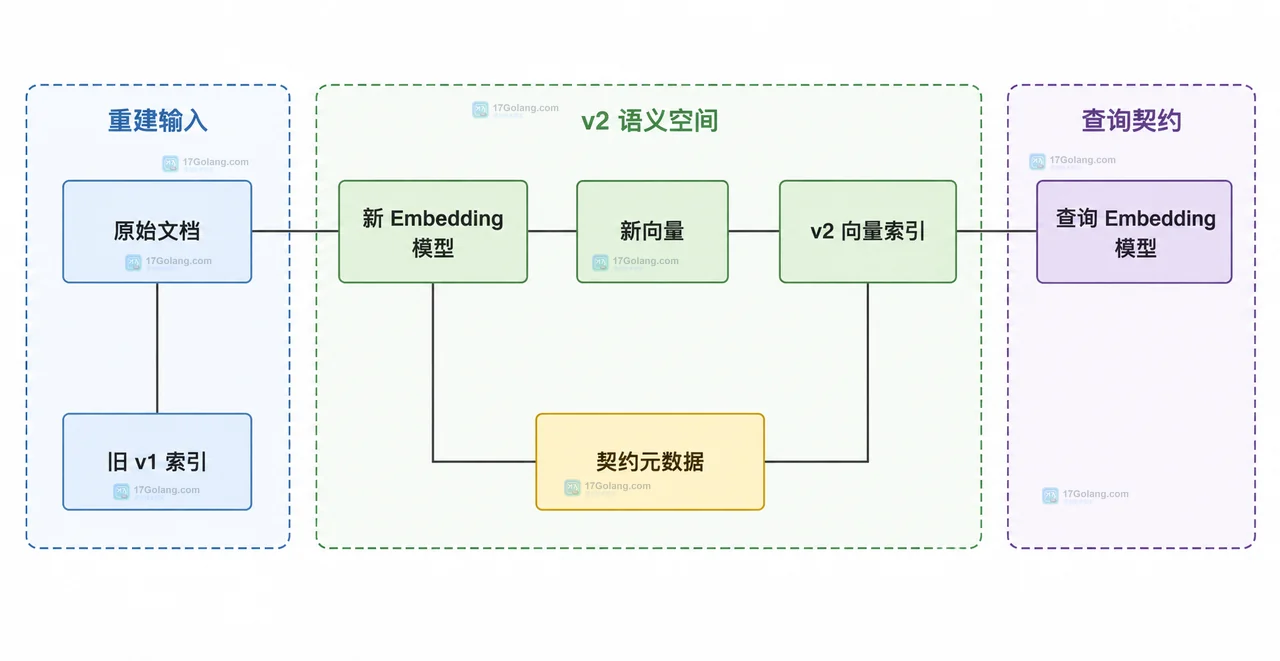 Embedding 模型切换时,旧向量不能只看维度是否相同。本文从维度、语义空间和索引元数据三个层面说明混用风险,并给出重嵌入、建新索引和灰度切换的迁移做法。473 收藏
-
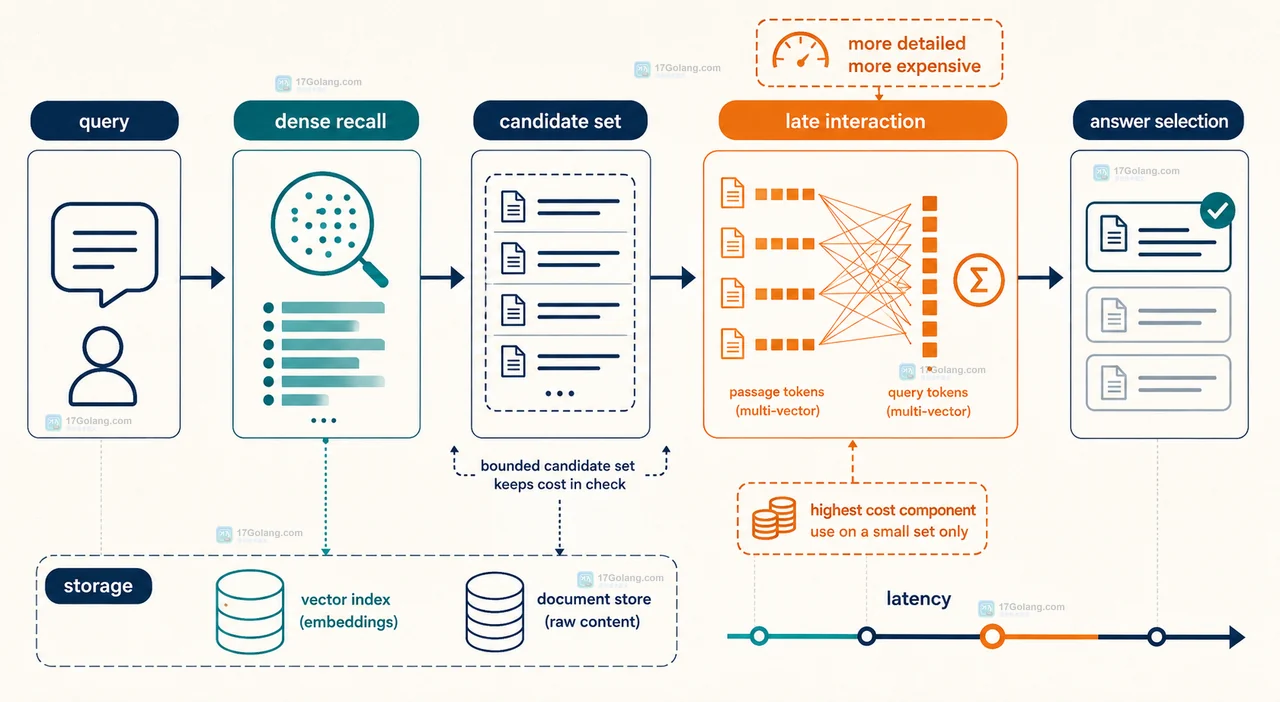 Hugging Face 生态通过 Sentence Transformers MultiVectorEncoder 降低了多向量检索的使用门槛,但 token 级索引会带来更高的存储与重排成本。本文比较稠密召回、多向量重排和全库多向量方案,给出训练与上线检查清单。461 收藏
-
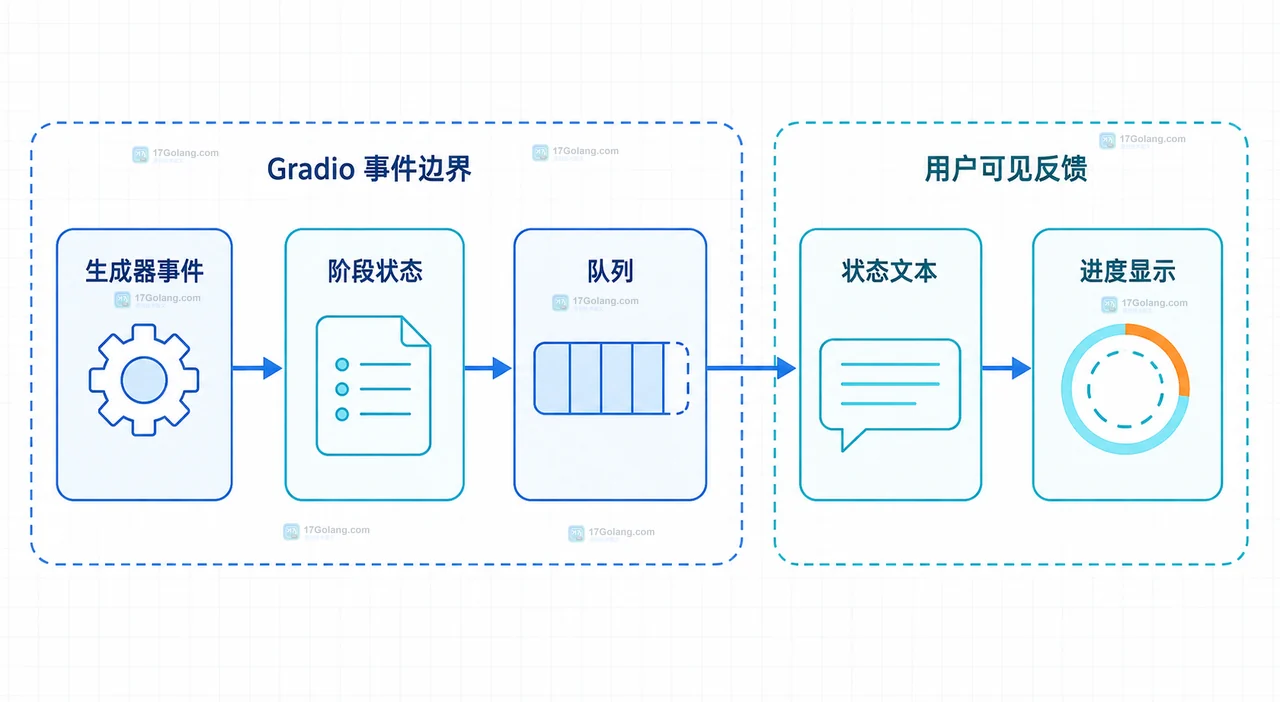 Gradio 长任务不要只等函数返回:用生成器 yield 阶段状态,用 gr.Progress 显示进度,再用 cancels 连接停止按钮,同时明确 UI 取消与外部作业停止的边界。197 收藏
-
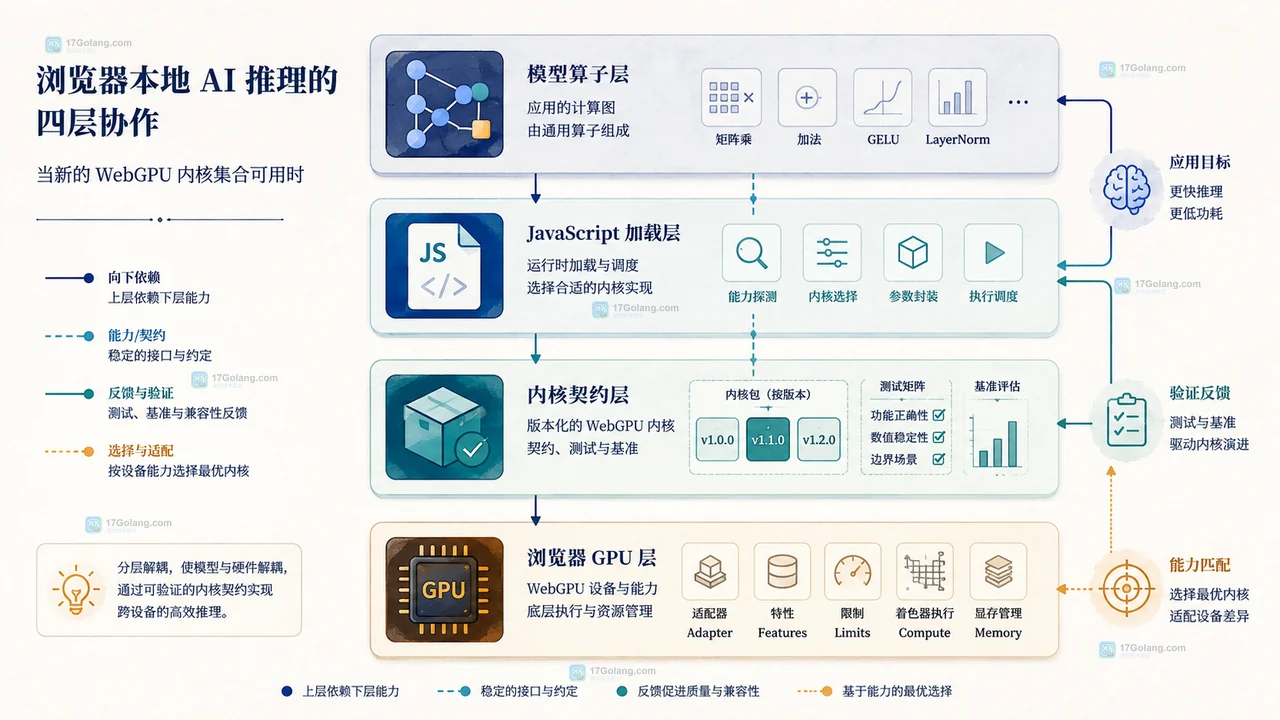 Hugging Face 新增 WebGPU kernels 后,浏览器本地推理不能只看算子数量或单项倍数,还要评估 WebGPU 平台、kernel 契约、完整链路性能与回退策略。161 收藏
-
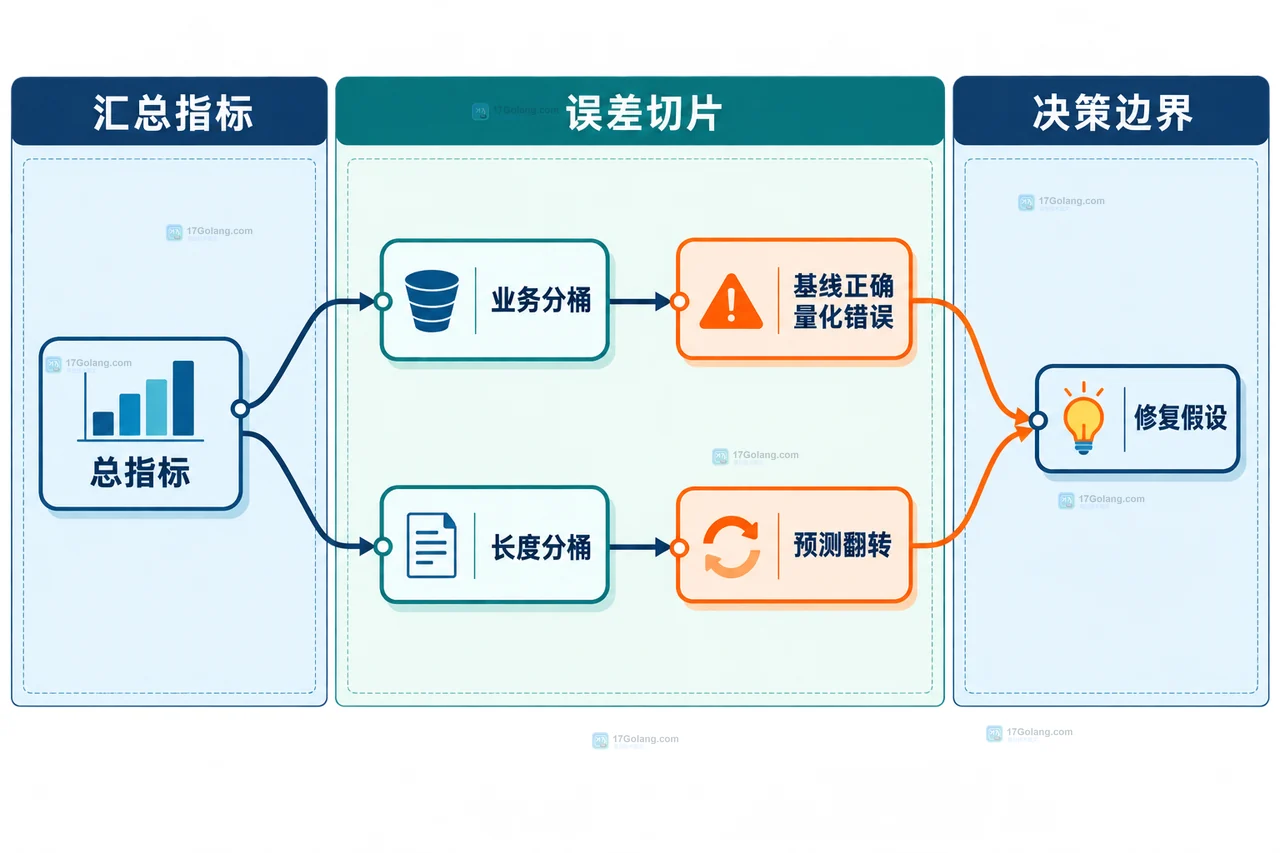 量化模型精度下降时,不要只看一个总分。本文用固定输入、配对预测和分桶误差,区分评测条件不一致、长输入敏感与校准集覆盖不足,并给出可复用的对照脚本。124 收藏
-
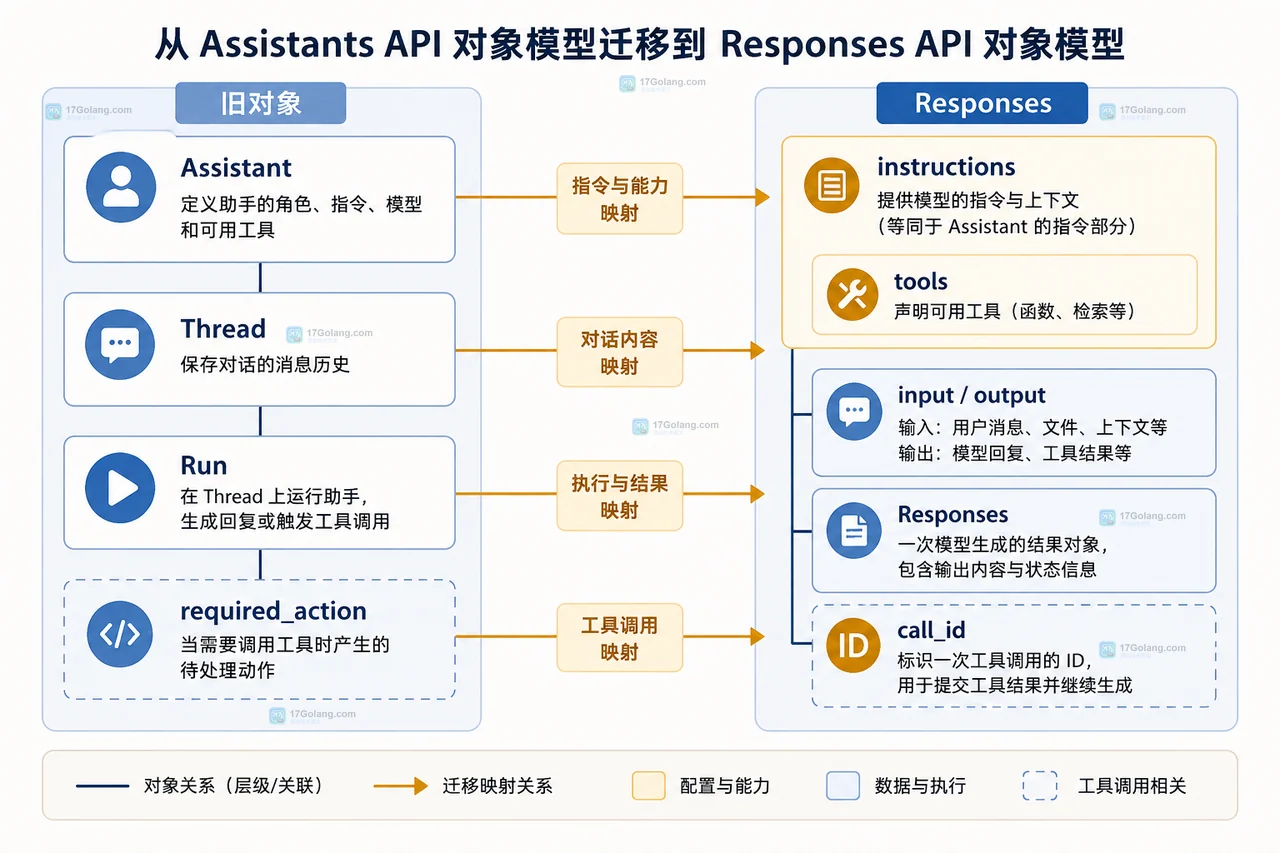 Assistants API 进入弃用后的迁移重点,不是替换一个接口地址,而是重新划分会话状态、工具调用、输出解析和数据保留边界。本文给出旧对象到 Responses API 的映射表、适配代码和可回滚灰度顺序。210 收藏
-
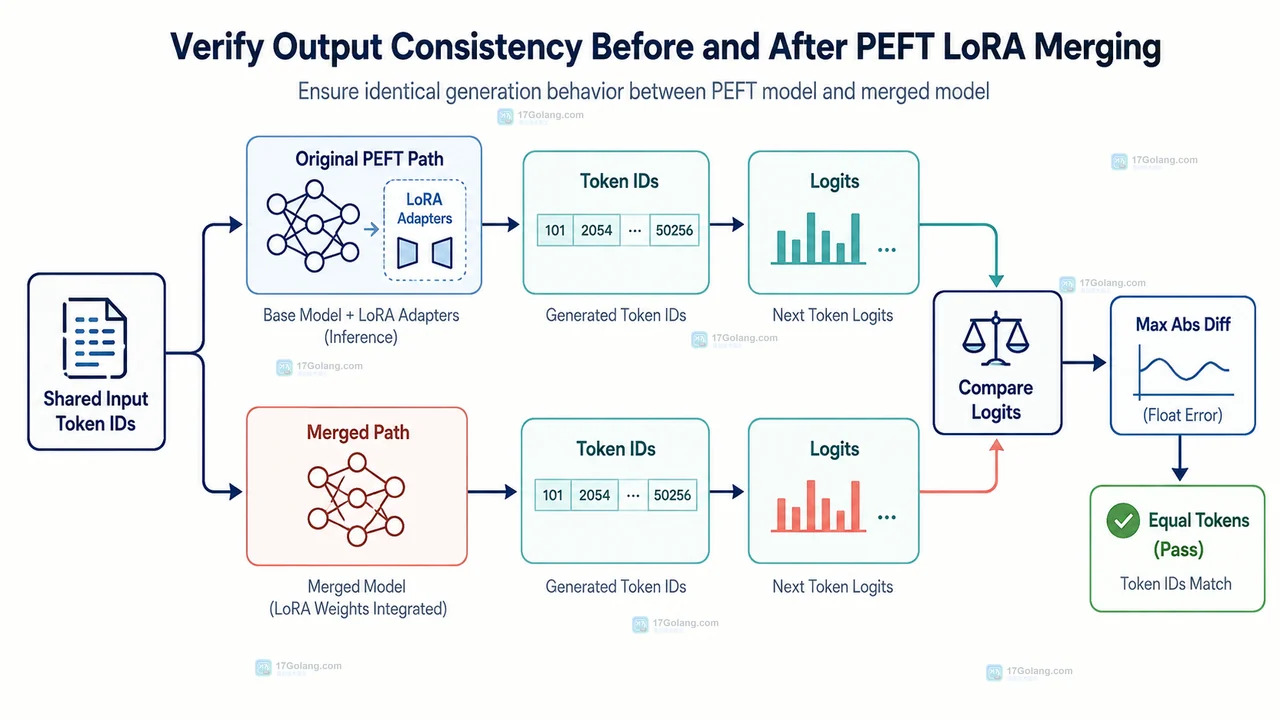 用 PEFT 的 merge_and_unload 合并 LoRA adapter,固定 tokenizer、输入和生成参数,再通过 token 与 logits 对比判断合并前后是否一致。399 收藏