
python教程技术文章
-
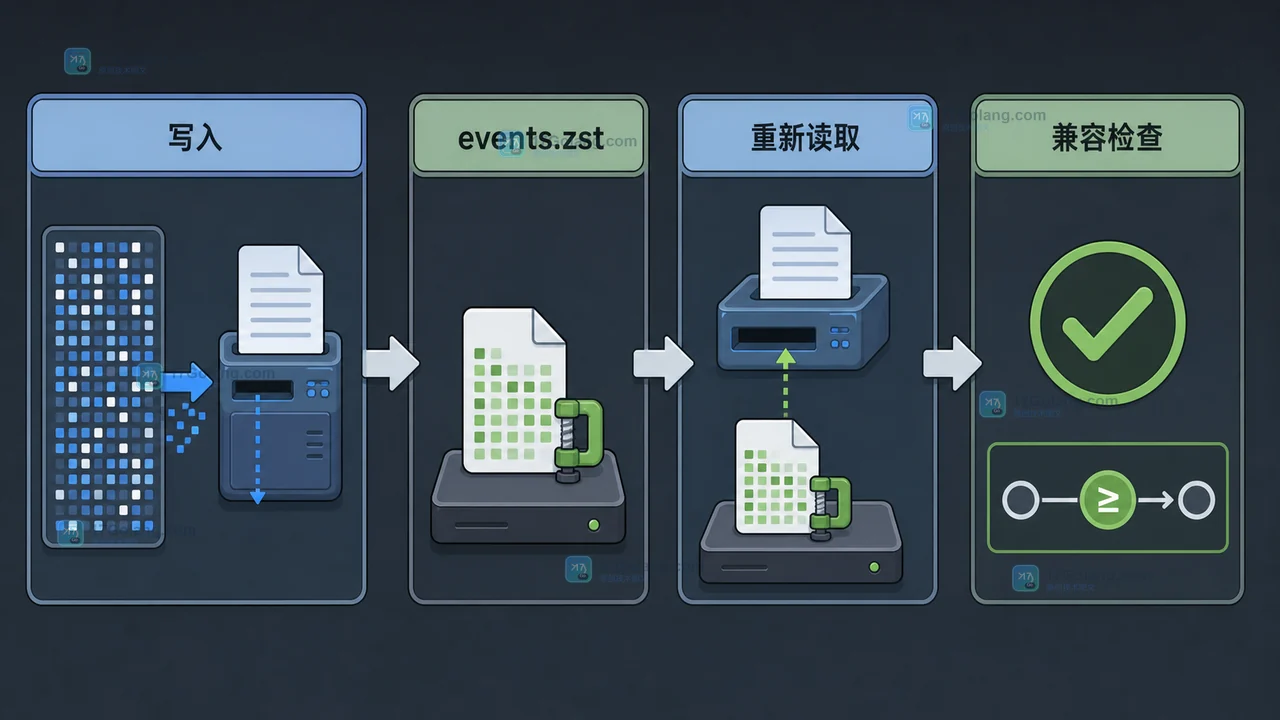 Python 3.14 把 Zstandard 支持带进标准库。本文用同一份数据对比内存压缩、文件读写和解压核对,说明压缩级别、可选模块与旧版本兼容边界。406 收藏
-
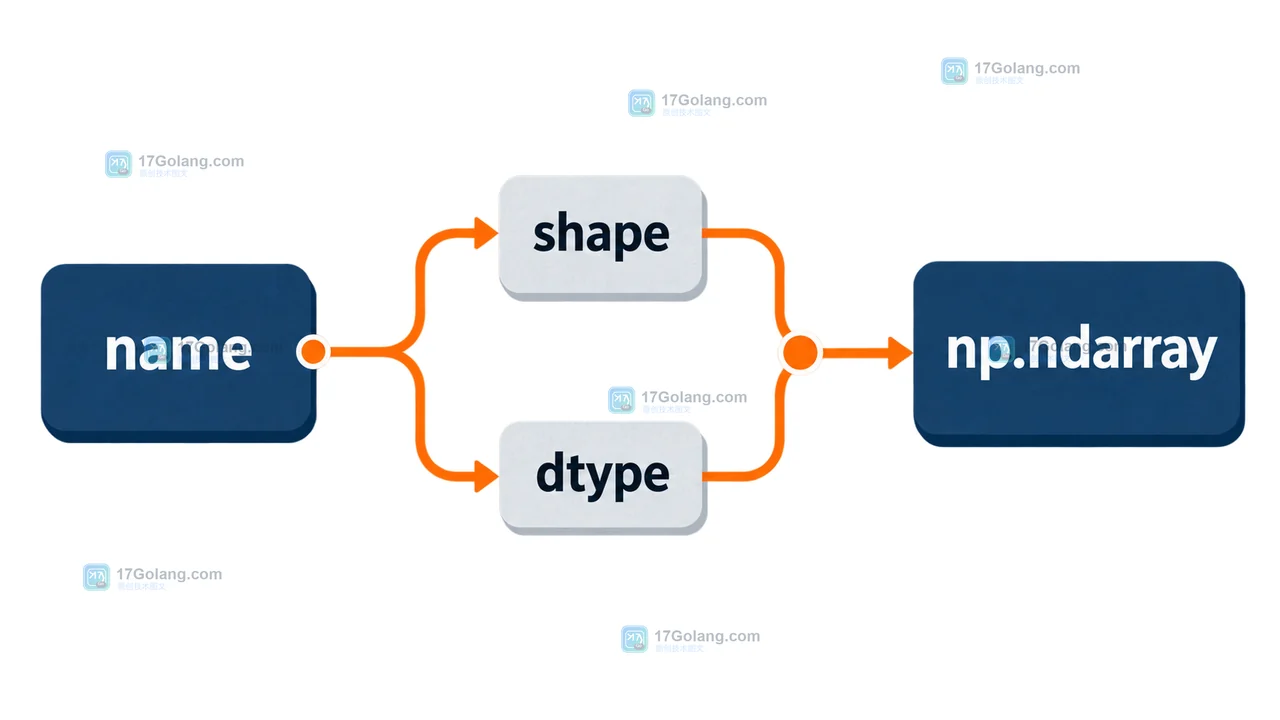 用 multiprocessing.shared_memory 让多个 Python 进程直接访问同一块缓冲区,重点处理 create、attach、close、unlink 的生命周期,以及命名冲突和释放验收。399 收藏
-
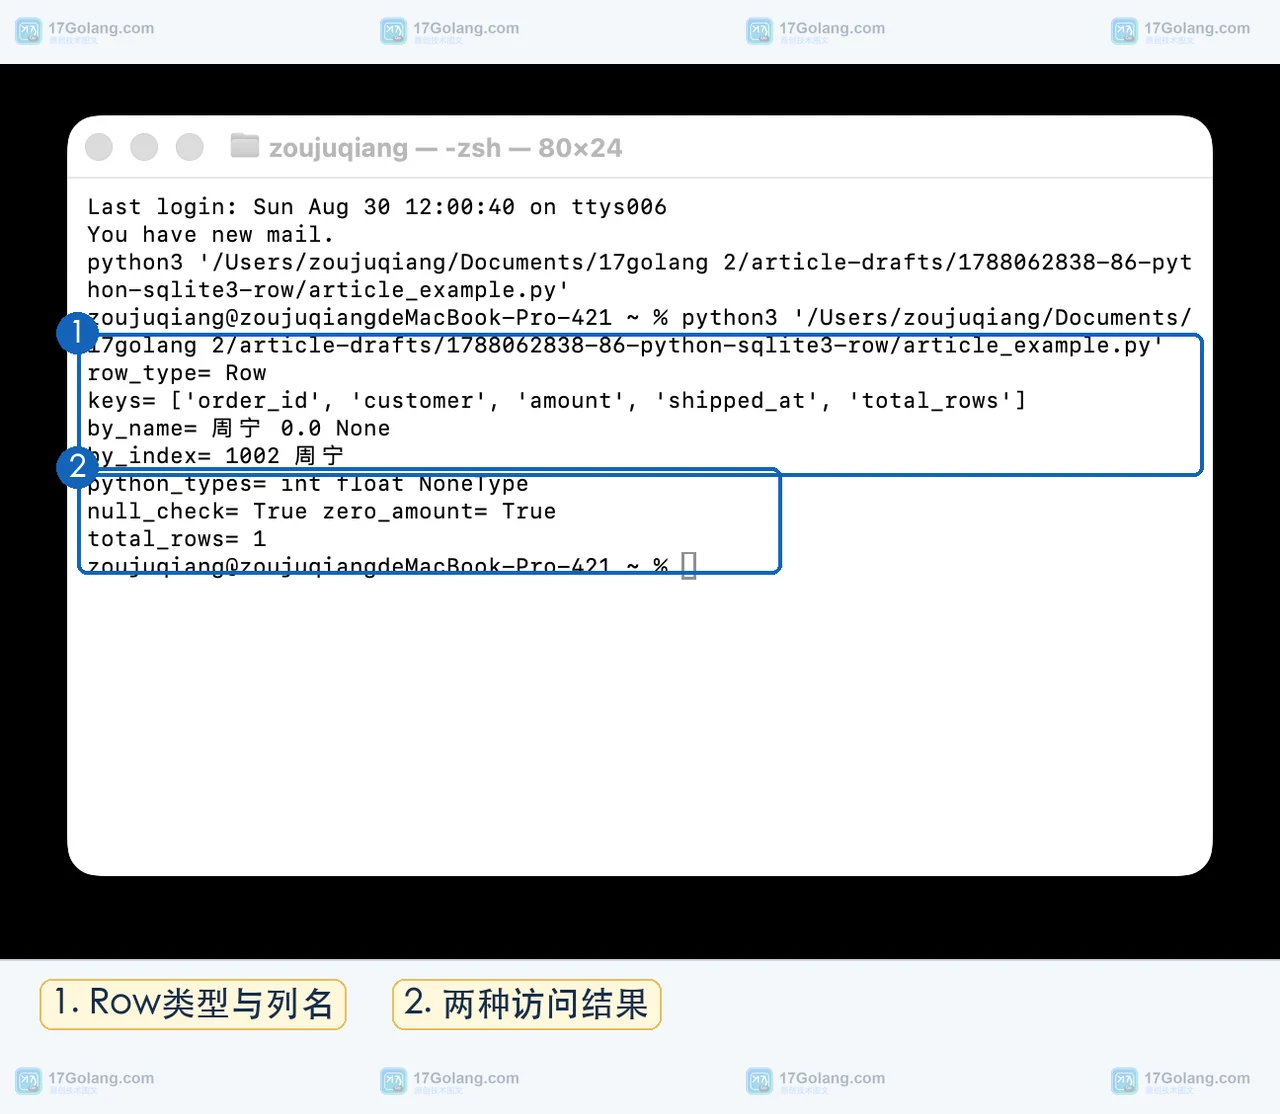 Python sqlite3.Row 能让查询结果同时支持下标和列名访问,但它不会替你完成类型转换或空值判断。本文用同一个订单查询示例核对 row_factory、带类型的列值和 NULL 字段,说明如何在读取层保留清晰的边界。399 收藏
-
 用 Python typing.TypeIs 编写类型谓词,理解真分支取交集、假分支排除目标类型的规则,并判断哪些列表场景仍应保留 TypeGuard。396 收藏
-
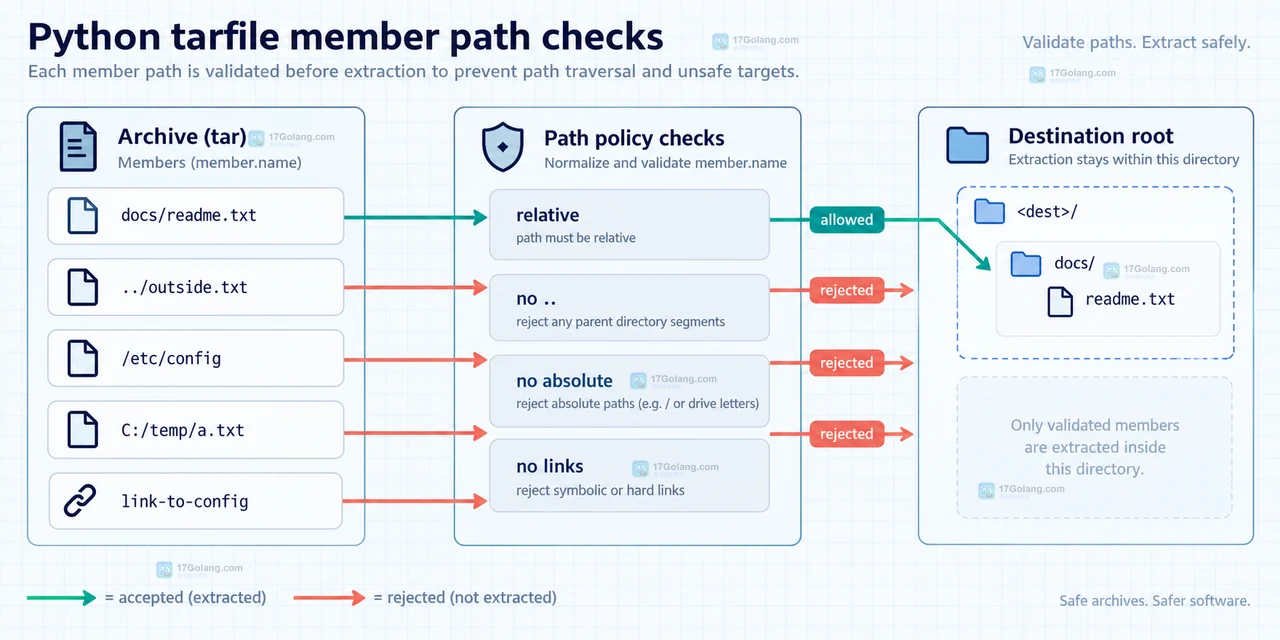 讲清 Python tarfile 解压前如何检查成员路径,拒绝绝对路径、..、盘符路径和链接,并用 filter=data 与临时目录降低越界写入风险。394 收藏
-
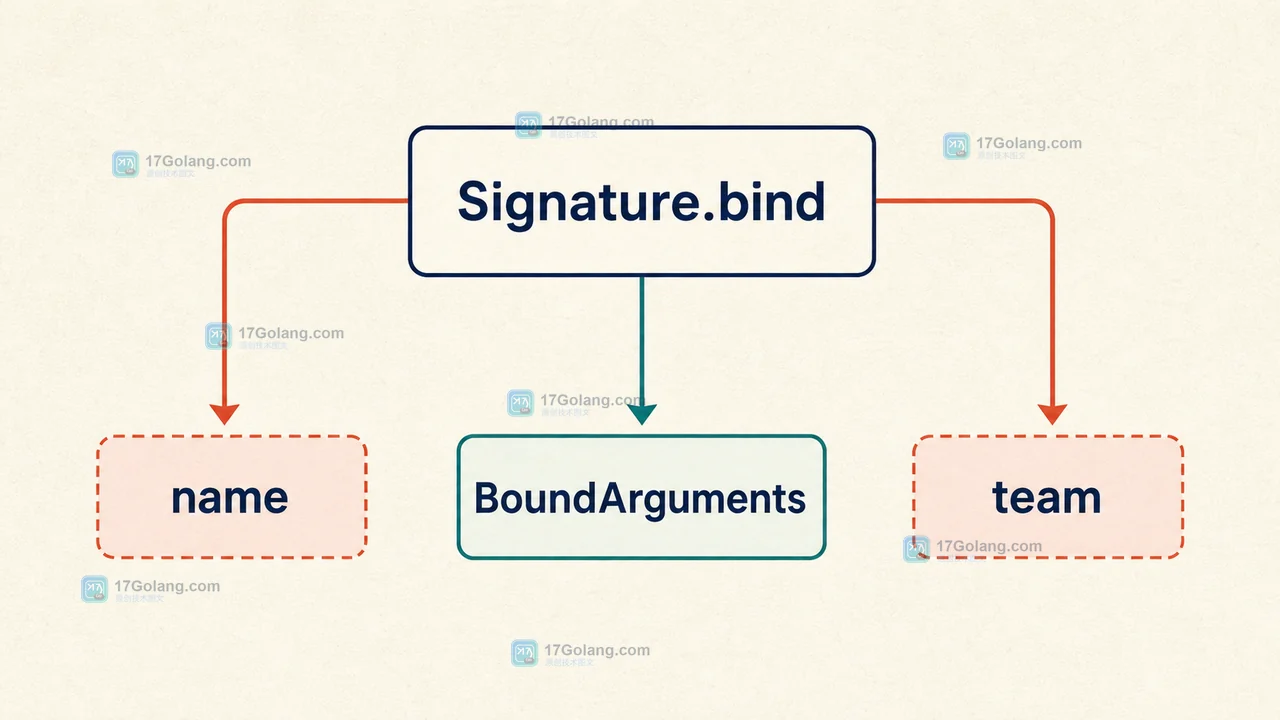 当函数参数来自字典或配置时,inspect.Signature.bind 可以在真正调用前完成参数绑定并把错误收敛为 TypeError。本文从一个小型回调分发器出发,演示 Signature.bind、BoundArguments 和 apply_defaults 的边界。393 收藏
-
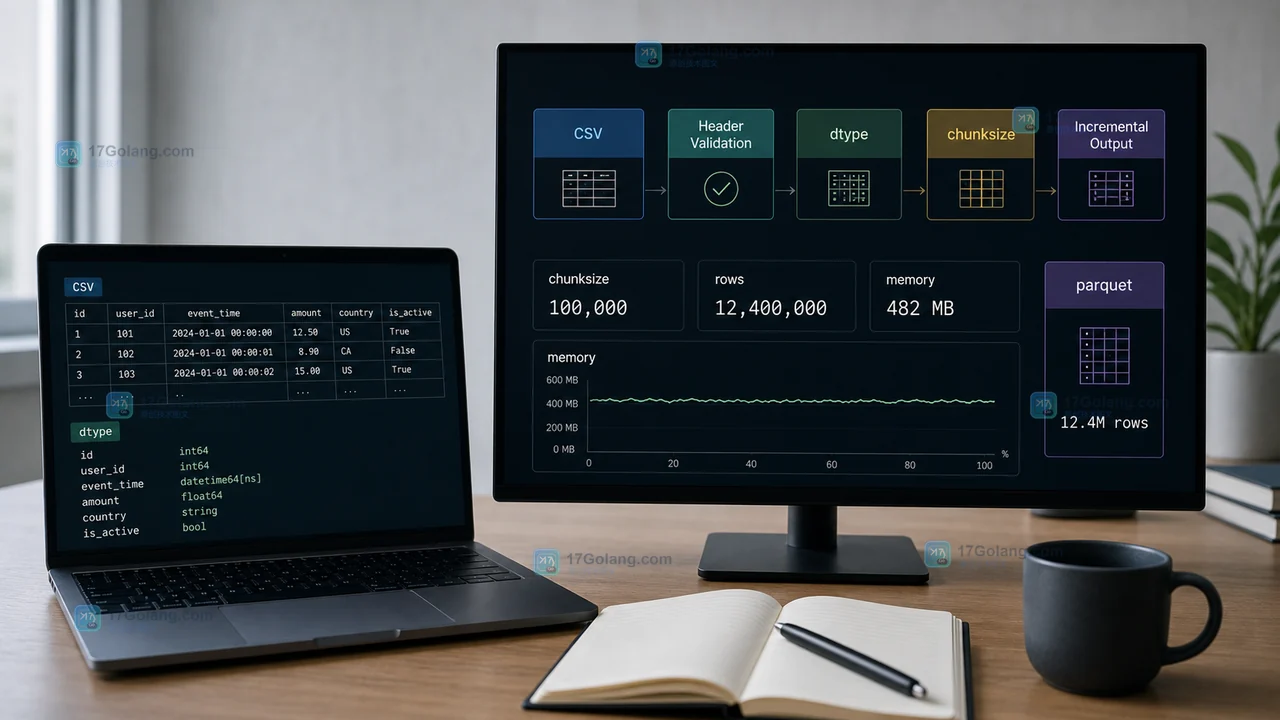 读取几 GB 的 CSV 时,真正容易把内存推高的往往不是分块大小,而是类型推断、字符串列和失败行处理。本文用 pandas 分块读取与 Python 原生迭代两条路径,说明如何设定 dtype、逐块校验、隔离坏行并用峰值数据验收。392 收藏
-
 该语法并非类型转换(typecast),而是 ctypes 模块特有的动态类型构造:c_double * n 会生成一个长度为 n 的 C 兼容数组类型,再通过解包调用实例化——本质是类型生成而非类型转换。 该语法并非类型转换(typecast),而是 ctypes 模块特有的动态类型构造:`c_d391 收藏
-
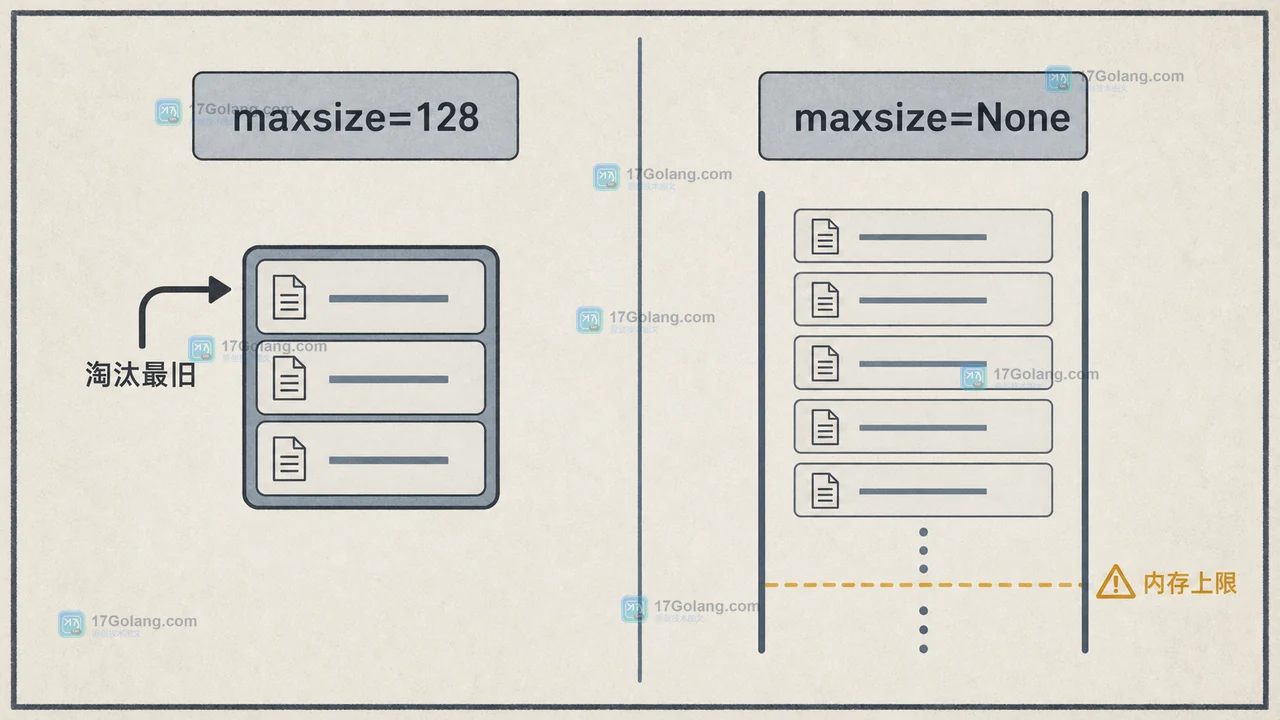 Python 的无界缓存命中率可能很好,却把不断变化的参数组合留在进程里。本文用可复现实验比较 functools.cache 与 lru_cache(maxsize=None),并给出内存上限、清理和压测验收方法。391 收藏
-
 同一个 Python logger 同时输出控制台和审计日志时,handler 级 Filter 可以返回 LogRecord 副本,只给目标 handler 增加字段,避免污染其他输出。391 收藏
-
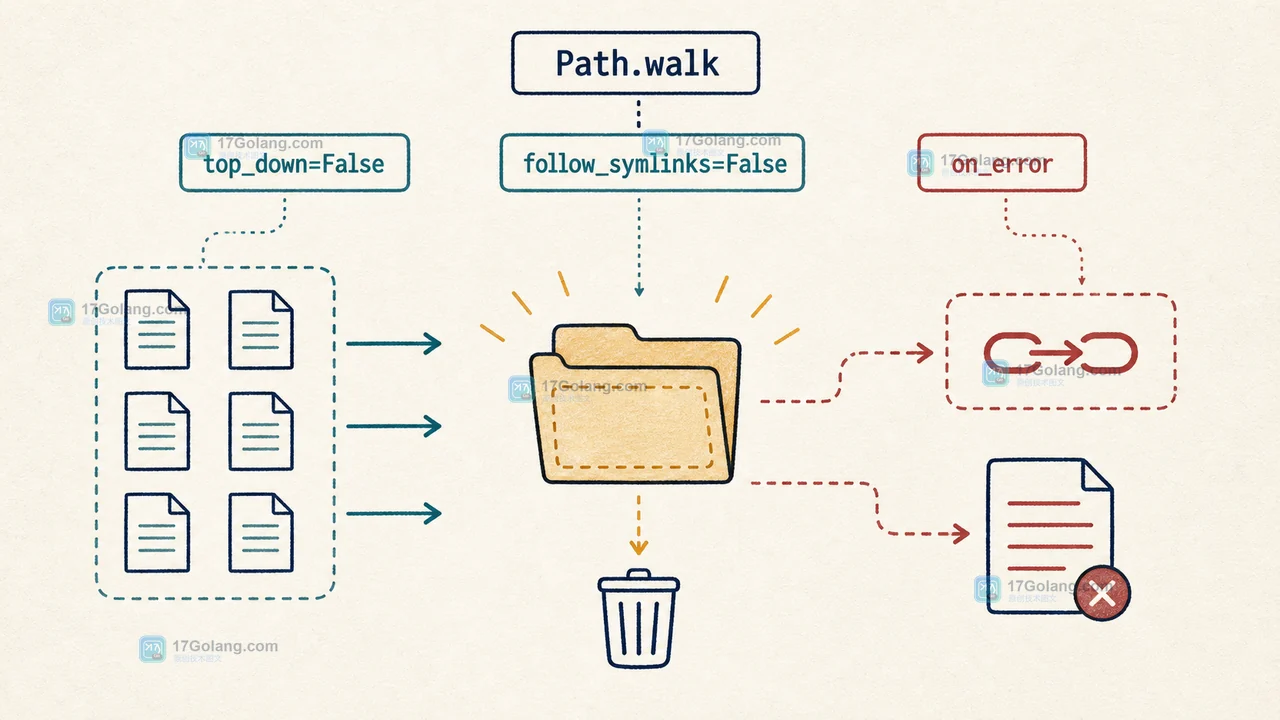 Python 3.12 引入 pathlib.Path.walk 后,可以用底层目录遍历写清理脚本,但大型目录不能只调用 rmtree。本文从 top_down、follow_symlinks、失败回调和 dry-run 记录出发,给出可复核的清理流程。388 收藏
-
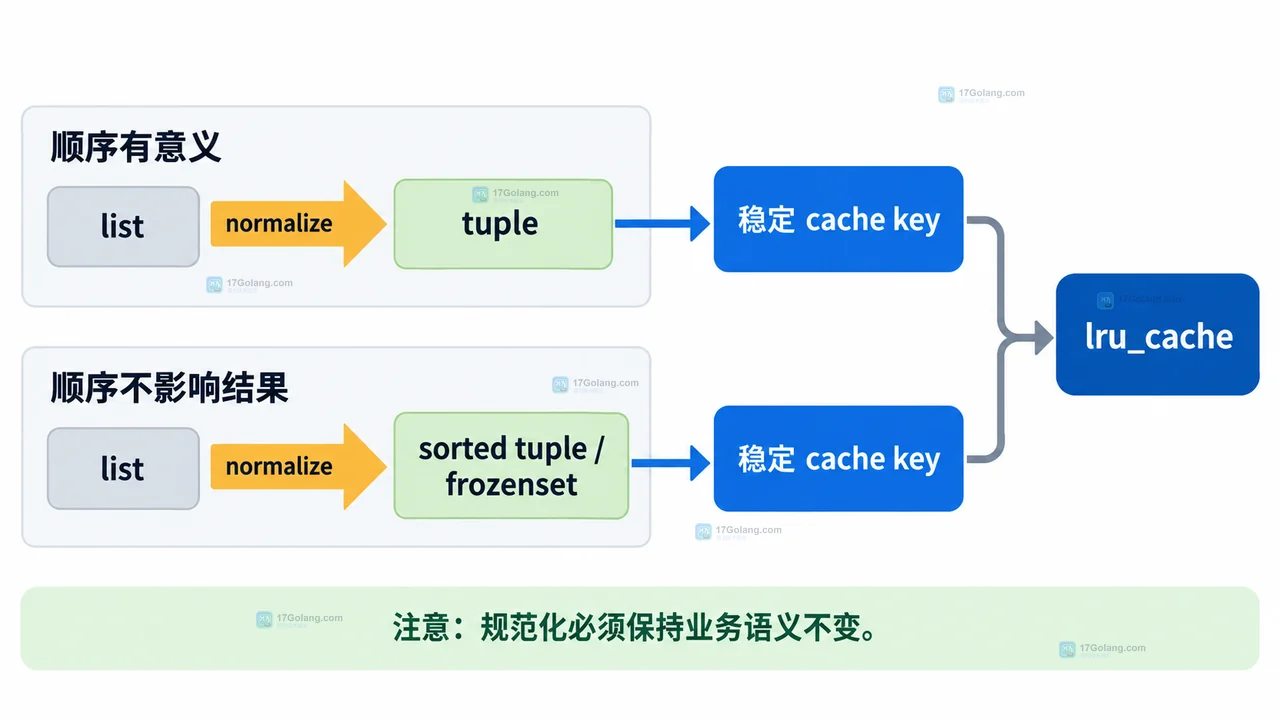 Python functools.lru_cache 报 unhashable type list 时,根因是可变参数不能参与缓存键。本文解释哈希边界,并用 tuple、排序后的 tuple、frozenset 和包装函数完成稳定缓存。388 收藏
-
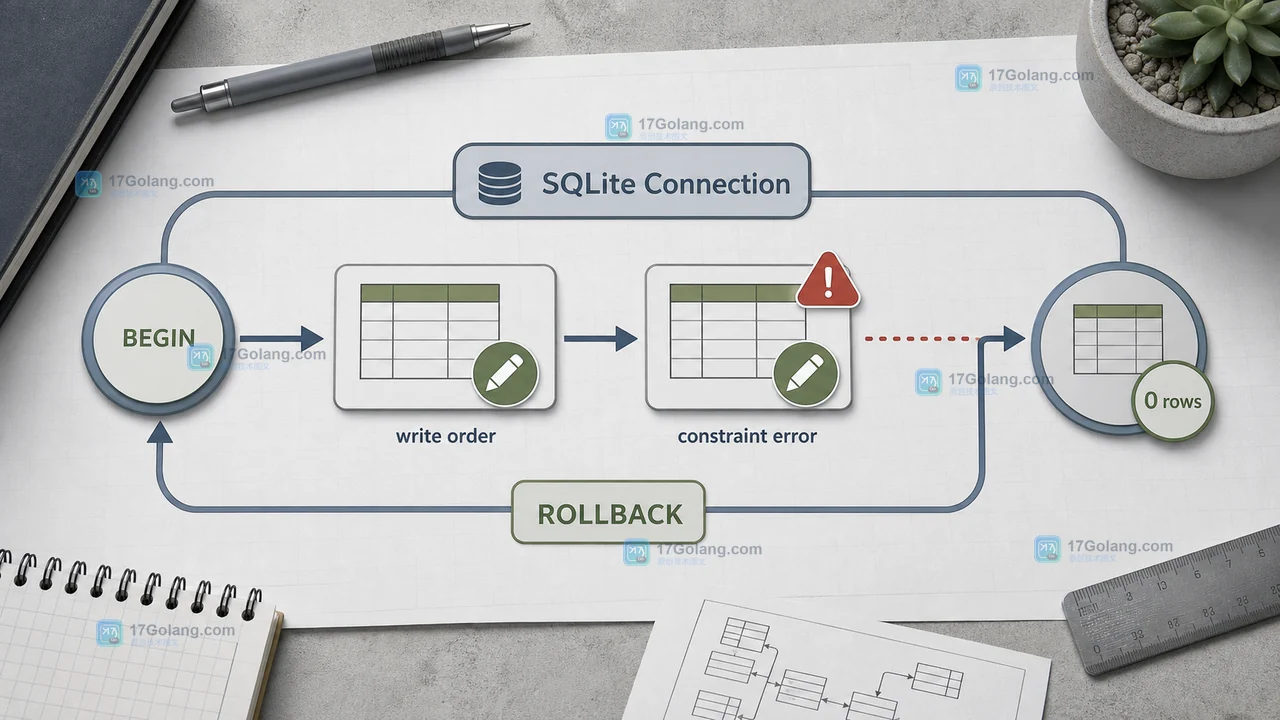 Python sqlite3 中回滚失效,常见原因不是 rollback() 写错,而是提交时机、异常捕获范围和连接边界没有对齐。本文用订单写入示例拆开事务生命周期、异常复现、上下文管理器和嵌套调用的验收方法。387 收藏
-
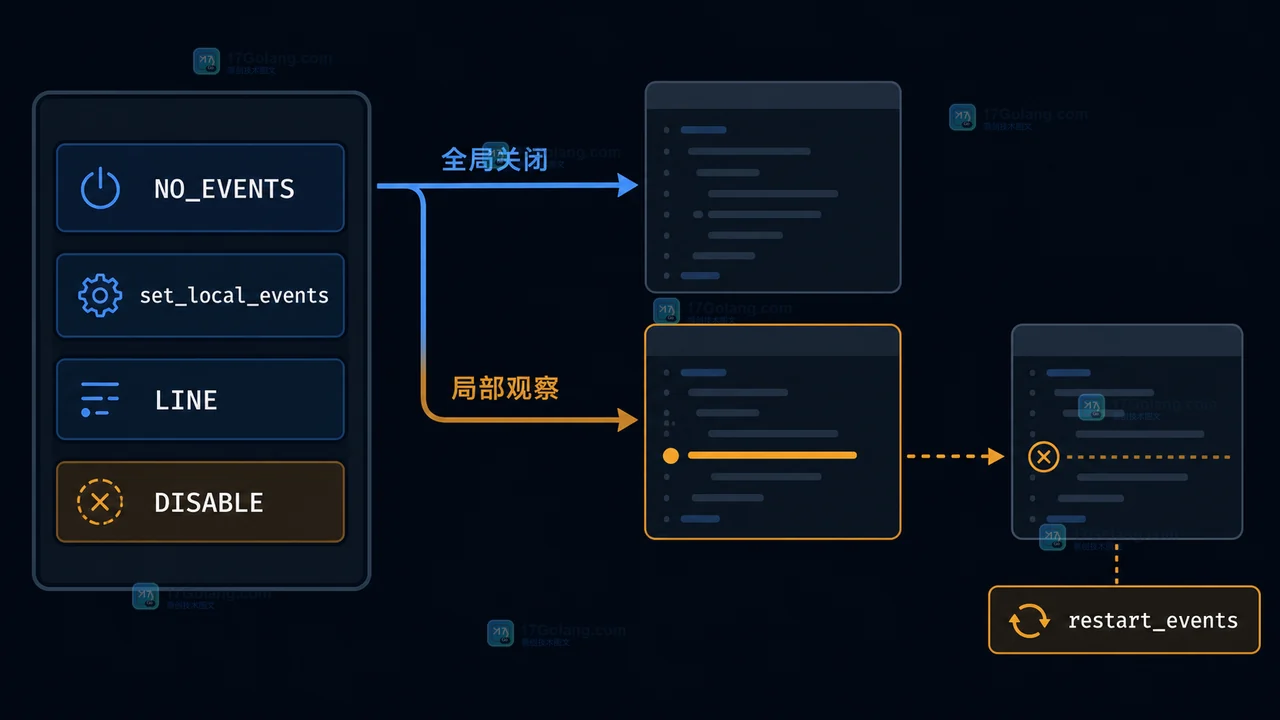 用 Python 3.12+ 的 sys.monitoring 追踪函数调用,讲清工具 ID、事件掩码、回调签名、DISABLE 优化与旧版本回退边界。386 收藏
-
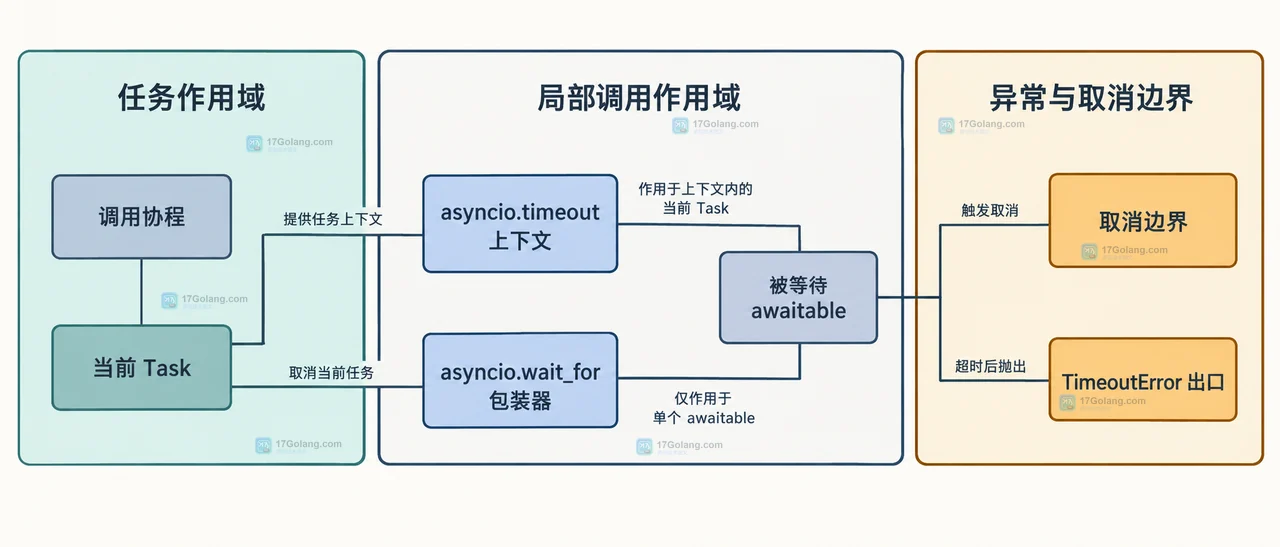 asyncio.timeout 适合给一段包含多个 await 的工作设置总预算,asyncio.wait_for 适合限制单个 awaitable。本文比较两者的保护范围、取消对象、TimeoutError 捕获位置和清理延迟,给出异步请求中的选择示例。386 收藏