
python教程技术文章
-
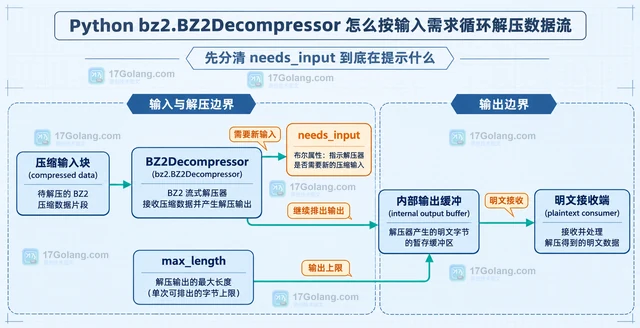 用 BZ2Decompressor 处理分块输入时,needs_input 决定是否继续取压缩数据,eof 和 unused_data 负责收束当前流。本文给出一套可复用的循环写法。250 收藏
-
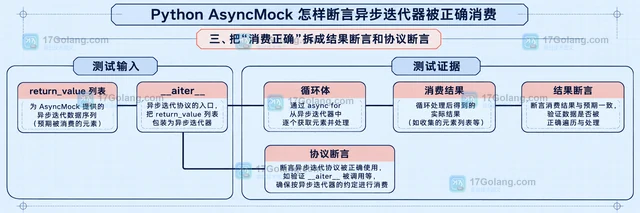 用 Python unittest.mock.AsyncMock 测试 async for 时,重点不是 assert_awaited,而是配置 __aiter__.return_value、检查消费结果,并断言异步迭代入口确实被调用。326 收藏
-
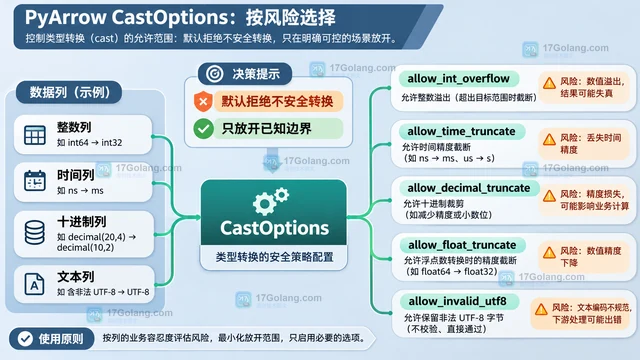 PyArrow compute.cast 默认使用安全转换,遇到整数溢出或其他不安全转换会保留错误。本文比较 safe=True、safe=False 与 CastOptions,说明如何只放开已知风险并避免把静默截断当成数据清洗。139 收藏
-
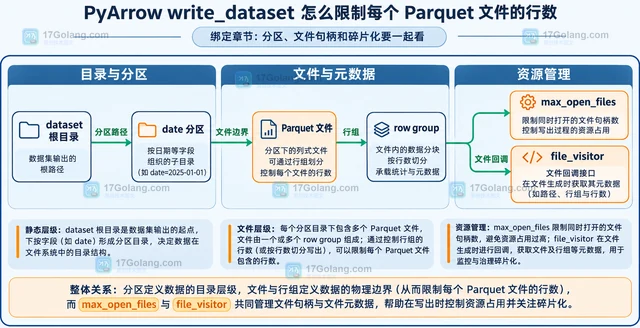 本文说明 PyArrow write_dataset 如何用 max_rows_per_file 控制单个 Parquet 文件的最大行数,并区分 max_rows_per_group、min_rows_per_group 与 max_open_files 的作用边界。444 收藏
-
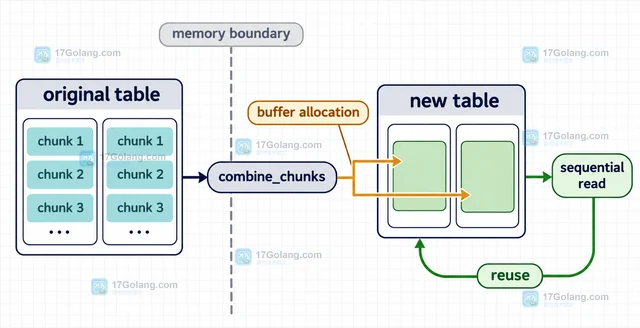 PyArrow Table 由多个分区或批次拼接后,列可能包含多个 ChunkedArray 块。本文用 combine_chunks 合并列块,并说明读取收益、内存成本与不应合并的场景。200 收藏
-
文章 · python教程 | 2天前 | 事务 · python · sqlalchemy · 数据库迁移 · sqlalchemy TEXT Alembic bindParam 参数化SQL op.get_bind 迁移脚本
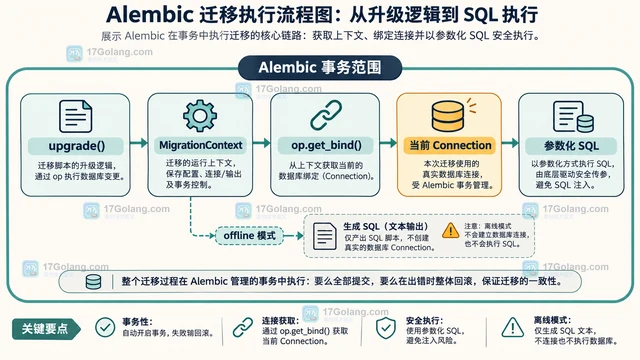 Alembic 迁移脚本需要执行带变量的 UPDATE 或 SELECT 时,可以用 op.get_bind() 获取当前 Connection,再用 SQLAlchemy text() 和 bindparam() 绑定参数。本文说明连接获取、参数化执行、结果读取、事务边界和 offline 模式限制。371 收藏
-
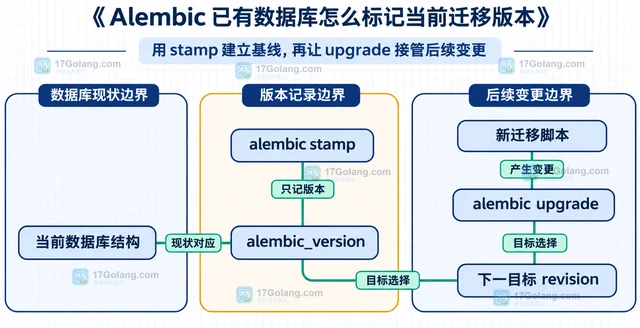 已有数据库接入 Alembic 时,用 stamp 只登记已经匹配的 revision,不重跑历史迁移;本文比较 revision、head、heads 的选择,并说明后续如何交给 upgrade。247 收藏
-
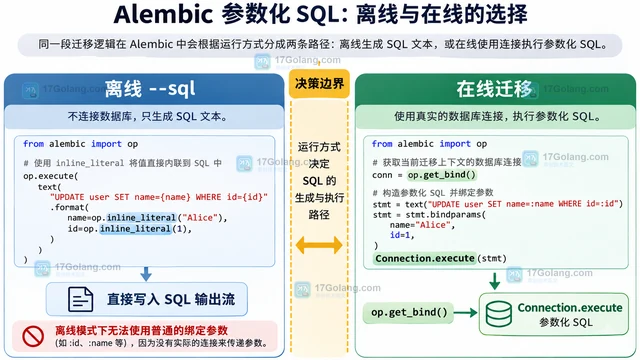 Alembic 迁移脚本执行带参数 SQL 时,应区分在线连接执行和离线 --sql 生成;本文给出 op.get_bind、text、绑定参数与 inline_literal 的选择方法。496 收藏
-
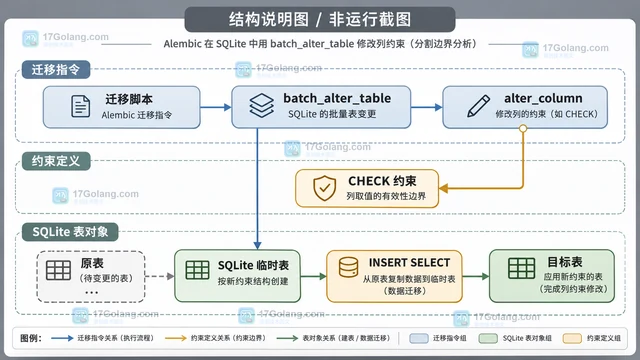 用 Alembic batch_alter_table 在 SQLite 中修改 nullable 和 CHECK 约束,解释表重建、命名约束、自动生成与迁移风险。341 收藏
-
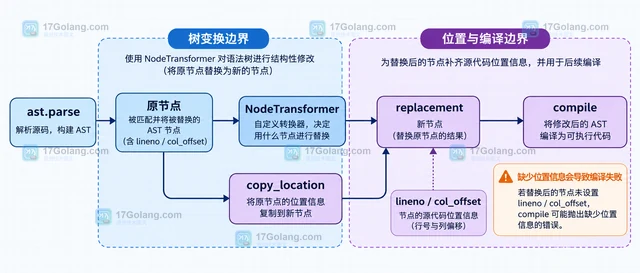 用 ast.NodeTransformer 替换节点后,先用 copy_location 对齐原节点,再用 fix_missing_locations 补齐新建子节点,最后在 compile 前检查源码位置。389 收藏
-
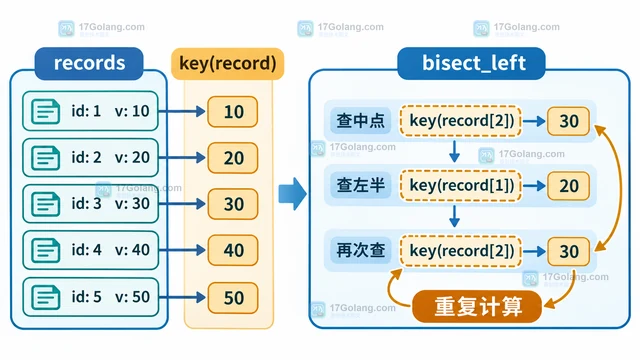 Python bisect 的搜索函数不会保存 key 结果,循环查询时可能反复计算同一条记录的键。本文用计数器定位开销,再用 records 与预计算 keys 的并行列表减少重复工作,并说明缓存、更新同步和 insort 插入成本。389 收藏
-
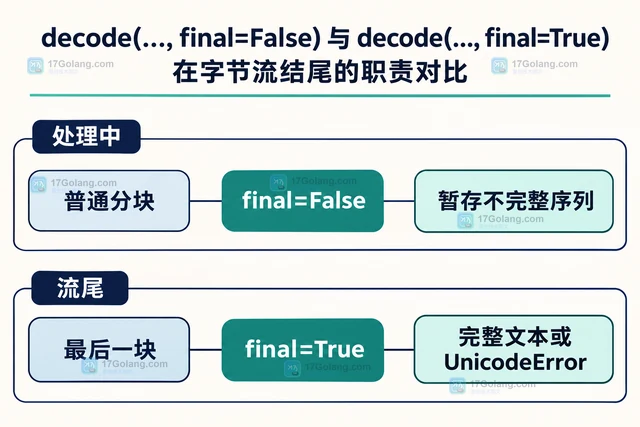 Python 增量解码器要把普通分块和流结束分开处理:前面的字节用 final=False,最后用 final=True 刷新内部缓冲;若尾部仍是不完整字节序列,再按 errors 策略明确处理。456 收藏
-
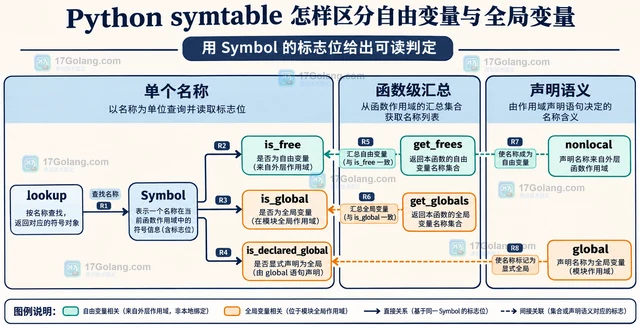 Python symtable 可以从源代码符号表中区分自由变量与全局变量。本文用嵌套函数说明如何定位目标 SymbolTable,如何用 lookup、is_free、is_global、is_declared_global 逐项判断,并用 get_frees、get_globals 做函数级摘要。248 收藏
-
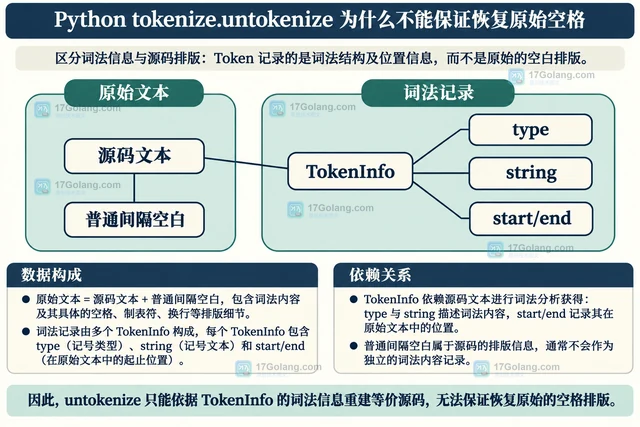 Python tokenize.untokenize 保证 token 类型和文本的往返对应,不保证原始空格。通过最小示例区分词法保真与字节保真,说明完整记录、文本补丁和编码的处理边界。265 收藏
-
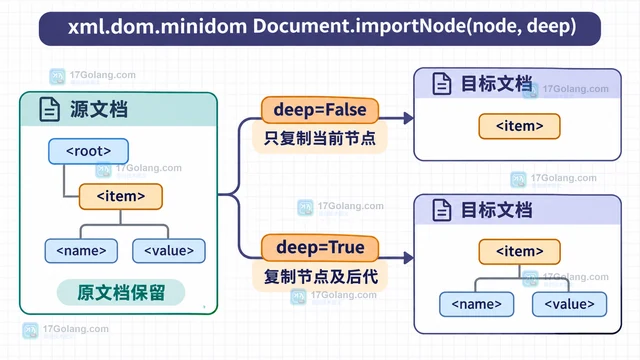 Python minidom 合并两份 XML 时,不能直接把源文档节点挂到目标文档。本文说明如何用目标文档的 importNode 复制节点,区分 deep=False 与 deep=True,并完成 appendChild、命名空间和资源释放处理。464 收藏