
用 runtime/metrics 读取 Go 运行时指标时,最容易误判的现象是“没有样本”。这个说法可能对应四种不同结果:传入的切片本来就是空的、指标名称不存在、标量值恰好为 0,或者直方图目前还没有观测计数。它们的处理方式并不相同。
正确做法是先用 metrics.All() 认识当前运行时支持的名称,再把名称写入复用的 []metrics.Sample,调用 metrics.Read 后检查 Value.Kind()。批量采集时,初始化和名称绑定放在循环外,重复读取只更新值,就能减少反复创建样本切片带来的分配。
官方地址:https://pkg.go.dev/runtime/metrics
先判断“没有样本”到底是哪一种情况
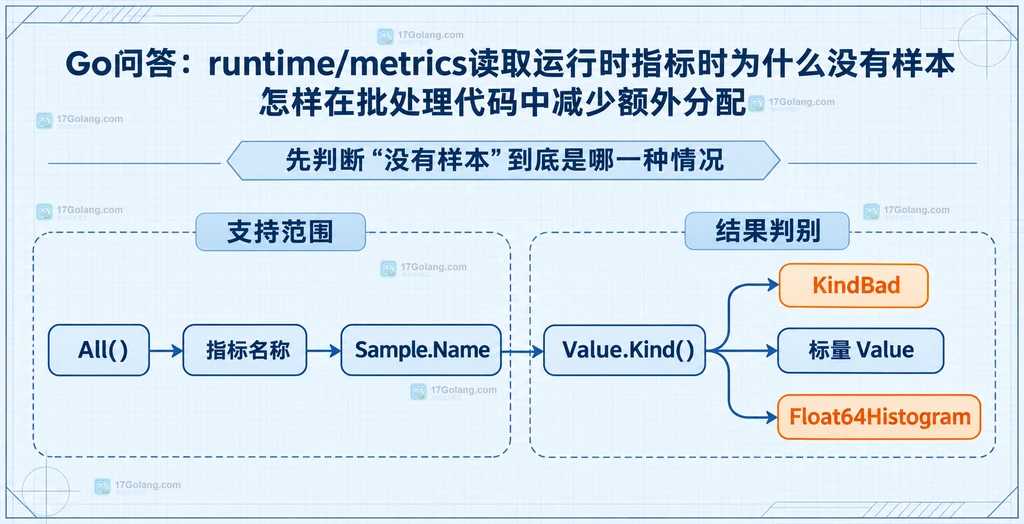
Read 不会返回一个新的样本集合,它会填充调用方传入的每个 Sample.Value。如果传入 nil 或长度为 0 的切片,自然不会有可读取的结果;如果名称不在当前运行时的支持列表中,结果的 Kind 会是 KindBad。
标量指标的 0 是合法值,不能把它当成“没采到”。直方图则不同:它返回的是桶边界和计数,程序刚启动、对应事件尚未发生时,计数可能全部为 0。此时是“暂时没有观测”,不是名称错误。
用 All 获取当前实现支持的指标
指标键是带单位的字符串,例如 /sched/goroutines:goroutines 或 /memory/classes/heap/free:bytes。不要凭记忆拼出名称后直接读取,尤其不要把指标描述中的自然语言当成键。All 返回当前实现支持的完整描述列表,适合在初始化阶段建立允许采集的名称集合。
package main

import (
	"fmt"
	"runtime/metrics"
)

func supportedNames() map[string]metrics.ValueKind {
	// 初始化时读取当前运行时的支持列表,避免手写不存在的指标名。
	result := make(map[string]metrics.ValueKind)
	for _, desc := range metrics.All() {
		// Kind 是该指标稳定的值类型,用于后续安全解码。
		result[desc.Name] = desc.Kind
	}
	return result
}

func main() {
	for name, kind := range supportedNames() {
		// 这里只展示名称和类型,实际采样可按白名单筛选。
		fmt.Printf("%s -> %v\n", name, kind)
	}
}
如果应用只关心少数指标,可以从 All 的结果中筛选白名单,而不是每轮读取全部指标。这样既减少后续解码工作,也让应用更容易适应运行时新增指标。
一次读取多个指标并按 ValueKind 解码
读取前为每个目标名称准备一个 Sample。读取后先判断 KindBad,再根据类型调用对应方法:KindUint64 使用 Uint64,KindFloat64 使用 Float64,直方图使用 Float64Histogram。不要直接对未知类型调用某个转换方法,否则会触发 panic。
package main

import (
	"fmt"
	"runtime/metrics"
)

func readSelected() {
	// 只采集本例需要的指标,名称必须带完整单位。
	samples := []metrics.Sample{
		{Name: "/sched/goroutines:goroutines"},
		{Name: "/memory/classes/heap/free:bytes"},
		{Name: "/sched/latencies:seconds"},
		{Name: "/not/a/real/metric:items"},
	}

	// Read 会原地填充 Value,不会返回新的 []Sample。
	metrics.Read(samples)
	for _, sample := range samples {
		switch sample.Value.Kind() {
		case metrics.KindBad:
			// 未知指标要记录并跳过,不能把它当成数值 0。
			fmt.Printf("unsupported metric: %s\n", sample.Name)
		case metrics.KindUint64:
			fmt.Printf("%s = %d\n", sample.Name, sample.Value.Uint64())
		case metrics.KindFloat64:
			fmt.Printf("%s = %f\n", sample.Name, sample.Value.Float64())
		case metrics.KindFloat64Histogram:
			// 直方图可能暂时没有计数,先交给专门的桶统计逻辑。
			hist := sample.Value.Float64Histogram()
			fmt.Printf("%s buckets=%d counts=%d\n", sample.Name, len(hist.Buckets), len(hist.Counts))
		}
	}
}
这里的“没有样本”要结合分支判断:看到 unsupported metric 是名称或运行时支持范围问题;看到标量 0 是合法数据;看到直方图桶存在但计数没有增长,则要等对应运行时事件发生,或重新检查采样对象是否选对。
在批处理循环中复用 Sample 切片
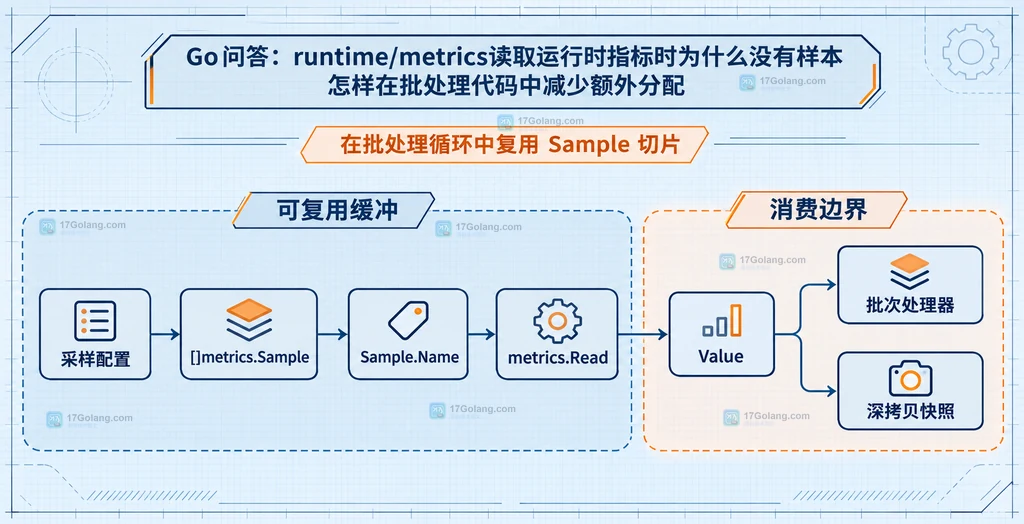
如果每隔一段时间采集一次,最常见的浪费是把 []metrics.Sample 和名称绑定放在循环里。名称在采集任务的生命周期内通常不变,可以把它们初始化一次,然后重复调用 Read。这不会把旧值“自动清零”;每次读取后都应把当前值转成自己的记录,再进入下一轮。
package main

import (
	"runtime/metrics"
	"time"
)

type sampler struct {
	samples []metrics.Sample
}

func newSampler() *sampler {
	// 只在创建采样器时分配切片和名称,后续批次复用它。
	return &sampler{samples: []metrics.Sample{
		{Name: "/sched/goroutines:goroutines"},
		{Name: "/memory/classes/heap/free:bytes"},
	}}
}

func (s *sampler) collect() []uint64 {
	// Read 原地更新 Value;调用期间不要并发读取 s.samples 中的 Value。
	metrics.Read(s.samples)
	values := make([]uint64, 0, len(s.samples))
	for _, sample := range s.samples {
		// 只把可直接表示为 uint64 的指标复制到本批结果。
		if sample.Value.Kind() == metrics.KindUint64 {
			values = append(values, sample.Value.Uint64())
		}
	}
	return values
}

func main() {
	s := newSampler()
	ticker := time.NewTicker(time.Second)
	defer ticker.Stop() // 退出时释放定时器资源。
	for range ticker.C {
		_ = s.collect() // 实际应用应把复制后的值发送到下游。
	}
}
这个示例只复用采样缓冲;collect 返回的新切片是为了让下游持有独立数据。如果需要转发直方图,不能只保存指针后立即进入下一轮,因为运行时可能复用底层存储。要么在消费完成前暂停下一次读取,要么把桶和计数深拷贝成应用自己的结构。
处理并发读取与版本变化
多个 Read 可以并发执行,但每次调用使用的参数不能共享底层内存。最简单的规则是:单个采集器独占自己的 samples,不要把同一个切片同时交给两个 goroutine。若读取期间另一个 goroutine 访问正在被更新的 Value,就会形成数据竞争。
不要假设所有版本都拥有同一套扩展指标。初始化时用 All 构建支持集合,对关键指标缺失采用明确降级;对非关键指标记录一次并跳过。对于已经确认存在的指标,其 ValueKind 不会随意改变,因此可以在配置阶段保存类型,运行阶段只做必要的解码。
结论:先区分状态,再谈采样性能
runtime/metrics “没有样本”通常不是一个单一故障。空切片说明没有准备读取对象,KindBad 说明名称不受支持,标量 0 是有效值,直方图计数为 0 则可能只是尚未发生对应事件。把这些情况分开后,批处理优化就很直接:初始化阶段筛选名称并绑定 Sample.Name,循环内复用切片,读取后立即复制需要跨轮保存的数据,直方图和并发场景按所有权边界处理。
常见追问
为什么我打印了 Sample,却看不到运行时指标?
先确认切片长度大于 0,并在 Read 之后打印 Value.Kind()。若是 KindBad,优先检查名称和单位后缀。
指标值为 0 就代表采集失败吗?
不一定。无符号标量的 0 可以是合法状态;直方图则要检查桶计数是否有观测,而不是只看桶数量。
能不能每次调用 Read 都重新创建 Sample?
可以,但高频批处理会增加分配和垃圾回收压力。名称集合不变时复用同一切片更合适;并发任务则为每个任务准备独立底层数组。




