
cgroup v2 memory pressure容器内存回收前怎样读取压力指标怎样完成一个可复用的最小示例
来源:17golang原创
时间:2026-11-10 05:47:51 140浏览 收藏
容器内存还没有触发 OOM,但请求延迟已经开始抖动时,只看 memory.current 往往不够。cgroup v2 的 PSI(Pressure Stall Information)可以回答另一个问题:这个 cgroup 里的任务有多少时间因为内存资源紧张而停顿。实践中,先读取 memory.pressure,再结合 memory.events 和实际回收动作,通常比等到 OOM 后再处理更早。
本文只解决一个具体任务:定位容器对应的 cgroup,读取其 memory pressure 指标,并把文本解析成可复用的数据。示例不把压力值当成内存使用率,也不把一次读数直接当成回收或 OOM 结论。
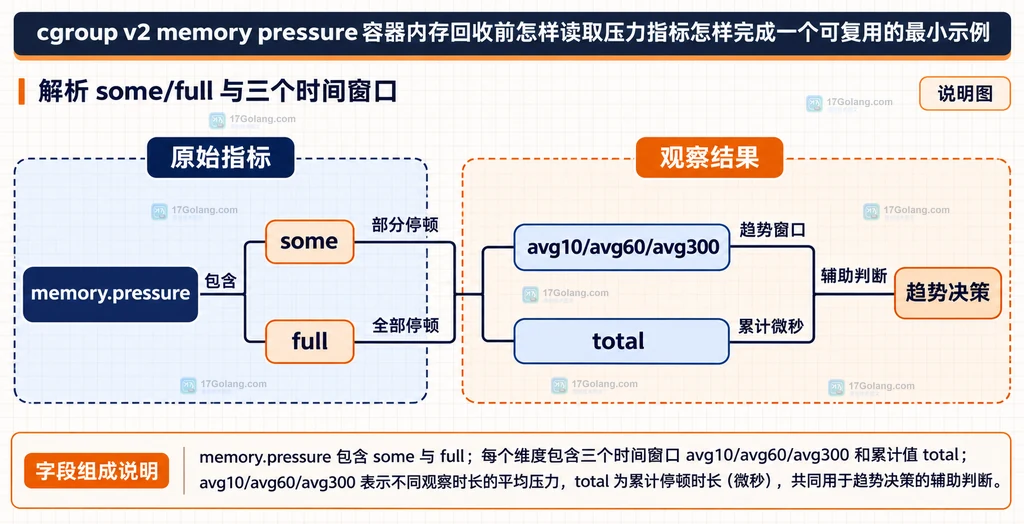
先记住结果:看短时突发用 some avg10,看持续拥塞用 some avg60 或 avg300,看所有非空闲任务同时停顿的严重状态用 full。这些值是百分比趋势;total 是累计停顿时间,单位是微秒。
一、memory.pressure 解决什么问题
PSI 关注的是“任务因为资源紧张而无法继续推进”的时间。内存压力上升时,任务可能在回收、压缩或等待可用页的过程中停顿;这和“当前用了多少字节”是两种不同的观测。内核文档把 some 定义为至少有部分任务处于停顿,full 则表示所有非空闲任务同时处于停顿状态。
在 cgroup v2 中,每个 cgroup 目录都可能出现 memory.pressure。它与系统级 /proc/pressure/memory 使用相同格式,因此可以沿用同一套解析器;区别在于前者只描述该 cgroup 及其层级范围内的任务。
二、先定位目标 cgroup,再读取原始文本
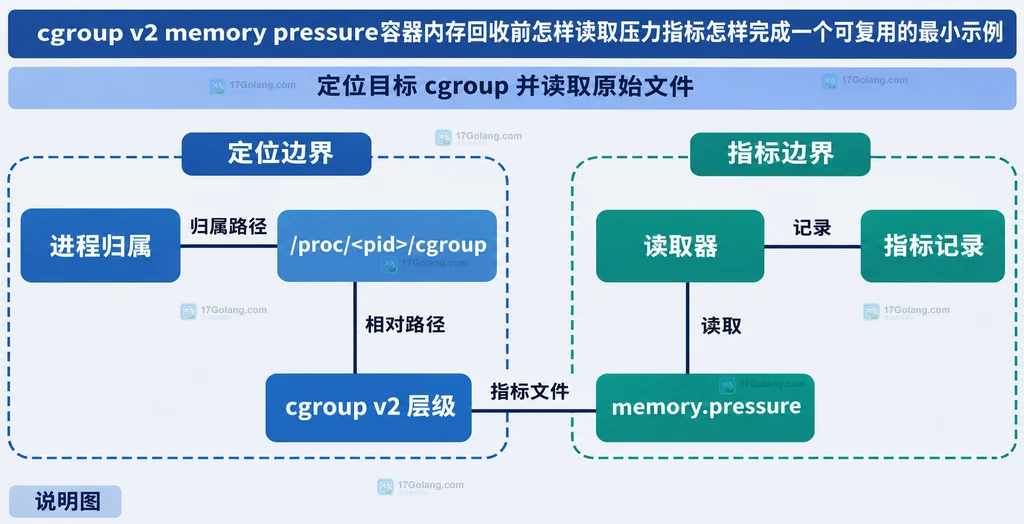
不要直接假定所有容器都对应同一个固定目录。可以先读取目标进程的 cgroup 归属,再把统一层级的相对路径拼到 cgroup v2 挂载点。下面的命令只做定位和读取,输出中的路径需要替换为当前机器实际看到的值。
# 用目标进程 PID 查看 cgroup v2 的相对路径
pid=1234
cg_rel=$(awk -F: '$1 == "0" {print $3}' "/proc/$pid/cgroup")

# cgroup v2 常见挂载点;生产脚本应按实际挂载情况调整
cg_root=/sys/fs/cgroup
pressure_file="$cg_root$cg_rel/memory.pressure"

# 原样读取指标,便于保留 some/full 两行和所有字段
if [ -r "$pressure_file" ]; then
  cat "$pressure_file"
else
  echo "无法读取:$pressure_file" >&2
  exit 1
fi
这里的关键不是 cat,而是 /proc/ 中的 0::/... 路径。容器内如果没有暴露对应的 cgroup 文件或挂载点,脚本会得到“文件不存在”或“无权限”,这属于观测边界问题,不应伪造一个宿主机路径继续读。
典型原始内容类似下面这样。它是格式示意,不是某台机器的实时结果:
some avg10=0.00 avg60=1.25 avg300=0.48 total=183000
full avg10=0.00 avg60=0.10 avg300=0.03 total=42000
三、解析 some/full、时间窗口和 total
每行第一个字段是指标类型,后面的键值对可以按名称读取。这样做比依赖字段顺序更稳妥,也能兼容未来增加字段的情况。avg10、avg60、avg300 表示最近 10、60、300 秒窗口内的停顿比例;total 是从该 cgroup 开始统计以来的累计停顿微秒数。
from pathlib import Path

def read_memory_pressure(path: str) -> dict[str, dict[str, float]]:
    """读取 cgroup v2 memory.pressure,并按行名返回数值字段。"""
    result: dict[str, dict[str, float]] = {}
    # 读取失败应保留原始异常,让调用方区分权限、路径和格式问题。
    for line in Path(path).read_text(encoding="utf-8").splitlines():
        parts = line.split()
        if len(parts)
如果只关心趋势,可以先记录 some.avg10 和 some.avg60;如果发现 full 也持续上升,则说明整个非空闲工作集合都在停顿,通常需要更谨慎地降载或扩容。不要把 total 与百分比直接比较,它们的单位和语义不同。
四、支持范围与缺失时的降级处理
首先确认当前系统确实使用 cgroup v2,并且内核启用了 PSI。统一层级的目录中应能看到 cgroup.controllers 等接口文件;目标目录下是否有 memory.pressure,还取决于内核能力、挂载方式和容器命名空间可见性。
# 检查统一层级与目标压力文件是否可见
test -f /sys/fs/cgroup/cgroup.controllers && echo "发现 cgroup v2 根目录"
test -r /sys/fs/cgroup/workload/memory.pressure && echo "发现 memory.pressure"

# 缺失时回退到系统级指标,但必须明确它不等于单个容器的压力
if [ ! -r /sys/fs/cgroup/workload/memory.pressure ]; then
  echo "目标 cgroup 指标不可见,改读系统级参考值"
  cat /proc/pressure/memory
fi
系统级回退只能用于判断整机是否也在承压,不能拿来给某一个容器定责。如果连 /proc/pressure/memory 都不存在,就应把 PSI 标记为“不支持或不可见”,改用 memory.current、memory.events 等可见指标,并在监控中区分“指标缺失”和“压力为零”。
五、怎样在内存回收前使用这些指标
推荐把读取结果放进一个小的时间序列,而不是只读一次就执行回收。一个简单策略是:短时 avg10 突然升高时先提高采样频率;avg60 连续升高时触发降载或减少并发;只有当趋势、memory.events 和业务延迟同时恶化时,才进入主动回收、迁移或扩容决策。
读取 memory.pressure 本身不会改变内存状态,也不会替代内核回收。脚本应使用只读权限,避免把监控账户授予写 cgroup 配置的能力;记录时保留 cgroup 标识和采样时间,但不要把容器内的敏感业务参数写进日志。
常见问题
memory.pressure 的 avg10 是内存使用率吗?
不是。它是最近 10 秒内任务因内存压力而停顿的时间比例,不能直接换算成已使用字节。
为什么 memory.pressure 有文件但读不到容器压力?
优先检查进程的 /proc/ 路径、cgroup v2 挂载点和容器命名空间可见性。读不到目标文件时,系统级 PSI 只能作为整机参考,不能冒充容器级指标。
什么时候应该看 full?
当你需要识别“所有非空闲任务同时停顿”的严重拥塞时看 full。它适合与业务延迟和回收事件一起判断,不适合单独作为 OOM 预测器。
总结
cgroup v2 memory pressure 的最小闭环是:从进程找到 cgroup 相对路径,读取对应的 memory.pressure,按 some/full 和字段名解析,再用时间窗口趋势决定是否降载。这样得到的是“任务被内存压力拖住了多久”,与内存字节数、回收事件和 OOM 结果互补,而不是替代它们。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
162 收藏
-
261 收藏
-
181 收藏
-
361 收藏
-
256 收藏
-
文章 · linux | 39分钟前 | Linux · systemd-journald RateLimitIntervalSec RateLimitBurst LogRateLimitBurst Linux 日志限流477 收藏
-
171 收藏
-
130 收藏
-
208 收藏
-
367 收藏
-
226 收藏
-
294 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习