-

随着技术的发展,“为什么要修复未损坏的东西”这句老话已不再有效。在当今“永远在生产”的世界中,工厂和生产设备全天候运转,任何故障都会导致生产严重中断,有时甚至会对其他下游
-
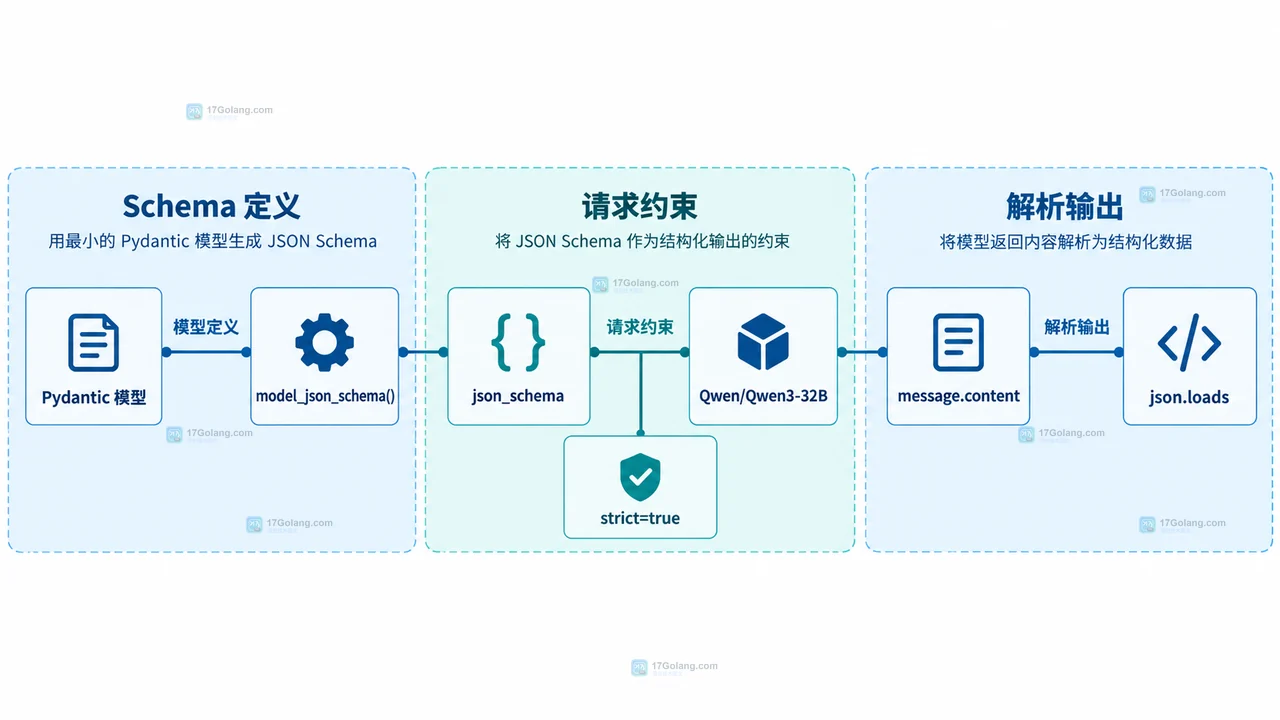
以 Hugging Face InferenceClient 为例,拆解结构化输出失败的三层原因,用最小 JSON Schema 和检查清单快速定位配置、模型兼容性与解析问题。
-
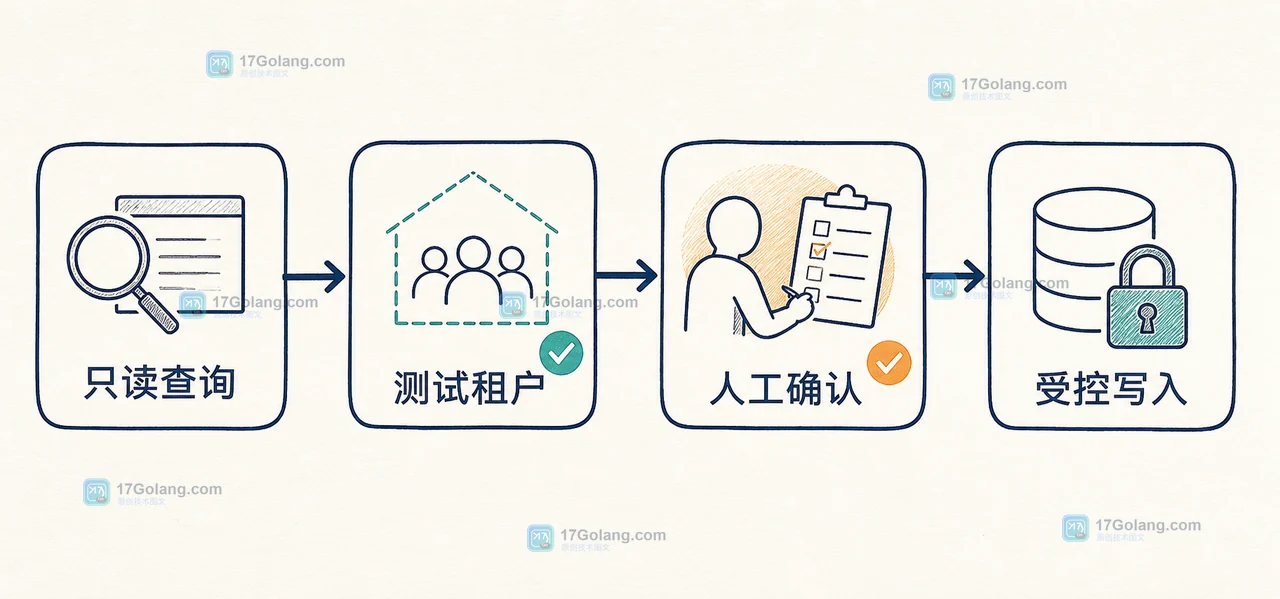
远程 MCP 服务器让 AI 应用可以连接外部数据和工具,但接入前必须核对来源、工具权限、读写范围与撤销路径。本文给出一份不依赖具体厂商的上线前检查清单。
-

需重点控制动作连贯性、动态模糊强度与关键帧节奏:一、用分镜提示词描述“追—跃—接”三阶段;二、调高MotionIntensity至0.75、启用KeyframeLock、设BlurThreshold为0.3;三、上传三张对齐视角参考图并绑定帧序;四、手动微调第12–14帧犬齿与飞盘接触细节。
-

豆包AI需建立结构化触发机制与上下文锚定策略才能稳定生成符合岗位规范的日报周报:一、构建角色-任务-格式三位一体提示词模板;二、启用对话上下文锁定与关键词唤醒机制;三、设置批量生成与人工卡点筛选工作流;四、部署本地指令快捷键与变量替换协议;五、建立输出校验清单与偏差熔断机制。
-

可灵AI灵感值用完时,可通过五种方式继续生成:一、重新登录领取66灵感值;二、注册可灵国际版获50灵感值;三、用海艺AI调用可灵2.6模型;四、邀请新用户得300灵感值;五、发布审核通过的原创短片获680灵感值。
-
M3Max无法原生运行DeepSeek-R1满血版(671B),需通过4-bit量化+KV缓存卸载、NPU全核绑定、eGPU带宽扩展及Metal堆栈VRAM阈值突破组合实现功能等效推理。
-

Llama3持续预训练算力消耗远低于从头训练,可通过四种方法估算:基于Token总量与每Token计算量、参考实测吞吐量、增量训练占比经验缩放、显存占用与批次推导,具体数值取决于数据规模、模型版本、序列长度及优化策略。
-

Perplexity页面异常是因浏览器缓存与Cookie残留导致前端资源错乱或鉴权冲突,需通过开发者工具清除缓存/Cookie、禁用缓存重载、执行脚本删Cookie或重置ServiceWorker。
-
豆包AI接口按Token消耗实时计费,含免费额度、资源包抵扣、RPM/TPM限流及阶梯定价五类规则。新用户享每模型50万tokens试用额;Lite模型可用资源包抵扣,Pro等系列需余额结算;10KTPM包月价2000元,较按量低85%;默认限流10KRPM/800KTPM;语音识别等支持日阶梯计费。
-

角色Prompt有效性的关键在于细节锚点而非身份标签,需用可触发的具体行为规则(如停顿习惯、句式限制、状态特征)替代空泛描述,通过动态条件句和最小控制点部署响应协议。
-

优先切换高时长专用模型,如教育模型(30s)、导演模式(20s);其次分段生成后本地拼接;再启用I2V-01-Director等支持自定义时长的模型;还可调用API批量控制帧序列;最后可结合外部延时序列混合增强。
-

需在消息流转链路中嵌入支付校验环节以实现会员制变现,具体包括:一、企业微信支付API对接;二、支付宝当面付跳转H5;三、公众号+微信支付JSAPI混合模式;四、Token计费+余额扣减模型。
-

提升ChatGPT行文流畅度需五步:一、明确任务指令并限定表达边界;二、分步引导构建段落流;三、注入参考样例校准节奏;四、设定事实与衔接核查机制;五、使用动态记忆锚点保持主线稳定。
-

收到“登录环境存在风险”提示时,可采取三种操作:一、临时关闭风险IP检测,按Ctrl+Shift+D调出控制台并执行window.__WB_DISABLE_IP_RISK_CHECK__=true;二、将当前IP添加为授信出口,访问workbuddy.qq.com/trusted-ip/add完成核验;三、强制同步设备指纹,在客户端数据目录新建device_fingerprint_override.json文件并写入{"force_sync":true,"timestamp":1745164200}。
