
人工智能技术文章
-
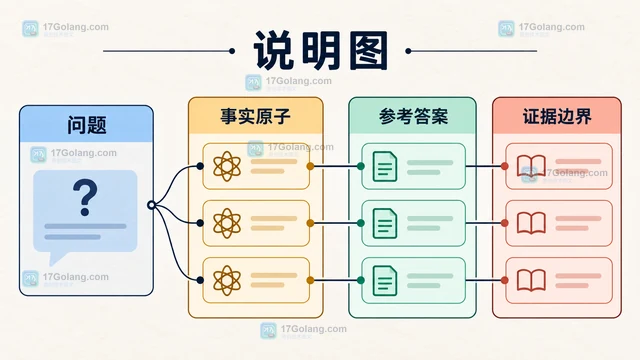 生成式回答的事实性评测不能只准备一组问题和一个总分。本文从样本边界、参考答案、事实原子、支持与矛盾判分以及人工复核五个方面,设计一套可比较的对照样本结构。144 收藏
-
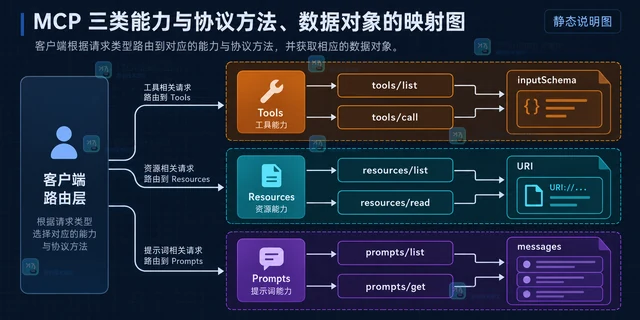 MCP 客户端不要靠名称猜对象类型,而应先读取初始化响应中的 tools、resources、prompts 能力,再按 tools/list、resources/list、prompts/list 等方法路由。本文用统一目录、交互模型和安全指标拆开三类能力的边界。142 收藏
-
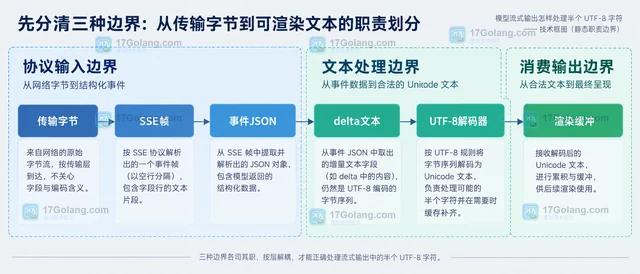 模型流的网络字节、SSE 帧和 UTF-8 字符不是同一条边界。本文用 Go 的 unicode/utf8 保存不完整尾部,说明如何在增量渲染中避免半个字符变成乱码,并划清 SDK 文本事件与原始字节适配层的职责。140 收藏
-
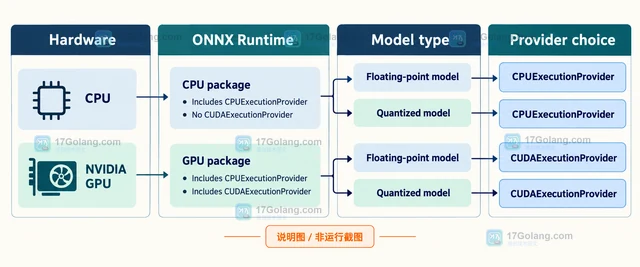 从 provider 能力检查、单一后端加载到 providers 优先级回退,说明 Optimum ONNX Runtime 如何选择执行提供程序,以及 CUDA、TensorRT、量化模型的常见边界。136 收藏
-
科技周边 · 人工智能 | 15小时前 | python · 人工智能 · gemini · 结构化输出 · Pydantic JSON Schema Gemini API google-genai structured output
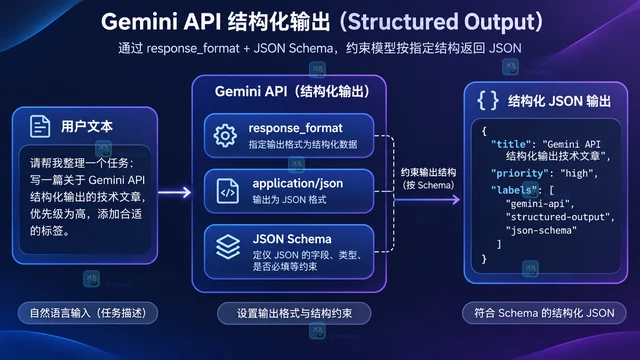 Gemini API structured output 可以让模型按 JSON Schema 返回稳定的对象结构。本文用一个工单字段抽取小例子说明 response_format、application/json、object、enum、array 和本地解析之间的关系,并区分结构约束与业务校验。136 收藏
-
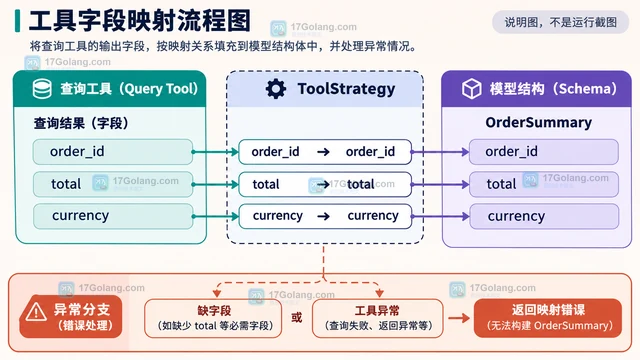 LangChain 的工具返回值不是最终数据模型。本文用 Pydantic 与 ToolStrategy 拆开工具消息、结构化响应和错误边界,说明怎样把查询结果稳定地交给业务代码。135 收藏
-
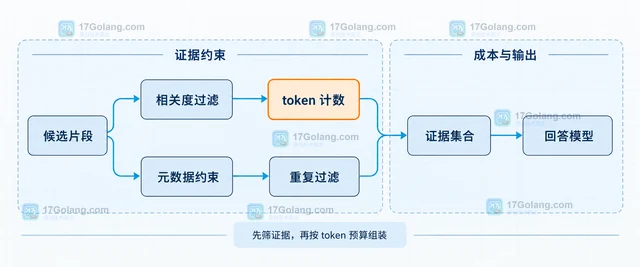 RAG 的 top-k 不是越大越好。本文用候选召回、相关度过滤、片段去重和 token 预算拆解如何稳定组装上下文。133 收藏
-
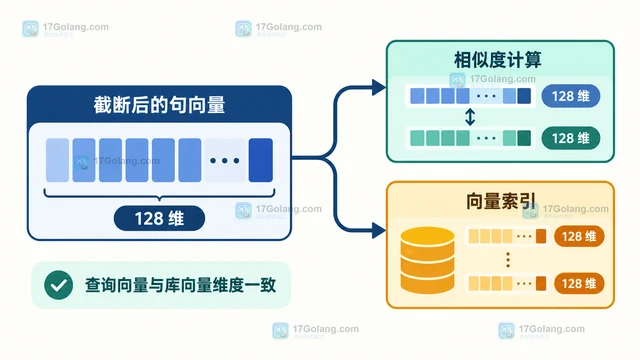 Sentence Transformers 的 truncate_embeddings 用于把已有嵌入矩阵截取到目标维度。本文说明样本轴与维度轴的区别、NumPy 与 Tensor 输入、相似度计算、索引迁移和模型适配边界。132 收藏
-
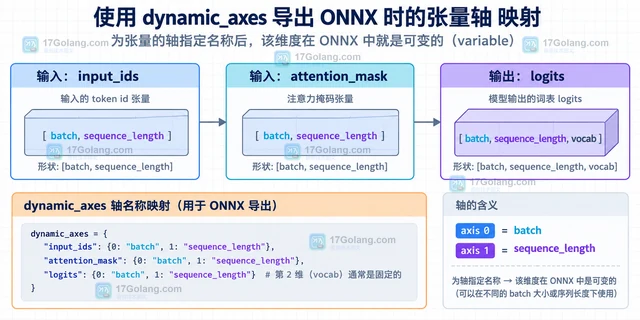 本文围绕 PyTorch ONNX 导出的 dynamic_axes,说明如何为文本模型声明动态 batch 和序列长度,解释输入输出轴对齐,并区分传统导出路径与新 dynamo 导出器的 dynamic_shapes。131 收藏
-
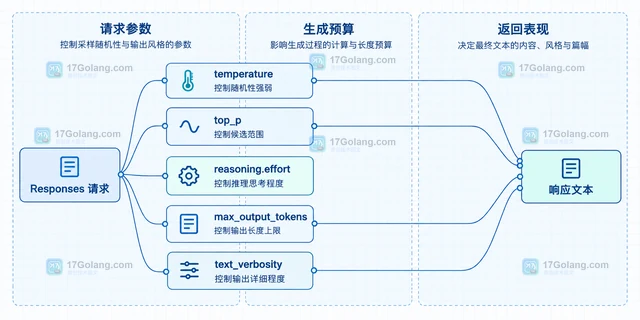 OpenAI API 中 top_p 直接影响候选概率范围,reasoning.effort 与 max_output_tokens 分别控制推理投入和输出预算。本文用 Responses API 示例说明如何区分职责并避免同时调 temperature 与 top_p。131 收藏
-
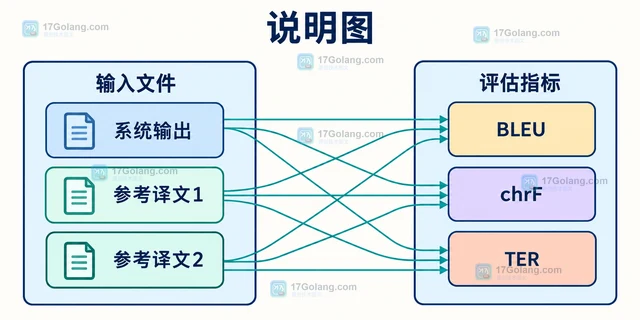 SacreBLEU 评估同一批机器翻译输出时,可以把多条参考译文作为多个位置参数传入,也可以按行合并为制表符文件并使用 --num-refs 声明参考数量。本文说明两种输入维度、常见误区和 BLEU、chrF、TER 的选择。131 收藏
-
科技周边 · 人工智能 | 3星期前 | 人工智能 · Hugging Face Datasets streaming IterableDataset Dataset.shuffle shuffle buffer
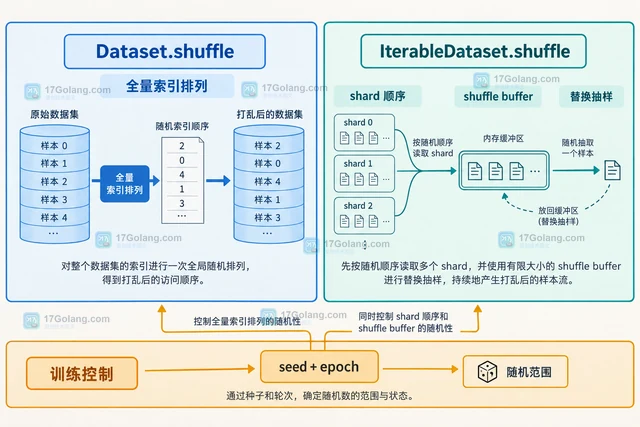 Hugging Face Datasets 的 Dataset.shuffle 会为内存数据集建立全量索引映射,IterableDataset.shuffle 则通过 shard 顺序和有限 shuffle buffer 做近似随机。本文解释两者的访问模型、随机范围、性能代价与训练参数选择。130 收藏
-
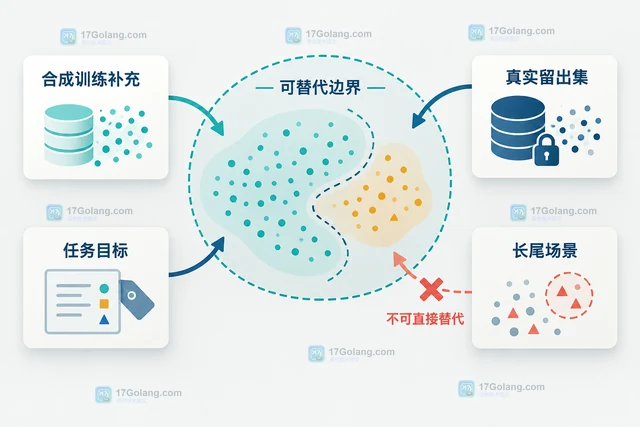 合成数据不能仅凭外观接近真实样本就直接替代。本文从覆盖率、分布与相关关系、真实留出集任务效果、偏差和隐私四层检查,说明如何决定它适合补充、加权使用还是禁止替代。128 收藏
-
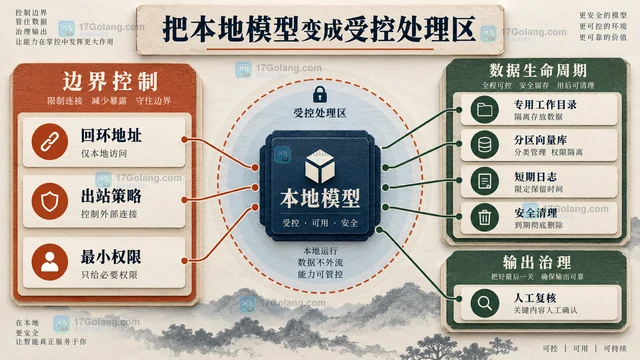 本地模型只缩短了资料到推理引擎的链路,并不会自动封闭插件、日志、向量库、监听端口、同步备份和输出协作等路径。本文用“本地受控处理区”模式梳理常见泄露面、典型实现、反例和上线检查清单。127 收藏
-
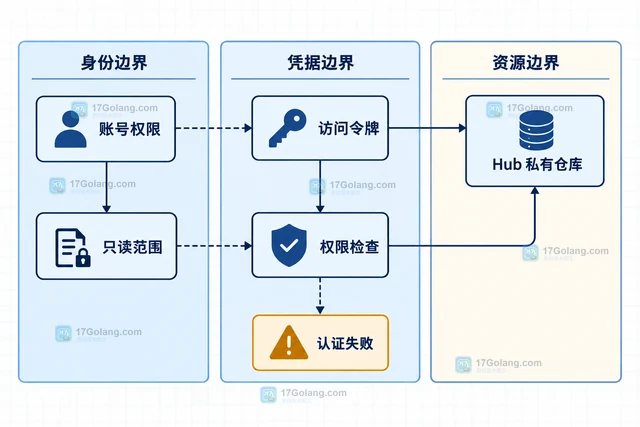 访问 Hugging Face Hub 私有模型时,关键不是把 token 写进 from_pretrained,而是先确认仓库权限,再用最小权限令牌登录,并通过环境变量或 huggingface_hub 的安全入口传递凭据。127 收藏