-
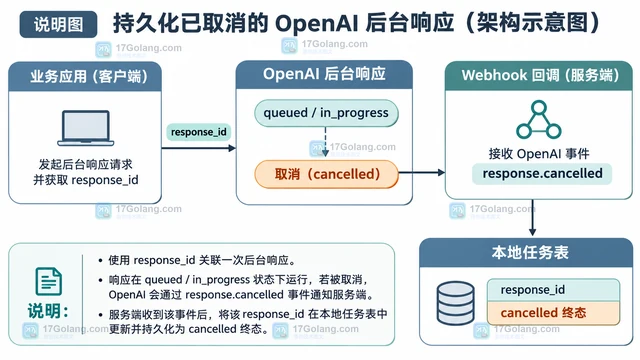
OpenAI 后台响应取消后,不要只依赖前端按钮或覆盖式写状态。本文用 response_id、response.cancelled 和条件更新设计一套可幂等的本地任务状态保存方案。
-
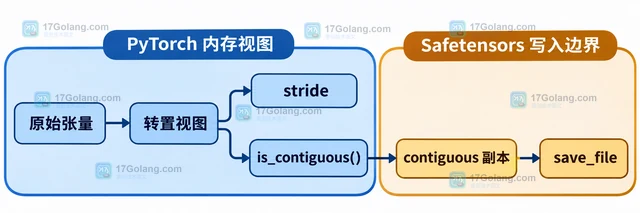
Safetensors 保存转置张量时,关键是在 save_file 边界把非连续视图转换为连续且稠密的 Tensor。本文解释 transpose 的布局变化、contiguous 的复制边界、字典批量处理方式,以及普通张量与共享权重保存的区别。
-
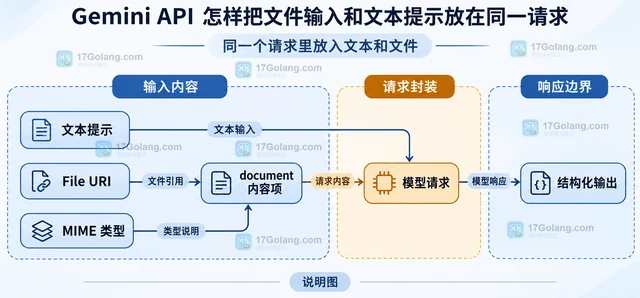
用 Gemini Files API 上传文件后,把文件 URI、MIME 类型和文本提示放入同一个请求;本文同时说明 PROCESSING、ACTIVE、FAILED 状态与临时生命周期,避免把过期文件当成永久资源。
-
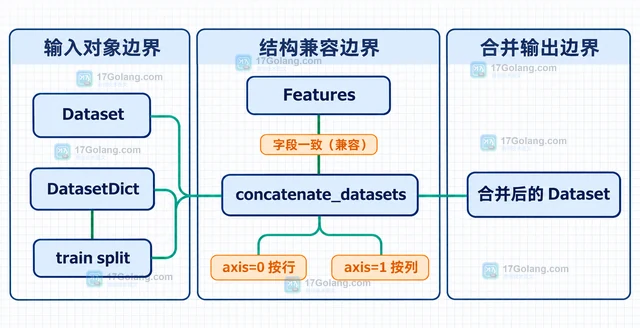
用 Hugging Face Datasets 的 concatenate_datasets 合并字段结构一致的 Dataset,说明 axis=0 与 axis=1、DatasetDict 的 split 取值方式,以及列名或 Features 不一致时的排查路径。
-
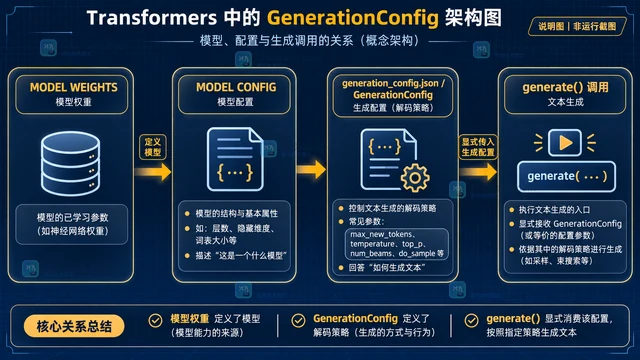
用 GenerationConfig 集中保存 Transformers 的生成参数,掌握 generation_config.json 的复用方式、加载边界和 generate 调用优先级。
-
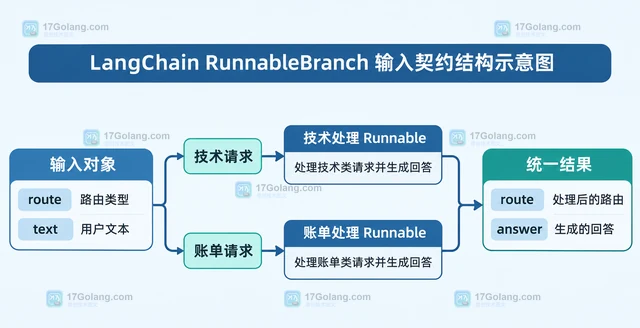
LangChain RunnableBranch 通过条件与 Runnable 对组成输入路由,按条件顺序选择第一个匹配分支,并用默认 Runnable 兜底。本文用统一输入输出契约演示如何构造、串接和控制它。
-
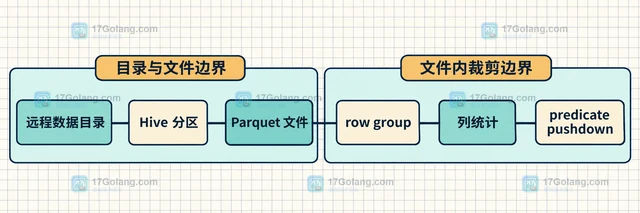
远程 Parquet 查询的成本不只来自 SQL:Hive 分区决定先跳过哪些文件,row group 大小影响并行、压缩和列统计裁剪。本文用 DuckDB 语句拆清两层布局关系,并给出按查询形态选择数据组织方式的建议。
-
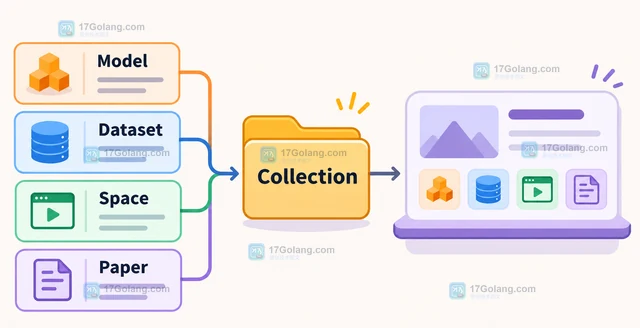
本文以一个项目目录的整理场景为线索,说明 Hugging Face Collections 如何创建集合、加入模型/数据集/Space、添加纯文本备注、调整条目顺序并处理公开展示边界。
-
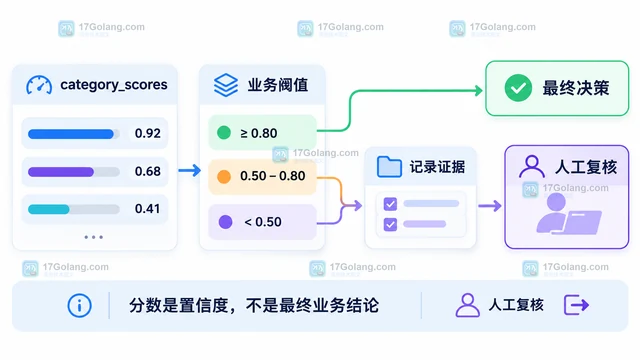
内容审核接口返回的 flagged、categories 和 category_scores 不能混成一个布尔条件。本文用三路决策模型说明多标签结果怎样进入自动通过、拦截和人工复核,并给出记录证据、处理异常和校准阈值的最小实现。
-
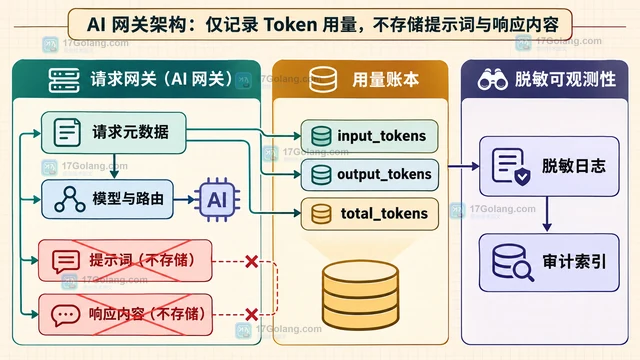
AI 网关可以在模型响应边界读取 input_tokens、output_tokens 和 total_tokens,只把请求标识、模型、延迟、状态与用量写入脱敏事件;本文说明如何拆分模型请求路径、观测路径和聚合账本,并处理流式、重试、缓存、权限与保留期边界。
-
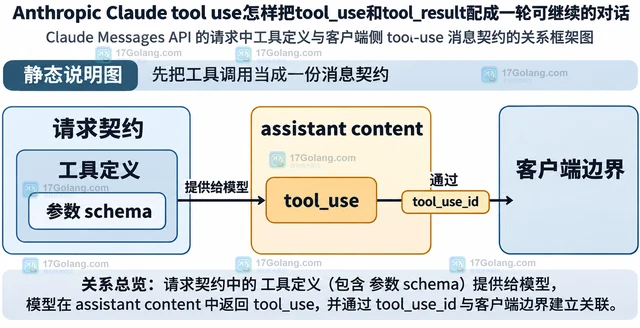
Claude 客户端工具调用最容易错在消息回填:先保存完整的 assistant tool_use,再执行白名单工具,最后用原 tool_use_id 把结果放进 user 的 tool_result。本文用 Python 示例讲清消息顺序、错误处理和审计边界。
-
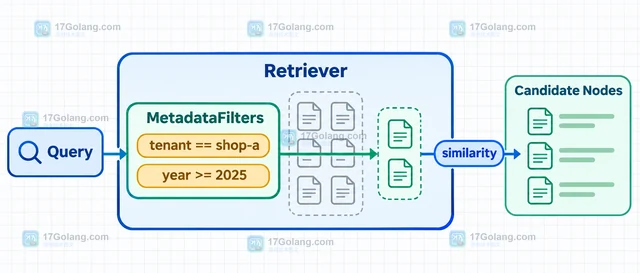
用 LlamaIndex 的 MetadataFilter 和 MetadataFilters 按租户、分类、年份等元数据筛选检索节点,并说明 AND/OR 组合、字段类型和向量库支持边界。
-
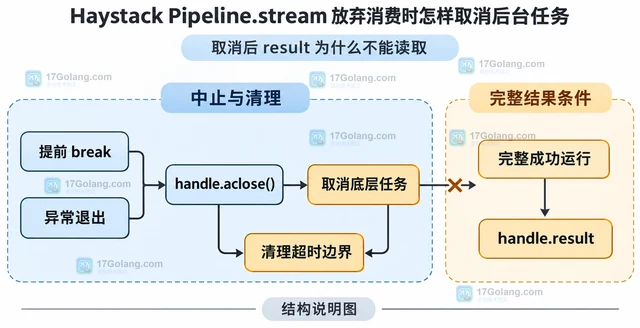
Haystack Pipeline.stream 返回可异步迭代的 PipelineStreamHandle。停止消费流式结果时,建议在 try/finally 中显式调用 await handle.aclose(),取消底层任务并完成有界清理;取消后的 handle.result 不可作为最终结果读取。
-
JAX 未注册的自定义类会整体作为叶子,无法让 jax.jit 看到内部数组。本文用 register_pytree_node、register_pytree_node_class 和 register_dataclass 说明动态字段、静态元数据与对象重建的注册边界。
-
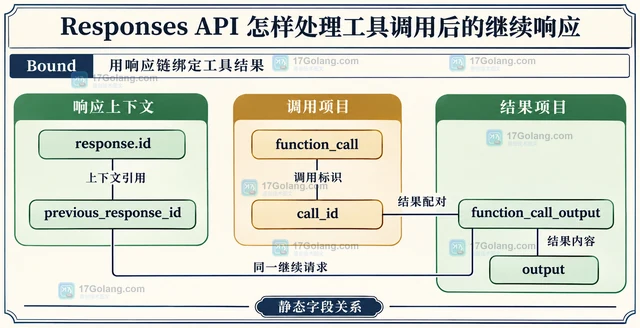
讲清 Responses API 自定义工具调用后的结果回传与继续响应,用 Python 示例说明 call_id 配对、响应链、批量调用、停止预算及应用层恢复责任。
