-
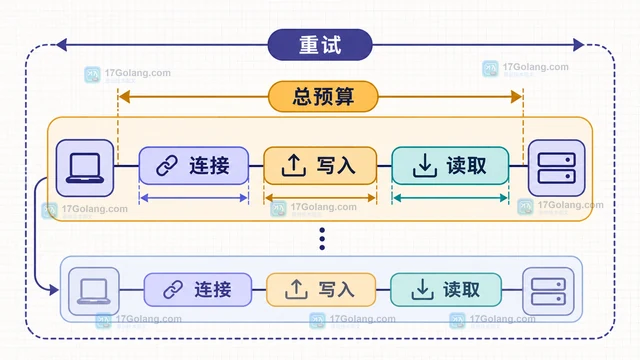
使用 OpenAI 兼容接口时,超时应同时考虑客户端默认值、单次请求覆盖、连接与读取阶段,以及超时后的重试预算。本文以 Python 客户端为例,给出从无限等待迁移到可控超时和异常处理的完整做法。
-
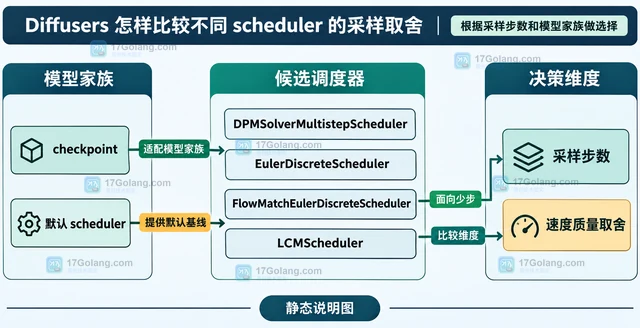
从同一 pipeline、固定输入和 from_config() 出发,比较 Diffusers 不同 scheduler 在采样步数、速度、稳定性与细节上的取舍,并给出按模型家族选择的判断方法。
-
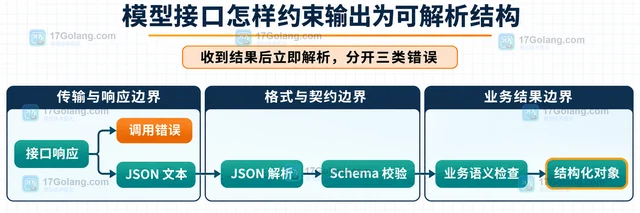
本文用一个工单摘要示例说明模型接口怎样用 JSON Schema 或 grammar 约束输出形状,并区分接口错误、JSON 解析错误、Schema 校验错误和业务语义问题。
-
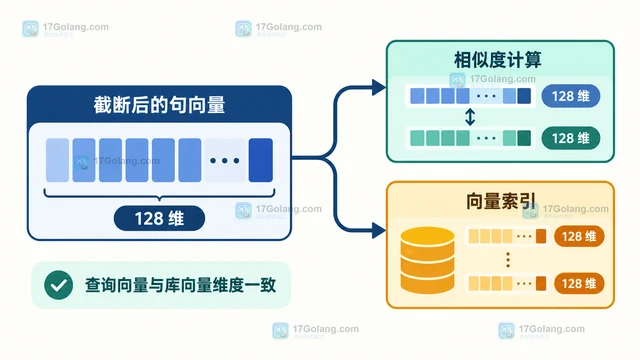
Sentence Transformers 的 truncate_embeddings 用于把已有嵌入矩阵截取到目标维度。本文说明样本轴与维度轴的区别、NumPy 与 Tensor 输入、相似度计算、索引迁移和模型适配边界。
-
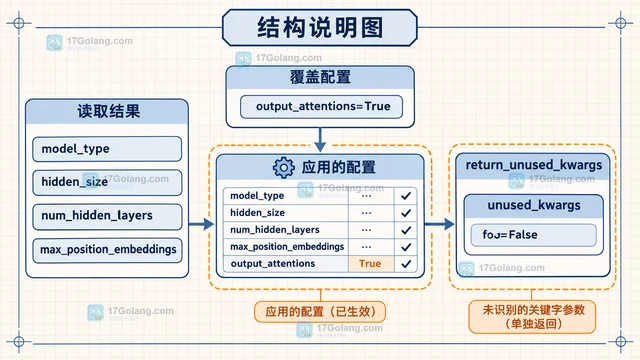
Transformers 的 AutoConfig.from_pretrained 可以在加载模型权重前读取配置对象。本文用一个窄而实用的流程说明如何查看 model_type、hidden_size、num_hidden_layers 和 max_position_embeddings,怎样覆盖配置字段,以及如何用 return_unused_kwargs 识别拼写或边界错误。
-
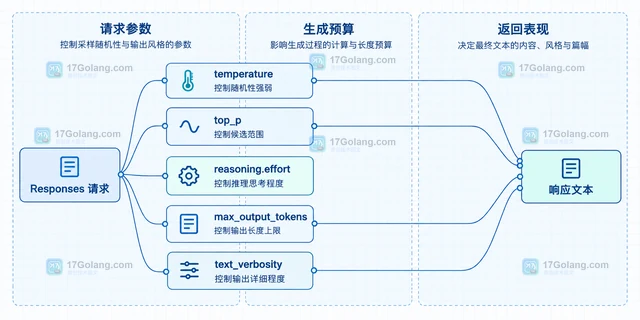
OpenAI API 中 top_p 直接影响候选概率范围,reasoning.effort 与 max_output_tokens 分别控制推理投入和输出预算。本文用 Responses API 示例说明如何区分职责并避免同时调 temperature 与 top_p。
-
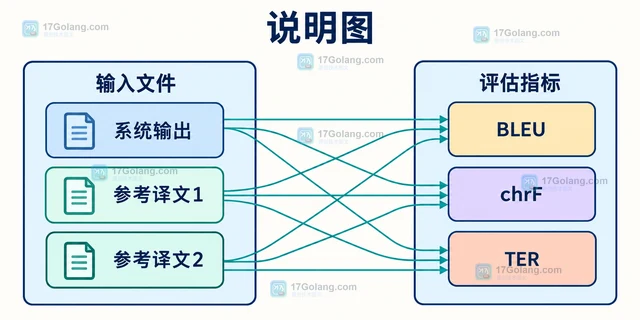
SacreBLEU 评估同一批机器翻译输出时,可以把多条参考译文作为多个位置参数传入,也可以按行合并为制表符文件并使用 --num-refs 声明参考数量。本文说明两种输入维度、常见误区和 BLEU、chrF、TER 的选择。
-
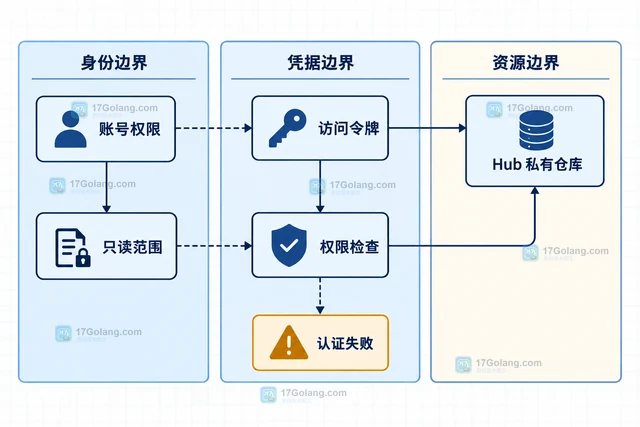
访问 Hugging Face Hub 私有模型时,关键不是把 token 写进 from_pretrained,而是先确认仓库权限,再用最小权限令牌登录,并通过环境变量或 huggingface_hub 的安全入口传递凭据。
-
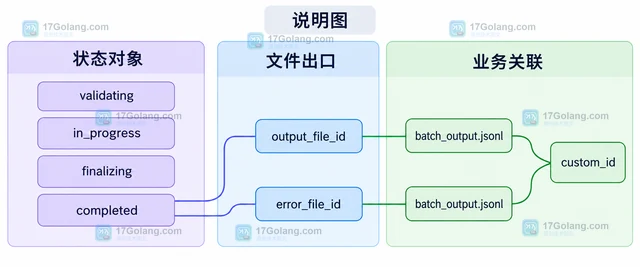
用 JSONL 准备请求,上传为 Batch 输入文件,再通过 input_file_id 创建 24 小时完成窗口的离线任务,并按 output_file_id 取回结果。
-
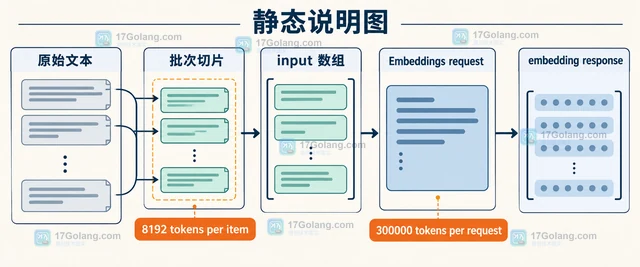
OpenAI Embeddings 支持在一次请求中传入多条文本。本文用 Python 组织可控批次,说明单条输入、整批 token、返回 index、失败重试和 dimensions 的边界。
-
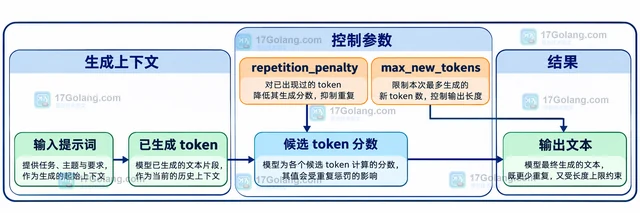
Transformers 的 repetition_penalty 用于调节已经出现过的 token 的生成倾向。本文从固定输出长度开始,给出逐步调参、GenerationConfig 配置和与 no_repeat_ngram_size、采样参数的边界,避免惩罚过高导致关键词丢失。
-
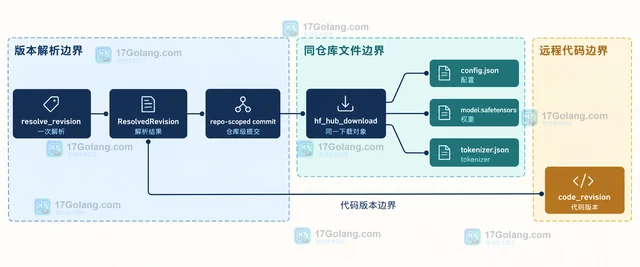
Hugging Face Hub 的 revision 可以指向分支、标签或提交版本。本文从单文件、整仓库和 Transformers 加载三种场景说明怎样固定模型版本,并用 resolve_revision 解决多组件下载时版本漂移的问题。
-
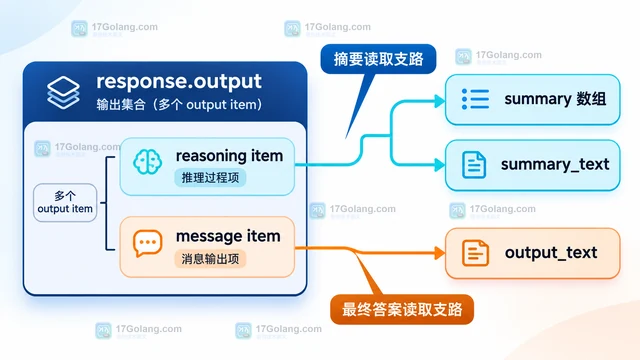
Responses API 不会默认返回 reasoning summary。本文用 reasoning.summary 开启摘要,遍历 reasoning output item 读取 summary_text,并说明 effort、output_text 与模型支持差异。
-
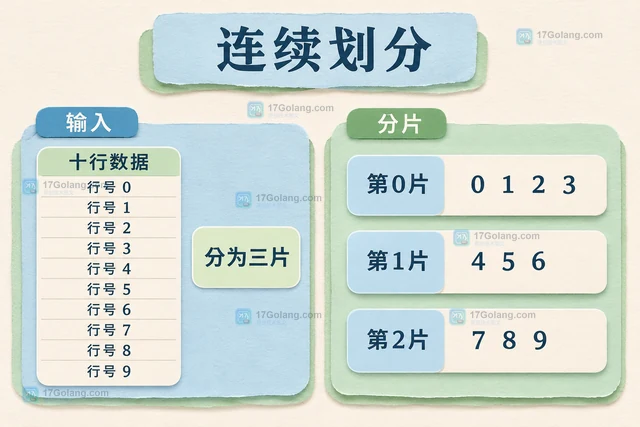
比较 Hugging Face Dataset 连续分片与交错分片的行号分配,说明分块处理、原序合并及流式接口的差异。
-
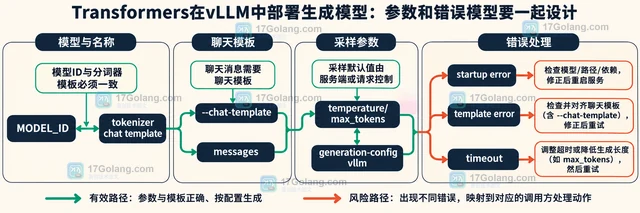
本文说明如何把 Hugging Face Transformers 模型交给 vLLM 启动为生成服务,并用 OpenAI 兼容接口调用,同时处理 chat template、模型名、采样参数和错误边界。
