-
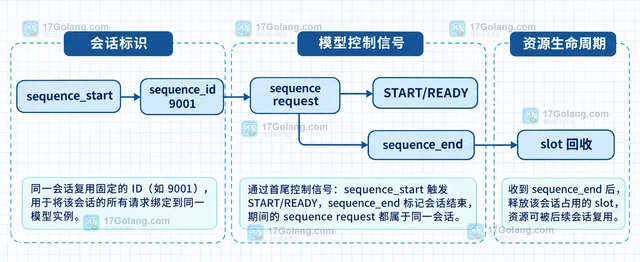
本文围绕 Triton sequence batcher 的 direct scheduling,说明 sequence_id、模型实例、batch slot 和 sequence 控制信号如何配合,让同一会话持续落到同一有状态模型实例;同时区分 direct 与 oldest 策略中 correlation ID 的职责。
-
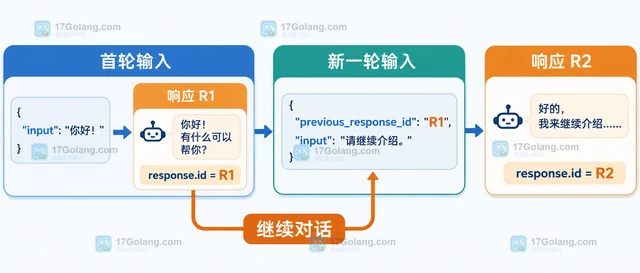
Responses API 可以通过保存上一轮 response.id,并在下一次请求中传入 previous_response_id 来继续多轮对话。本文用 Python 说明响应链、input 历史、store 与 conversation 的边界。
-
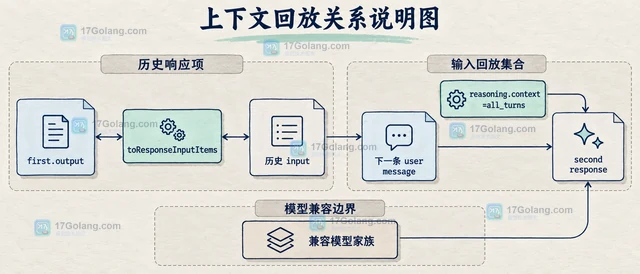
Responses API 在 store=false 或零数据保留场景下仍可延续推理上下文。本文说明如何原样保留 reasoning output item、回放 encrypted_content,并处理 all_turns、模型家族和数据边界。
-
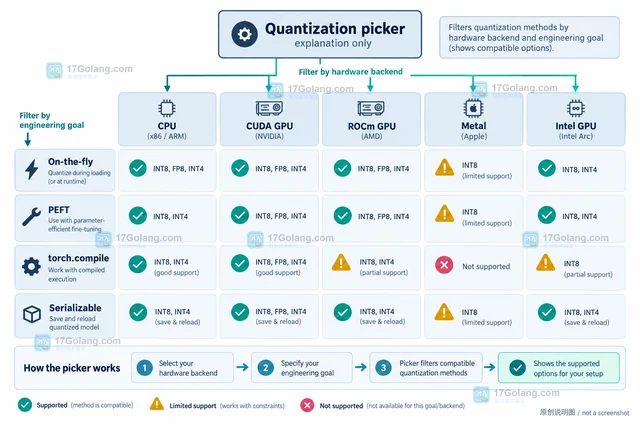
Transformers quantization picker 不是按 4-bit 或 8-bit 盲选,而是结合硬件后端、显存、KV cache、在线量化、PEFT 和编译目标筛出可行方法。本文给出一套按硬件落地的选择步骤与最小验证代码。
-
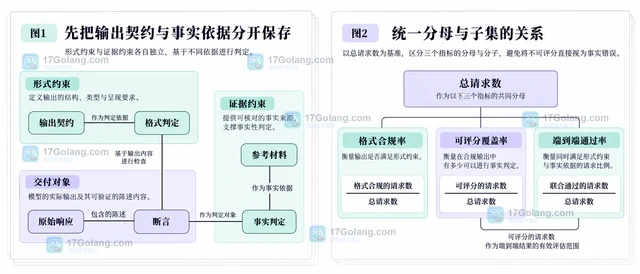
AI评估应分别记录事实依据与格式合规。本文用同一组示例说明断言支持、字段约束、不可评分项及报告分母,避免用格式正确代替事实正确。
-
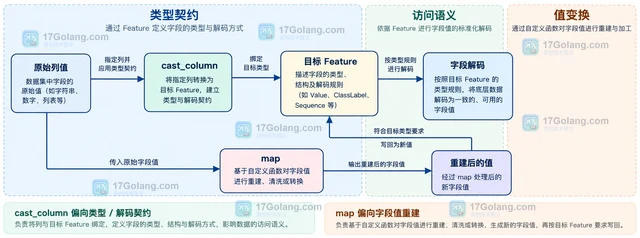
本文围绕 Hugging Face Datasets 的 cast_column,说明如何查看 features、把列映射到目标 Feature,以及何时应该改用 map 重建字段值。
-
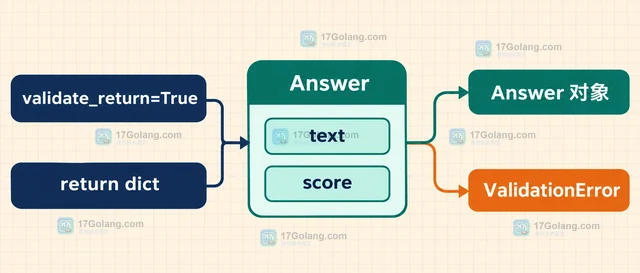
Pydantic validate_call 默认只处理函数参数,返回值需要显式开启 validate_return=True。本文用一个返回模型示例拆清两条校验链,并说明性能与接入边界。
-
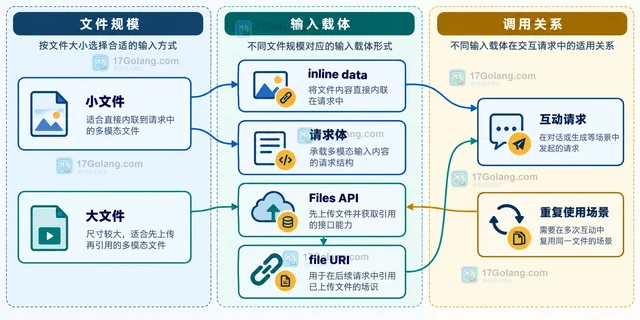
处理图片、音频、视频和 PDF 时,先把文件转换成可信的 MIME 类型,再映射到 image、audio、video 或 document 内容对象;小文件单次调用可用内联数据,较大或需要复用的文件应使用 Files API。本文用一套路由层说明输入对象、PDF 边界和文件 URI 的选择。
-
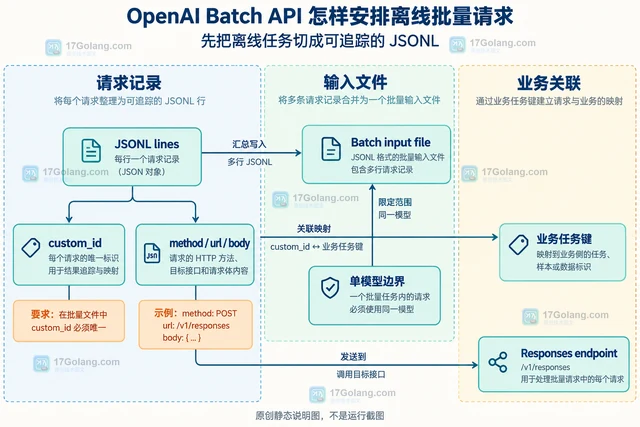
OpenAI Batch API 适合不要求即时返回的批量任务。本文用 JSONL、Files API 和 Python SDK 说明如何创建 24 小时批次,按 custom_id 回填结果,并处理 failed、expired、文件大小和单模型边界。
-
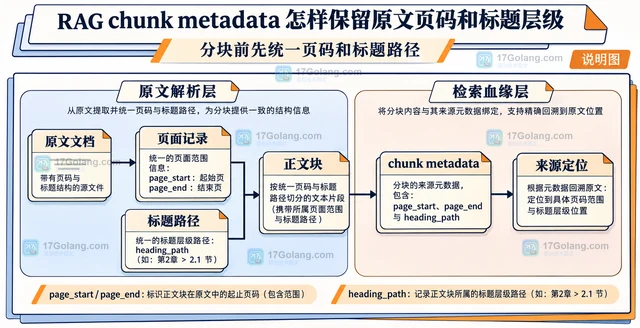
RAG 召回结果如果只有文档名,读者很难回到原文位置。本文用 page_start、page_end、heading_path 等 chunk metadata 记录页码范围和标题层级,并说明如何在分块时复制标题栈、召回后格式化来源,以及如何区分文件级 attributes 与片段级血缘字段。
-
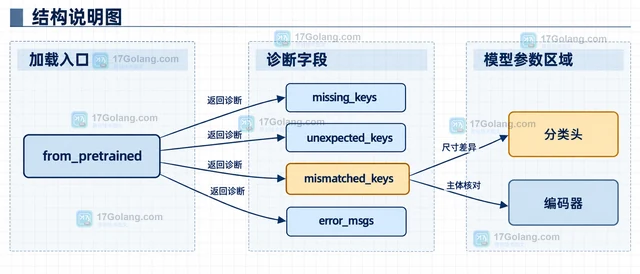
Hugging Face Transformers 加载分类模型时,如果新任务的标签数量与 checkpoint 不同,可以用 ignore_mismatched_sizes 处理分类头尺寸差异。本文说明参数边界、加载诊断和不能直接忽略的结构问题。
-
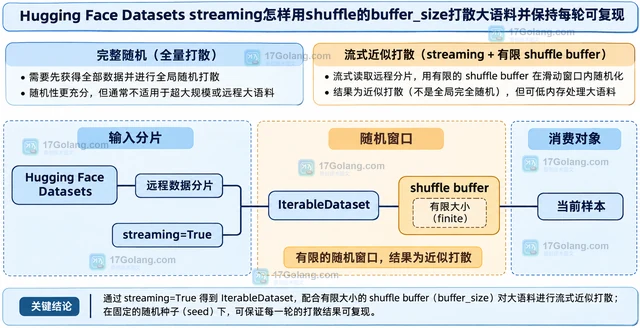
Hugging Face Datasets 的 IterableDataset.shuffle 使用有限缓冲区近似打散流式语料。本文说明 buffer_size、seed、shuffle 顺序与 set_epoch 的关系,帮助你在多轮读取中保持可复现而不误解随机范围。
-
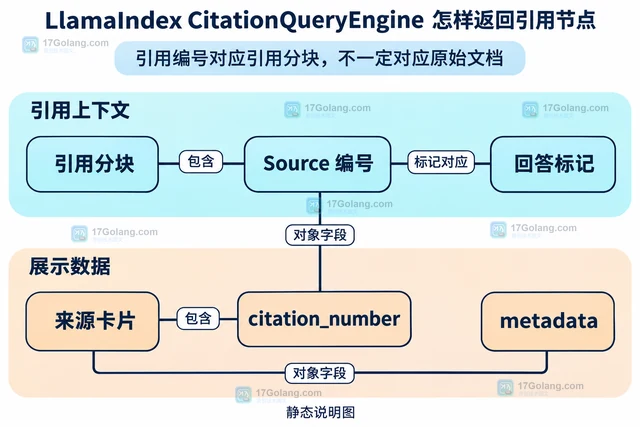
保留 CitationQueryEngine 的响应对象即可读取 source_nodes。通过示例整理引用节点、编号和来源卡片,说明分块粒度、元数据缺失、响应类型与前端展示的适用边界。
-
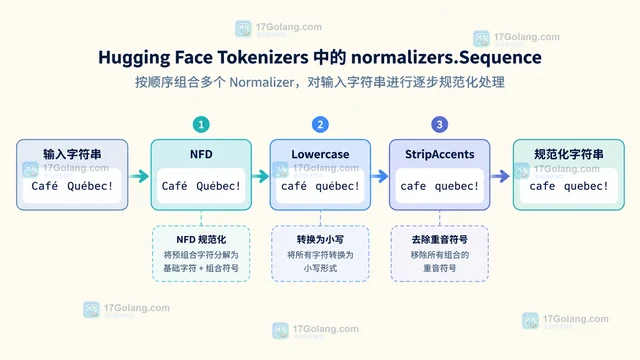
Hugging Face Tokenizers 的 normalizers.Sequence 会按列表顺序串联多个规范化规则。本文用 NFD、Lowercase 和 StripAccents 组成可读的处理链,说明如何先观察 normalize_str 的结果,再挂到 Tokenizer,并梳理顺序、空链和训练一致性的边界。
-
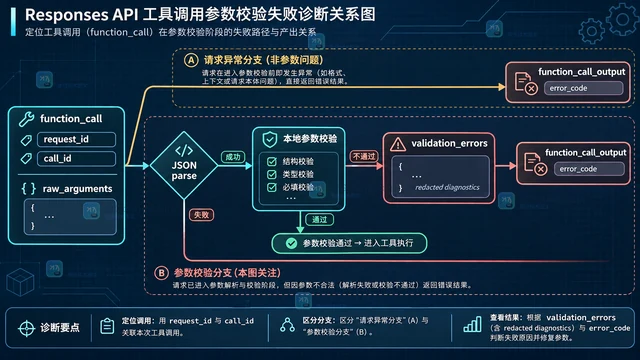
用一个 Python 最小示例拆开 Responses API 工具调用的 schema 拒绝、参数 JSON 解析和本地校验失败,保留 request_id、call_id 与脱敏诊断,并说明严格模式的边界。
