
人工智能技术文章
-
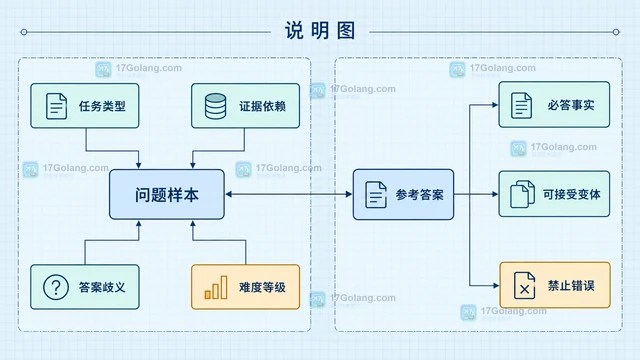 生成式问答评测集不应只保留一个总分。本文从样本标签、参考答案和指标三处说明如何把简单题、边界题与高难题分开统计,保留旧分数的同时增加难例回归信号,让模型版本变化更容易解释。167 收藏
-
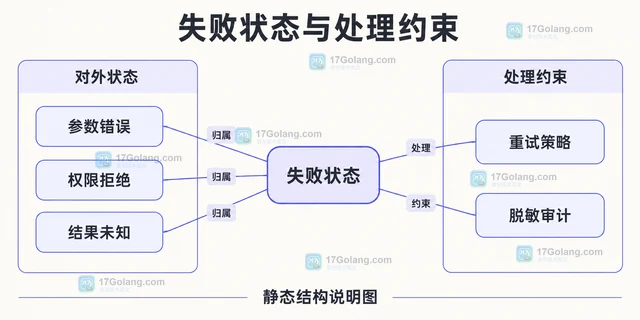 AI Agent工具调用不能把schema通过当作授权通过。本文以工单查询的假设故障区分输入契约、业务约束、可信身份与失败返回,说明权限拒绝、重试和结果未知的处理边界。349 收藏
-
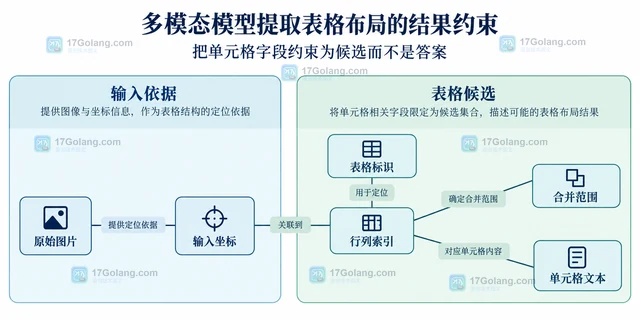 多模态模型提取表格布局需固定行列索引、合并范围与坐标含义,通过字段约束暴露结构冲突,并保留不确定内容与人工复核记录,避免把格式正确当成识别正确。359 收藏
-
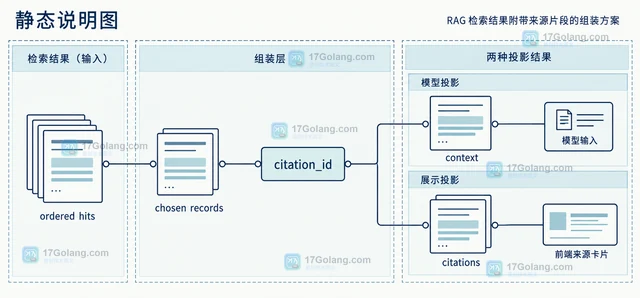 RAG 不要只把命中的文本拼成一段 prompt。本文用统一的切片记录保存来源标识、定位信息和分数,再分别投影为模型上下文与前端引用,处理去重、排序、截断和元数据缺失。407 收藏
-
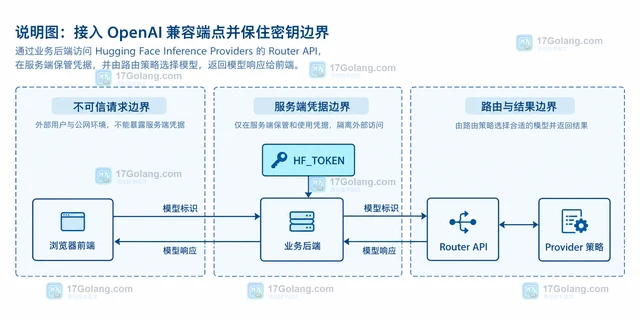 用一个最小 Python 项目讲清 Hugging Face Inference Providers 的统一 API、Provider 选择和 Token 边界。292 收藏
-
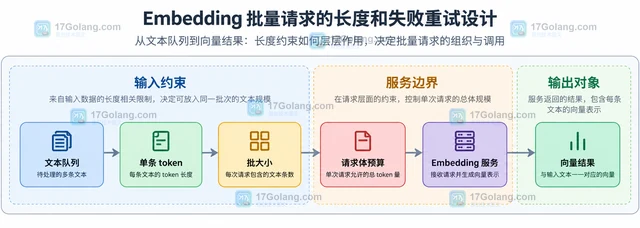 从批大小、单条长度和整批预算三个维度拆分 Embedding 请求,并用有限指数退避处理超时、限流等可恢复失败,避免部分成功后的结果错位。383 收藏
-
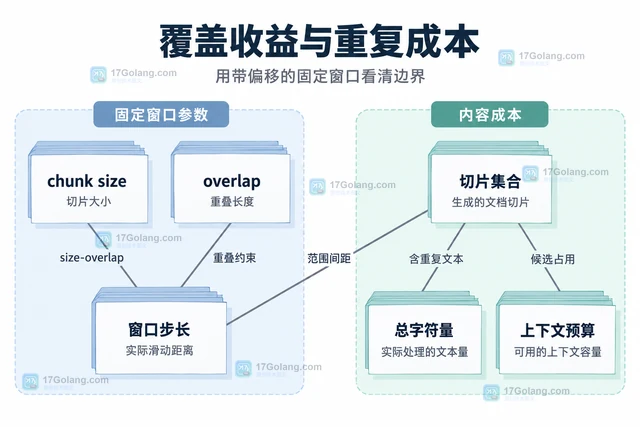 RAG 切片的 overlap 应结合统一计量单位、跨边界证据与重复上下文成本决定。本文用保留原文偏移的字符窗口示例解释边界覆盖,并区分目标重叠、实际切片和检索命中,避免套用通用最佳比例。278 收藏
-
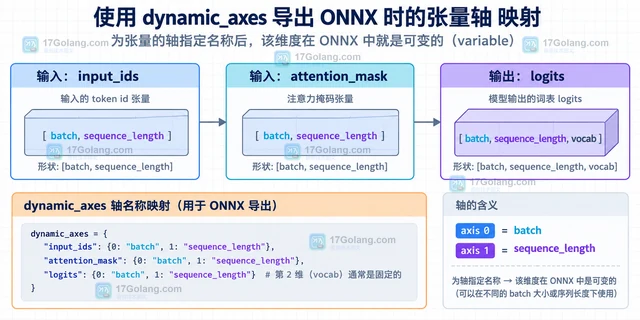 本文围绕 PyTorch ONNX 导出的 dynamic_axes,说明如何为文本模型声明动态 batch 和序列长度,解释输入输出轴对齐,并区分传统导出路径与新 dynamo 导出器的 dynamic_shapes。131 收藏
-
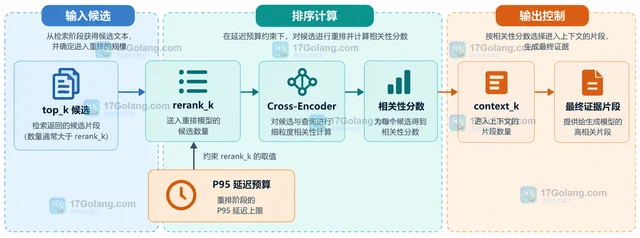 拆分 RAG 的 top_k、rerank_k 与 context_k,说明如何用候选覆盖率、重排延迟、来源去重和上下文预算逐步确定参数。491 收藏
-
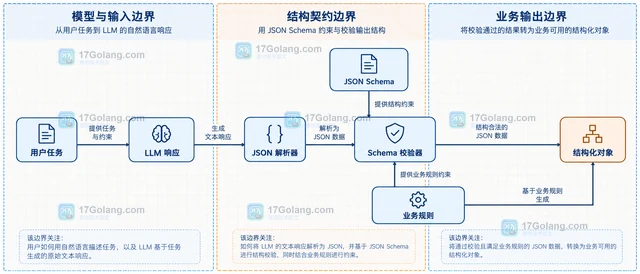 把 LLM 结构化输出拆成 JSON 解析、Schema 校验和业务规则三层,只对可定位的格式错误做有限修复,并用固定预算避免无限重试。187 收藏
-
科技周边 · 人工智能 | 3星期前 | LoRa PEFT adapter save_pretrained adapter_model.safetensors selected_adapters save_embedding_layers
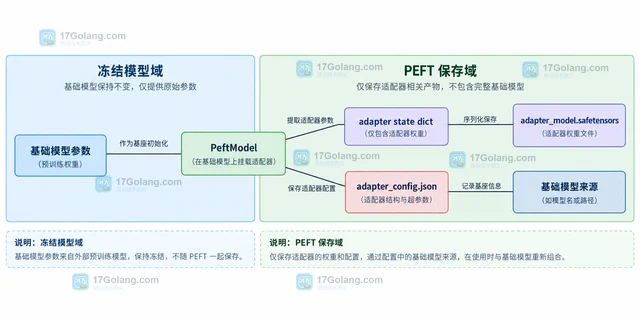 PEFT 的 save_pretrained 默认只保存 adapter 配置和增量权重,不会把冻结的基础模型一起复制。本文说明多 adapter 的 selected_adapters、embedding 层保存开关、重新加载边界,以及 Trainer checkpoint 与完整模型的区别。483 收藏
-
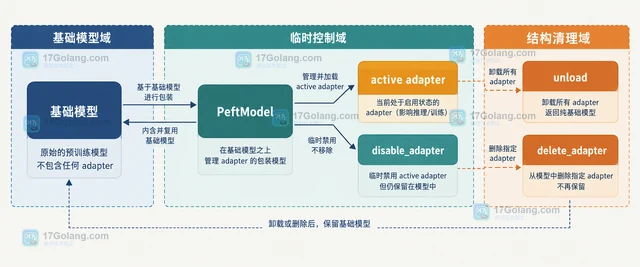 PEFT 中临时禁用 adapter、移除 LoRA 模块、删除命名 adapter 和合并权重是四种不同操作。本文用 unload 返回基础模型,说明为什么必须接住返回值,并整理多 adapter 与 Notebook 重跑时的排查边界。485 收藏
-
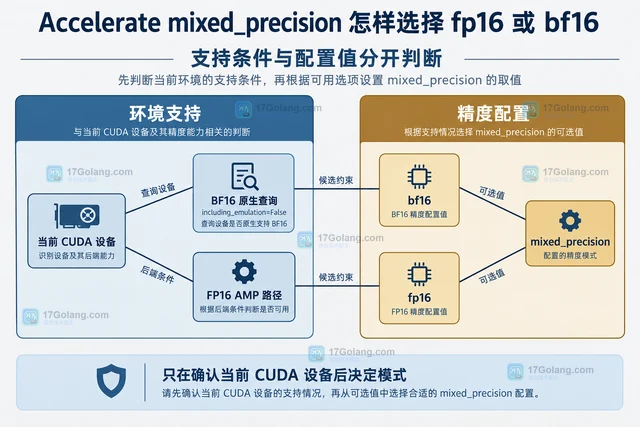 Accelerate 的 fp16 与 bf16 应按当前设备支持和模型数值行为选择。本文限定普通单卡 CUDA 场景,说明保守 BF16 查询、完整参数接入、梯度缩放与 no 模式对照,不以启动成功代替训练稳定性判断。386 收藏
-
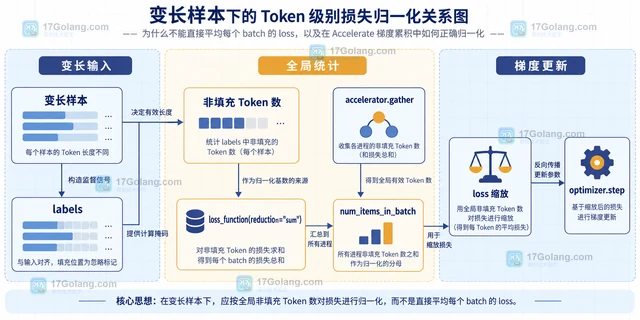 显存有限时,Accelerate 可以用 gradient_accumulation_steps 把多个 micro-batch 合成一次参数更新。本文说明 Accelerator、accumulate(model)、scheduler 与变长 token loss 归一化的配置边界。356 收藏
-
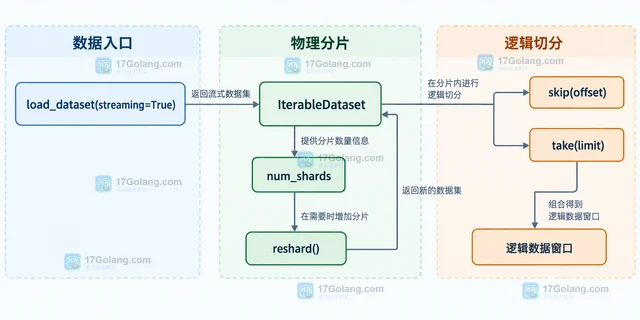 Hugging Face Datasets 的 IterableDataset 如果 reshard 后仍只有一个 shard,继续调用物理分片并不能解决切分问题。正确做法是先完成 shuffle,再用 skip 和 take 构造逻辑窗口,并明确 offset、limit、短流和重复遍历的边界。441 收藏