
人工智能技术文章
-
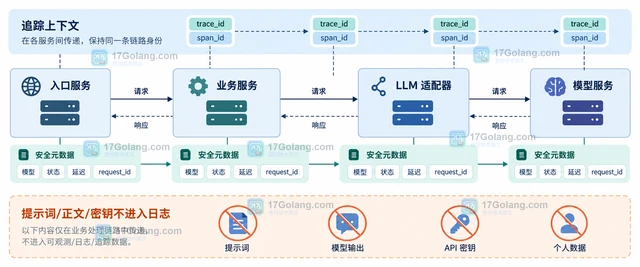 LLM 请求经过多个服务后,怎样把 trace_id、模型、状态、延迟和 token usage 归到同一次调用?本文用 Go 设计一个不记录提示词与密钥的观测链路,演示 span、context、统一 usage 结构和结构化日志的落地方式。296 收藏
-
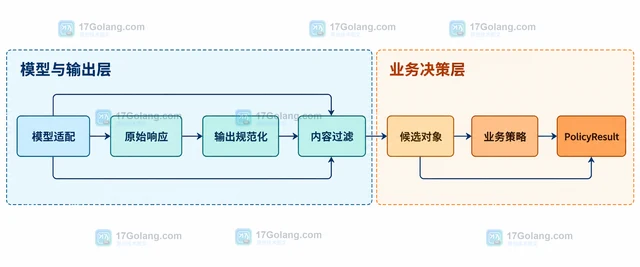 把模型输出规范化、内容过滤和业务授权拆成独立边界,用统一的 allow、deny、review 结果和原因码减少误判、重试与审计混乱。317 收藏
-
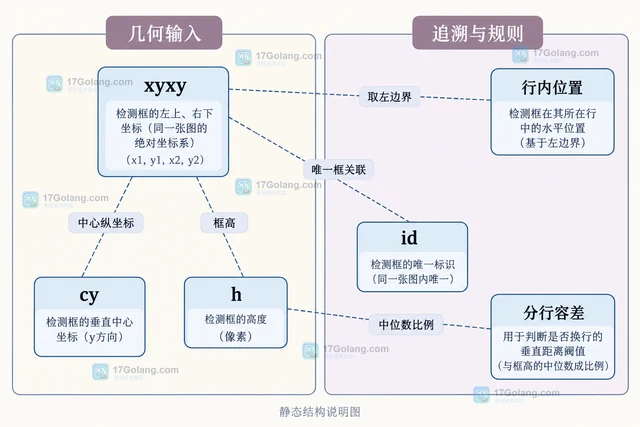 面向单栏横排文本,统一检测框坐标,以固定行锚点分行并在行内按横坐标排序。提供 Python 示例,说明坐标抖动、稳定 ID、多栏与复杂版面的适用边界。375 收藏
-
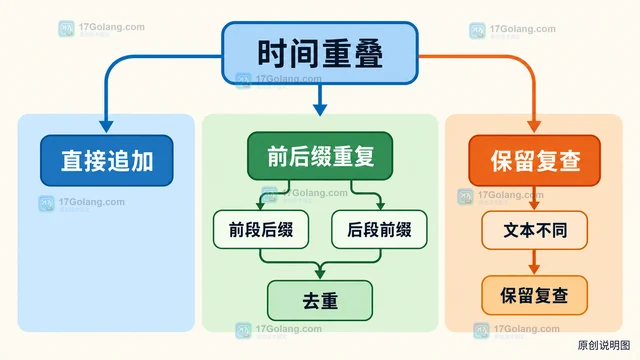 语音识别返回的分段不能直接按数组顺序相连。本文从时间排序、间隔判断、重叠去重和边界复查四步说明怎样把带时间戳的 ASR 结果拼回完整文本,并给出可调整的 Python 示例。216 收藏
-
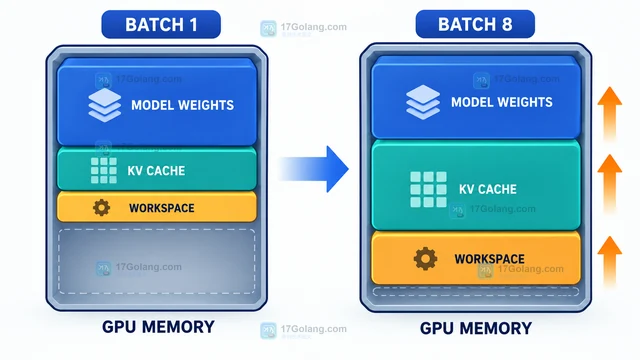 从显存预算、KV cache、padding、吞吐和 P95 延迟出发,说明 LLM 推理怎样逐级压测 batch size,并找到可回滚的安全工作点。174 收藏
-
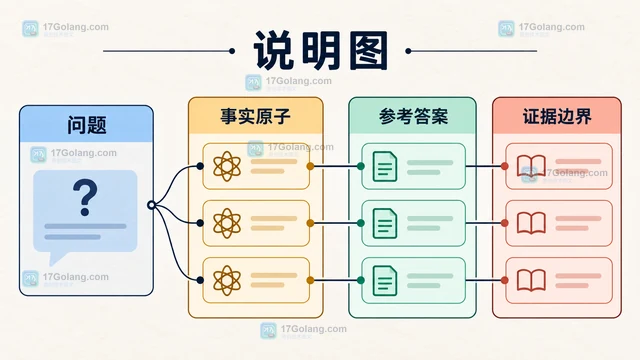 生成式回答的事实性评测不能只准备一组问题和一个总分。本文从样本边界、参考答案、事实原子、支持与矛盾判分以及人工复核五个方面,设计一套可比较的对照样本结构。144 收藏
-
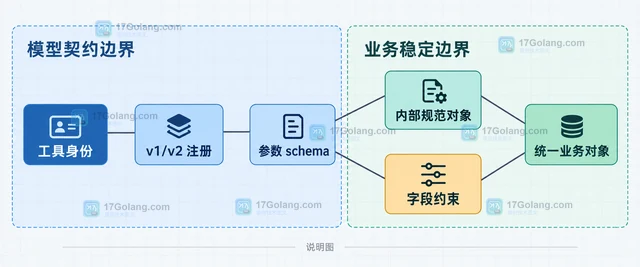 AI 工具的函数参数 schema 不应靠改描述文本维持兼容。本文用 strict schema 的可空字段、v1/v2 工具身份和服务端适配器,说明如何处理新增参数、字段改名、类型变化与调用方迁移,并给出可观察的下线指标。391 收藏
-
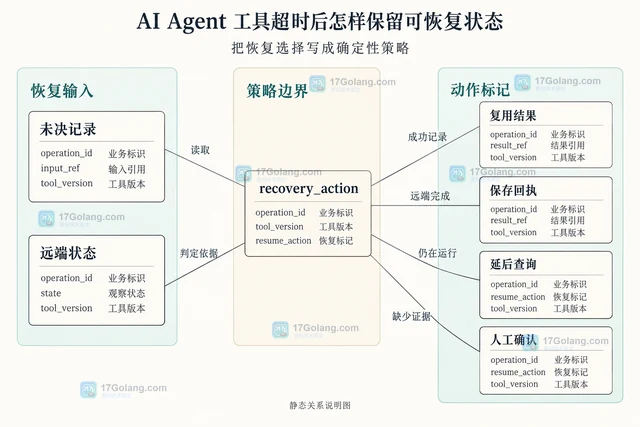 AI Agent 工具超时不等于远端失败。通过稳定业务标识、未决调用记录、结果引用和恢复标记,在重启后优先查询或人工确认,避免重复副作用。199 收藏
-
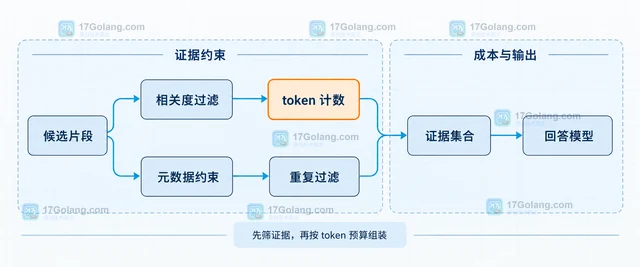 RAG 的 top-k 不是越大越好。本文用候选召回、相关度过滤、片段去重和 token 预算拆解如何稳定组装上下文。133 收藏
-
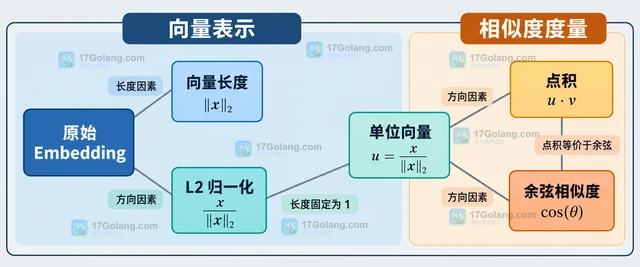 Embedding 做 L2 归一化后,向量长度不再参与点积排序,点积可以等价于余弦相似度。本文从公式、Sentence Transformers 用法和检索场景说明何时归一化,以及混用不同分数的风险。144 收藏
-
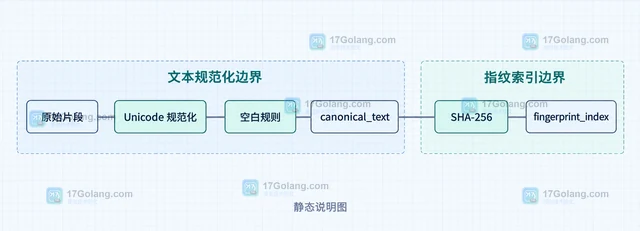 RAG 入库前先做内容指纹,可以在向量化之前拦截完全重复片段,减少重复检索和上下文浪费。本文用 Python 演示文本规范化、SHA-256 指纹、元数据合并,以及近重复候选的处理边界。349 收藏
-
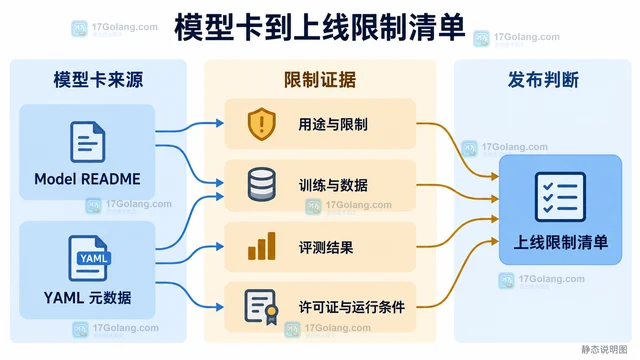 模型卡不是模型宣传页,而是上线前整理适用范围、潜在限制、数据与评测证据的入口。本文把 Hugging Face 模型卡字段整理成限制清单,并给出缺失字段的记录方式。318 收藏
-
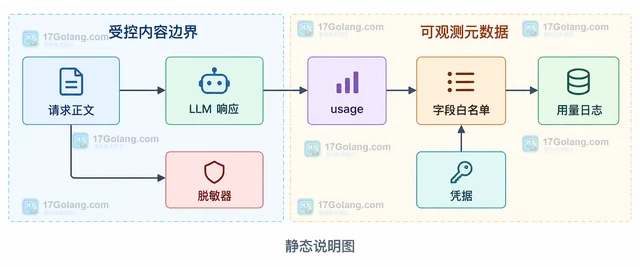 LLM 可观测性不等于把 prompt 和回答原文写进日志。本文以 OpenAI 兼容的 Chat Completion 响应为例,说明怎样记录 prompt_tokens、completion_tokens、total_tokens 等用量元数据,并在应用边界完成字段白名单、敏感信息脱敏和流式 usage 处理。413 收藏
-
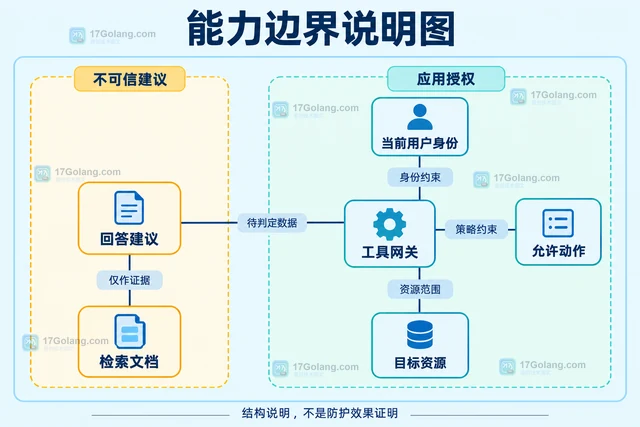 RAG检索片段应保持为不可信证据,而不是新的控制指令。本文讨论上下文分区、只读抽取和应用侧权限判定的取舍,说明提示词与摘要的局限,以及正常引用、过度拒绝和越权风险应分开观察。390 收藏
-
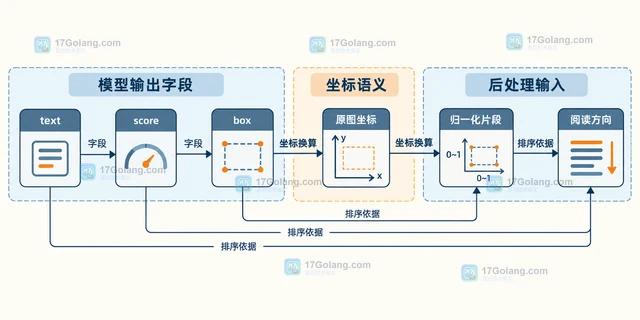 视觉模型返回的 OCR 片段常常不是阅读顺序。本文用统一坐标、垂直中心排序、动态行高阈值和行内 x 排序,把文字框稳定合并成可读文本,并说明多栏、竖排和低置信度结果的边界。461 收藏