
人工智能技术文章
-
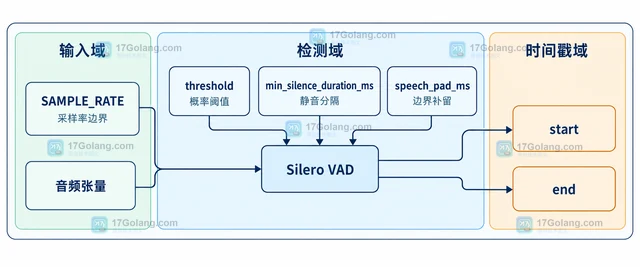 介绍语音转写前用 VAD 检测语音区间的方法,说明采样率、阈值、静音时长、边界 padding 和原始时间偏移如何配合,避免切掉词头词尾或让字幕时间轴失真。371 收藏
-
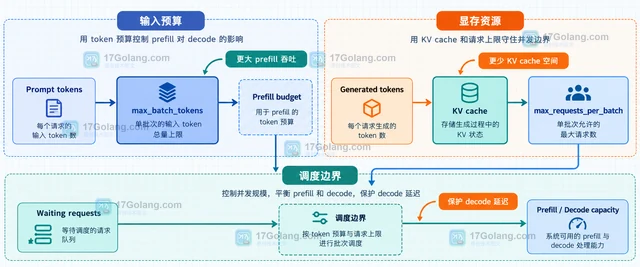 连续批处理会同时影响推理吞吐与首 token 延迟。本文从 TTFT 分解、prefill token 预算、KV cache、调度策略和分位数指标入手,说明怎样按负载逐步调参。262 收藏
-
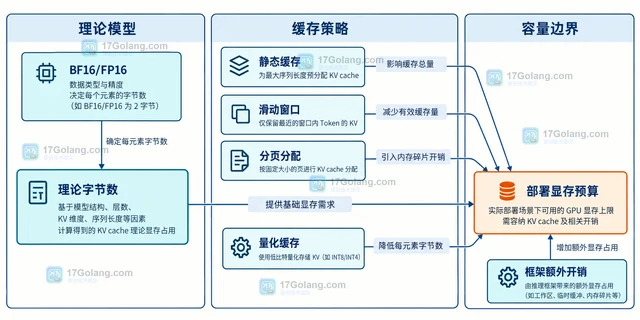 LLM 推理时,KV cache 显存主要随 batch、层数、KV 头数、head_dim、上下文 token 数和缓存精度线性增长。本文给出可手算的公式,用 GQA 示例比较 BF16 与 FP16,并说明静态缓存、滑动窗口、分页分配和量化缓存带来的实际差异。158 收藏
-
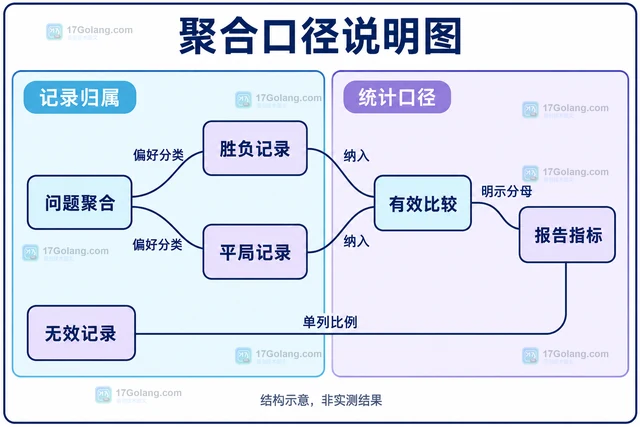 生成式回答成对评测应固定任务、隐藏系统身份并平衡展示位置。本文设计样本与偏好记录,区分平局、双差和无效票,用手算示例解释三种胜负口径,并说明按问题聚合和任务分层报告的边界。199 收藏
-
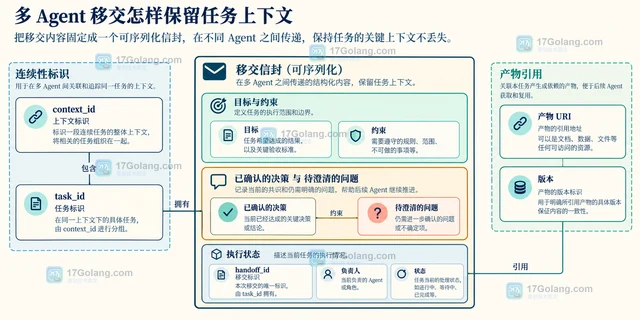 多 Agent 系统移交失败,通常不是模型不会推理,而是接手方没有拿到结构化目标、约束、已确认决定和当前产物。本文用移交信封、contextId/taskId 分层、上下文裁剪、版本与回滚说明怎样保留真正有用的任务上下文。119 收藏
-
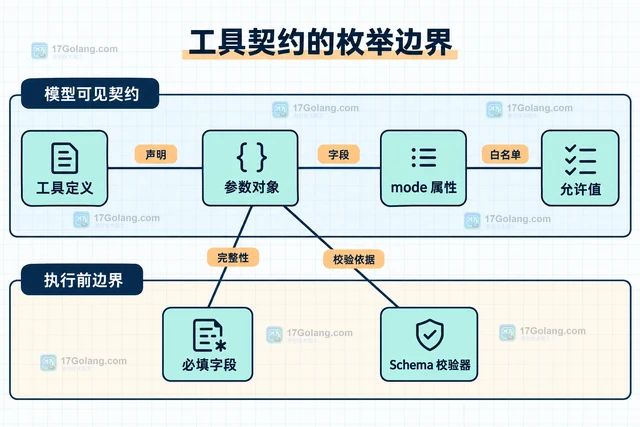 AI 工具调用参数只允许固定集合时,应在 JSON Schema 中使用 enum,并在真实工具执行前再次校验。本文用一个报告工具说明枚举契约、非法参数拒绝、错误分类、重试边界和版本兼容策略。147 收藏
-
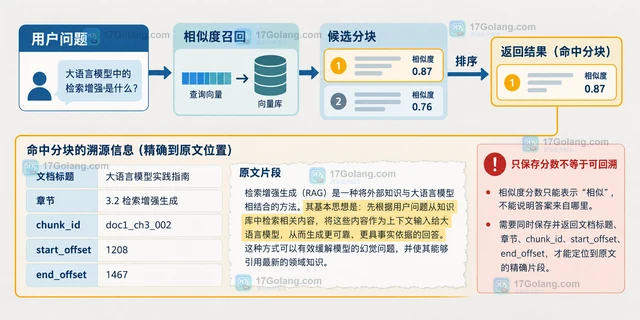 Embedding 结果不能只保存向量和相似度。本文用一份最小元数据结构,把文档版本、分块编号、字符起止位置与向量绑定,说明召回后如何回读原文,并处理文档更新导致的偏移失效。219 收藏
-
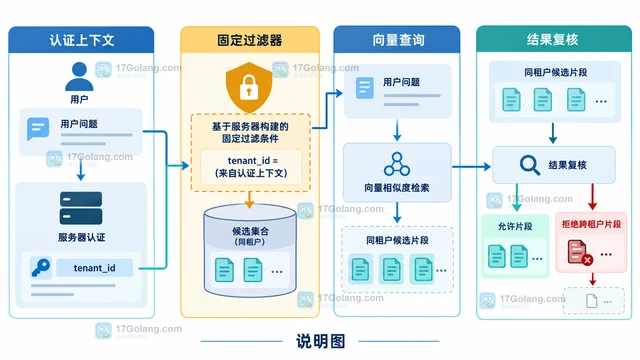 多租户 RAG 不能只在召回后过滤。本文从元数据设计、租户过滤器构造、向量检索和结果复核四个环节,给出一套可迁移的隔离实现方法。433 收藏
-
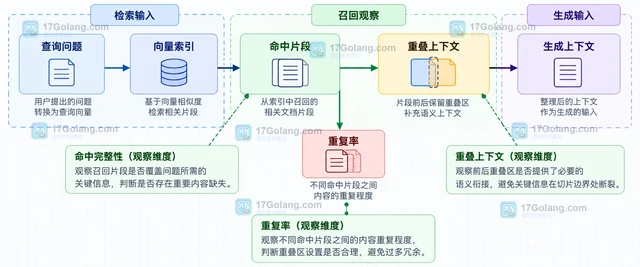 从切片边界、chunk_size 和 chunk_overlap 三个角度说明 RAG 文档怎样减少语义断裂,并给出按结构切分、按比例设置重叠区和观察召回结果的实用方法。297 收藏
-
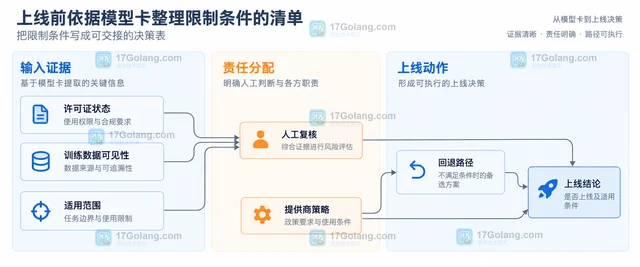 上线 AI 模型前不要只看评测分数。本文围绕模型卡中的许可证、训练数据说明和适用范围,整理一份可交接的限制条件清单,并说明如何把缺失信息、人工兜底和提供商选择写进发布决策。408 收藏
-
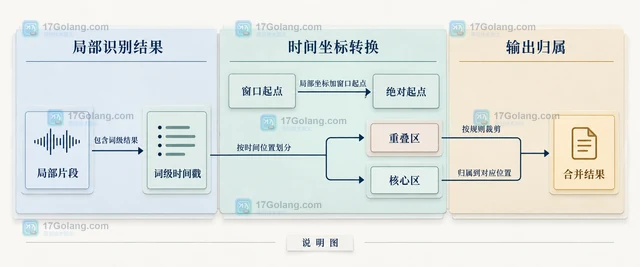 围绕固定窗口、重叠区和绝对时间线,说明长音频语音转文字如何保留边界语音、裁剪重复文本并合并时间戳。324 收藏
-
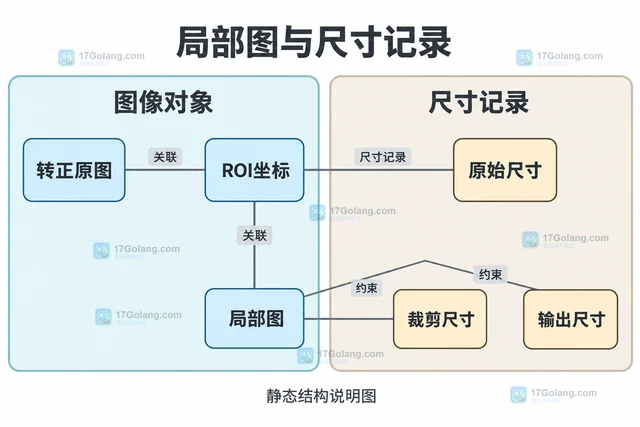 视觉模型图片预处理需兼顾长宽比、裁剪范围和细节保留。本文用Pillow函数示例说明转正、只缩不放大与ROI尺寸记录,并区分业务图片准备和模型processor要求。261 收藏
-
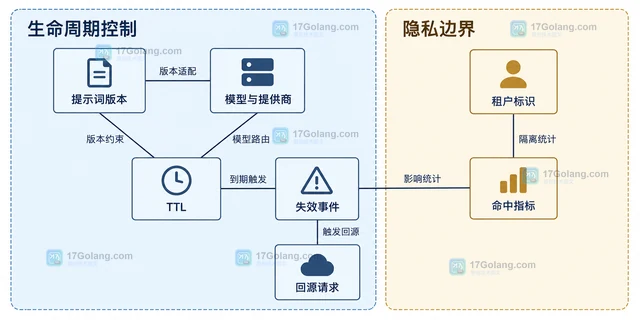 围绕稳定前缀、动态变量、失效策略和租户隔离,说明提示词缓存怎样减少重复上下文开销,以及缓存未命中时如何分层排查。263 收藏
-
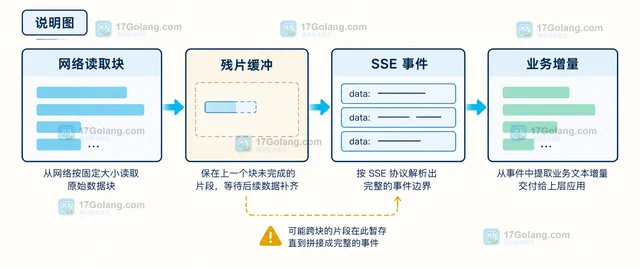 从网络分片、SSE 事件到业务增量,拆解流式生成接口的文本拼接策略,覆盖断线、取消、错误和最终结束状态的处理边界。237 收藏
-
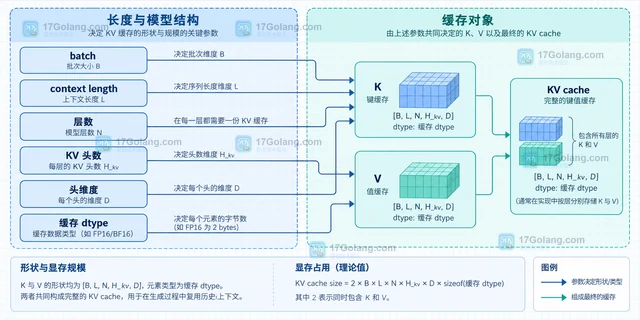 本地部署量化模型时,显存不只由模型参数量决定。本文用权重位宽、上下文长度、KV cache 和运行时余量拆出一套可复用的估算方法,帮助判断量化档位与单卡显存是否匹配。501 收藏