
人工智能技术文章
-
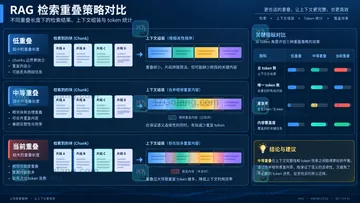 RAG 文档切片的 overlap 过大,会让相邻片段重复进入上下文,增加索引和推理成本。本文给出重叠比例、配置调整和验证指标。238 收藏
-
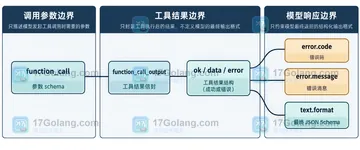 Responses API 的结构化输出不会自动校验工具返回值。本文用统一错误信封、function_call_output 和严格 JSON Schema 保留错误码、消息与可重试标记,并说明为什么还要保存原始工具结果。111 收藏
-
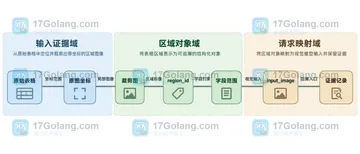 介绍视觉模型读取表格图片时的区域化证据链:用稳定 region_id 组织裁剪图和字段范围,结合多图输入与 JSON Schema 保存可回溯的字段证据,并处理成本、空值和跨页边界。312 收藏
-
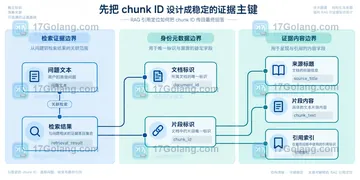 RAG 中不要让模型猜来源。给每个检索片段保留稳定 chunk_id,让模型返回可校验的 citations,再由应用层回填标题、页码和原文位置。111 收藏
-
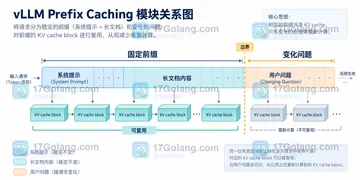 vLLM Prefix Caching 适合重复长前缀、长文档和多轮会话,但收益集中在 prefill。本文从前缀稳定性、开启配置、测量方法、缓存容量和多租户隔离几个方面判断是否值得使用。356 收藏
-
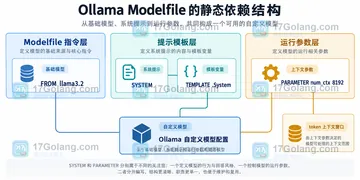 用 Ollama Modelfile 固化 SYSTEM 系统提示和 num_ctx 上下文长度,说明 ollama create、ollama show、ollama ps 的配合方式,以及服务环境和客户端覆盖配置的排查思路。403 收藏
-
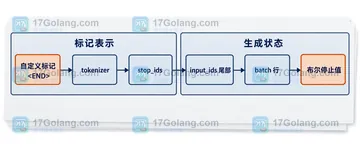 在 Transformers generate 中自定义 StoppingCriteria,用 tokenizer 生成的 token 序列匹配
等标记,并处理批量生成、提示词误匹配和兜底长度限制。 120 收藏 -
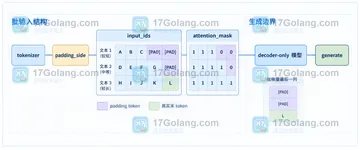 Transformers 批量生成时,padding_side 配错会让 decoder-only 模型把补齐 token 当成生成起点。本文用 input_ids、attention_mask 和 generate 的关系说明 left padding 的配置方法、pad_token 处理与回归检查边界。457 收藏
-
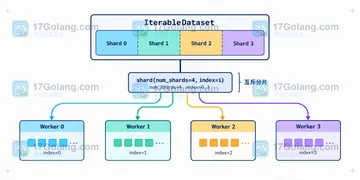 Hugging Face Datasets 开启 streaming 后会返回 IterableDataset。本文用 take、skip 和 shard 解释连续取样、并行分片的差异,以及 shuffle 顺序和性能边界。449 收藏
-
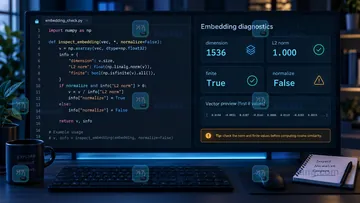 余弦相似度异常,先别急着改阈值。本文用一段最小 Python 配方检查 Embedding 的维度、L2 范数、归一化、点积和向量库距离配置,帮助定位分数漂移的真正环节。383 收藏
-
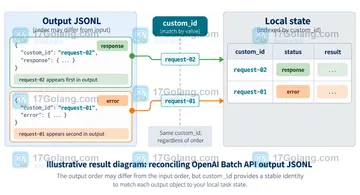 OpenAI Batch API 的输出顺序不保证与输入一致,custom_id 才是回配原始请求的稳定关联键。本文用 JSONL、成功结果、错误结果和重试设计说明如何可靠映射批量任务。105 收藏
-
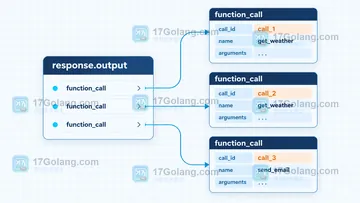 Responses API 一次返回多个 function_call 时,不要只处理第一项;保留完整 response.output,按每个 call_id 执行工具并逐条回传 function_call_output,才能避免结果串线。146 收藏
-
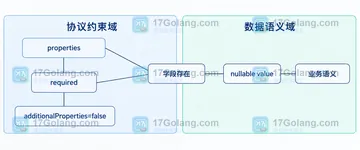 Structured Outputs 严格模式要求字段全部写入 required。本文用 required 加 null 类型表达可选语义,并说明嵌套对象、额外属性、拒答和不完整响应的兼容边界。281 收藏
-
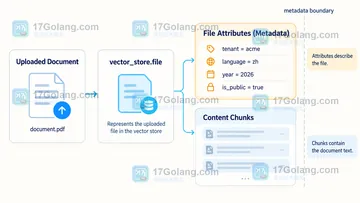 OpenAI File Search 可以在 vector store file 上写入 attributes,再用 file_search.filters 通过 eq、and、or、in 和数值范围条件缩小检索范围。本文用租户、语言和年份示例说明字段设计、复合过滤以及空结果排查。426 收藏
-
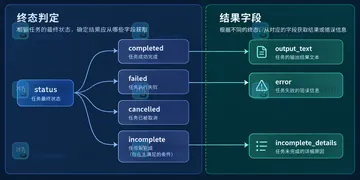 OpenAI Responses API 使用 background=true 后,先保存 response.id,再通过 Responses 取回接口轮询 queued 或 in_progress 状态;本文说明如何读取 output_text,并处理 failed、cancelled、incomplete 等终态。314 收藏