
人工智能技术文章
-
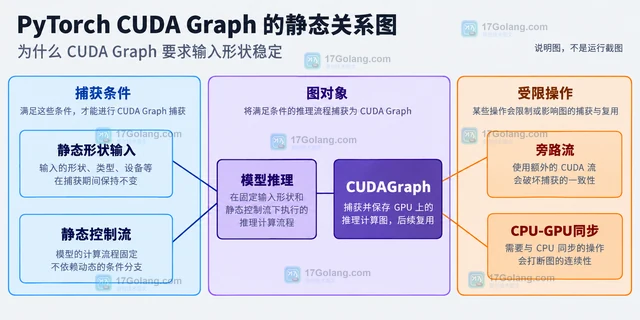 PyTorch CUDA Graph 适合重复执行、输入形状稳定且 CPU 调度开销明显的推理路径。本文用静态输入、旁路流预热、捕获和 replay 说明怎样固定形状复用流程,以及变长请求应该怎样分桶或回退。471 收藏
-
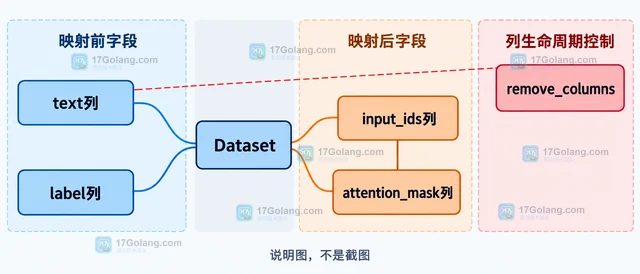 Hugging Face Datasets 的 map 在 batched=True 时按列传入一批样本。本文用一个可复用的 Python 示例说明怎样新增处理列、保留原始列,并用 remove_columns 控制最终字段。329 收藏
-
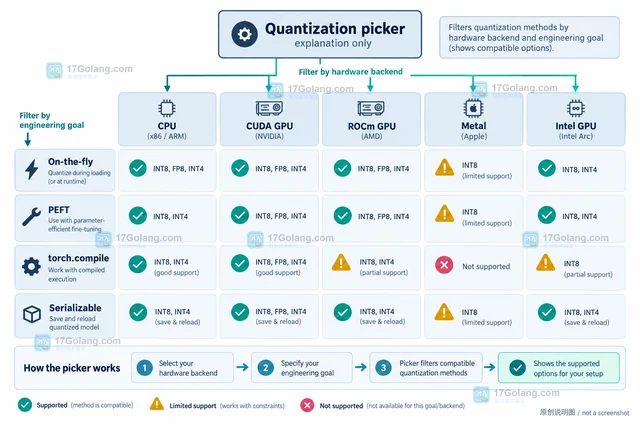 Transformers quantization picker 不是按 4-bit 或 8-bit 盲选,而是结合硬件后端、显存、KV cache、在线量化、PEFT 和编译目标筛出可行方法。本文给出一套按硬件落地的选择步骤与最小验证代码。120 收藏
-
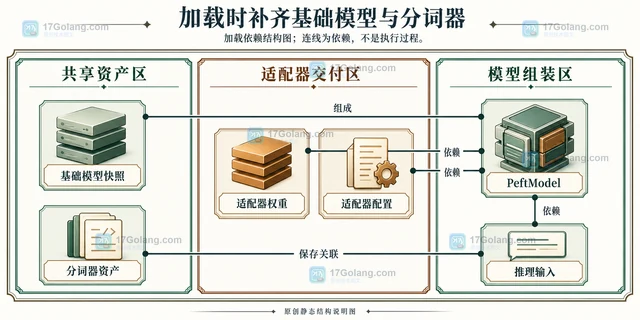 通过 PeftModel.save_pretrained 导出 LoRA 适配器,说明额外训练模块、嵌入层、基础模型依赖与训练断点的区别,并提供参数体积推算和文件统计写法。422 收藏
-
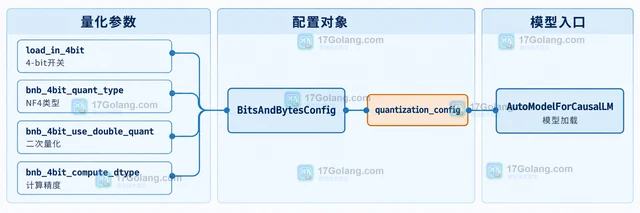 QLoRA 配置中,NF4 决定 4-bit 权重的数据类型,double quant 对量化常量再次量化,compute dtype 决定计算时使用的精度。本文用 BitsAndBytesConfig 给出一份适合 4-bit 训练的配置,并说明显存、训练和推理场景下的取舍。284 收藏
-
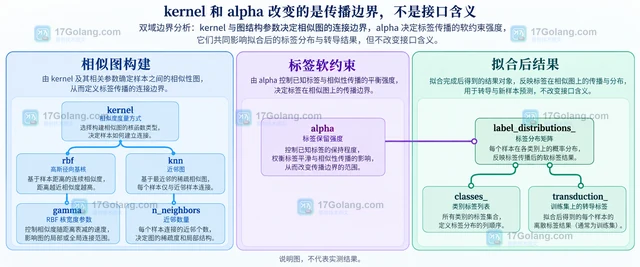 LabelSpreading 的 transduction_ 是 fit 阶段整张训练图上的传导标签,predict 与 predict_proba 则用于拟合后新样本的归纳式推断。本文按样本范围、接口、参数和上线检查清楚区分三者。467 收藏
-
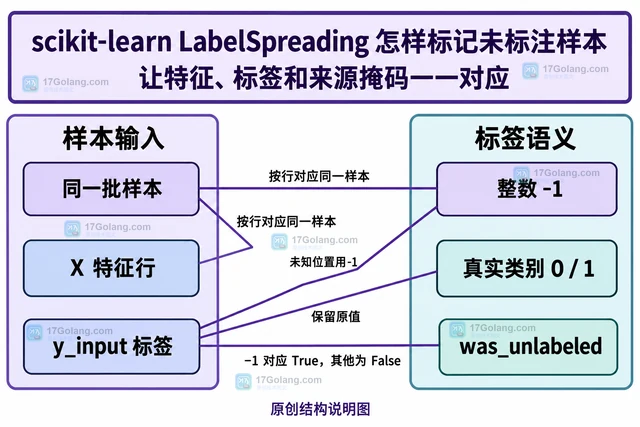 说明scikit-learn LabelSpreading用整数-1标记未标注样本,提供保留原标签与来源掩码的示例,并区分transduction_、类别分布和应用合并视图的含义。283 收藏
-
科技周边 · 人工智能 | 5天前 | 调试 · python · 人工智能 · start end span Spacy start_char end_char char_span 词元索引 字符偏移
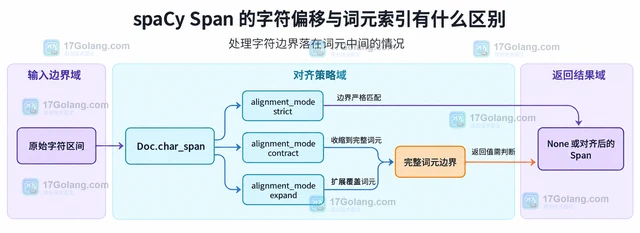 用最小例子区分 spaCy Span 的词元索引与字符偏移,说明 start/end、start_char/end_char 和 char_span 对齐模式在字符串切片与实体标注中的不同用途。287 收藏
-
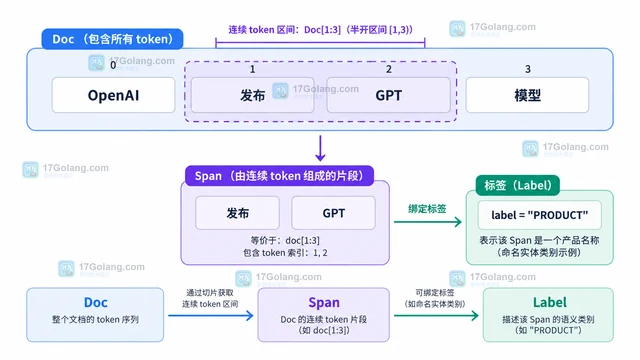 本文用 spaCy 的半开区间说明怎样从 Doc 中选择连续词元,构造带 label 的 Span,并把边界检查与 doc.spans、doc.ents 的承载选择放进一条稳定的处理链。283 收藏
-
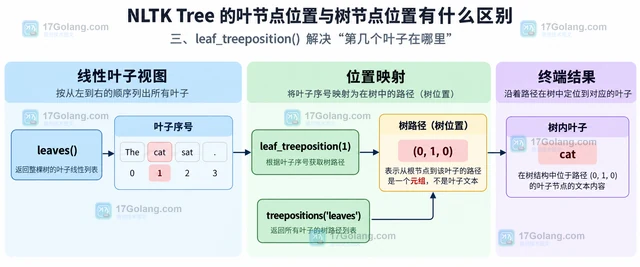 NLTK Tree 的位置元组既可以定位根节点和短语节点,也可以定位具体叶子。本文用一棵句法树区分 treepositions、treepositions('leaves')、leaf_treeposition 与连续叶子范围定位。197 收藏
-
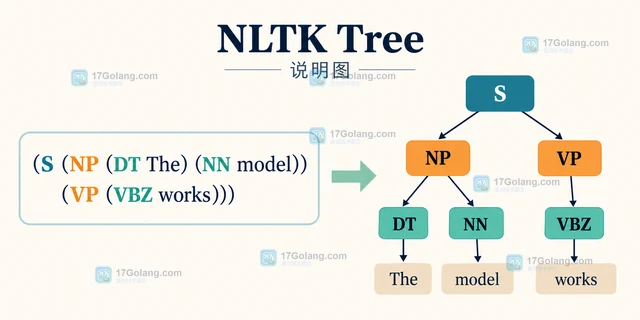 用 NLTK Tree.fromstring 读取括号形式句法树,掌握根节点、叶子、树位置和自定义括号等参数的实际用法。203 收藏
-
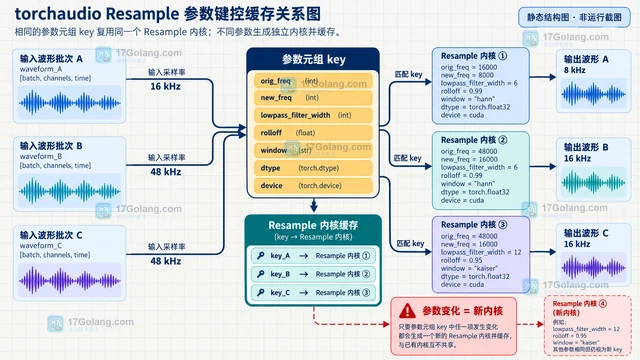 固定采样率的音频批处理不必反复生成重采样卷积核。本文说明 torchaudio.transforms.Resample 与 functional.resample 的缓存边界,并给出按采样率、滤波参数、dtype 和设备分层复用的实现方式。356 收藏
-
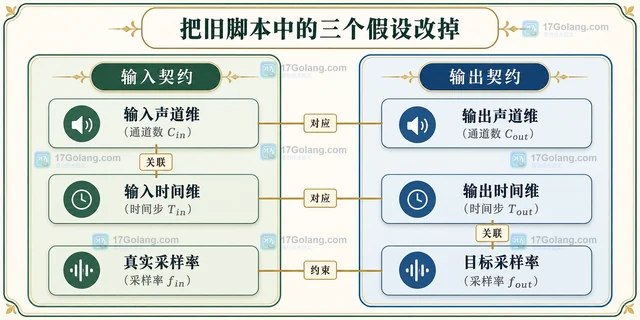 torchaudio多声道重采样应保留声道维并沿最后一维处理。结合48kHz到16kHz的张量示例,说明旧脚本迁移、采样率标签、核缓存及设备精度的配套修改。210 收藏
-
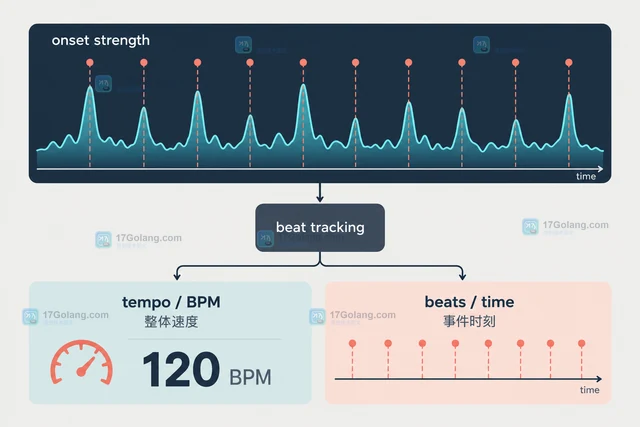 librosa beat_track 返回的 tempo 是速度估计,beats 是节拍事件位置。本文用实际调用拆解两者的单位、稀疏表示、时变 BPM 和常见误判,帮助你把节拍正确对齐到秒或帧。467 收藏
-
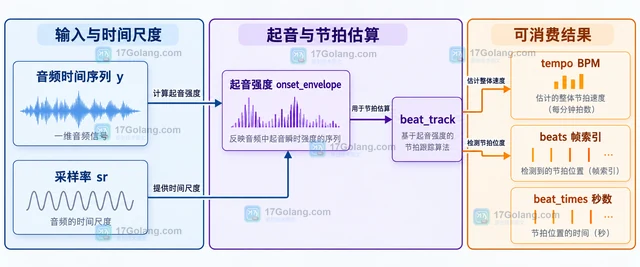 用 librosa.beat.beat_track 从音频的起音强度中估算 BPM 和节拍位置,并把帧索引稳定转换为秒;同时说明空结果、BPM 为 0 和 hop_length 不一致时怎样排查。444 收藏