
人工智能技术文章
-
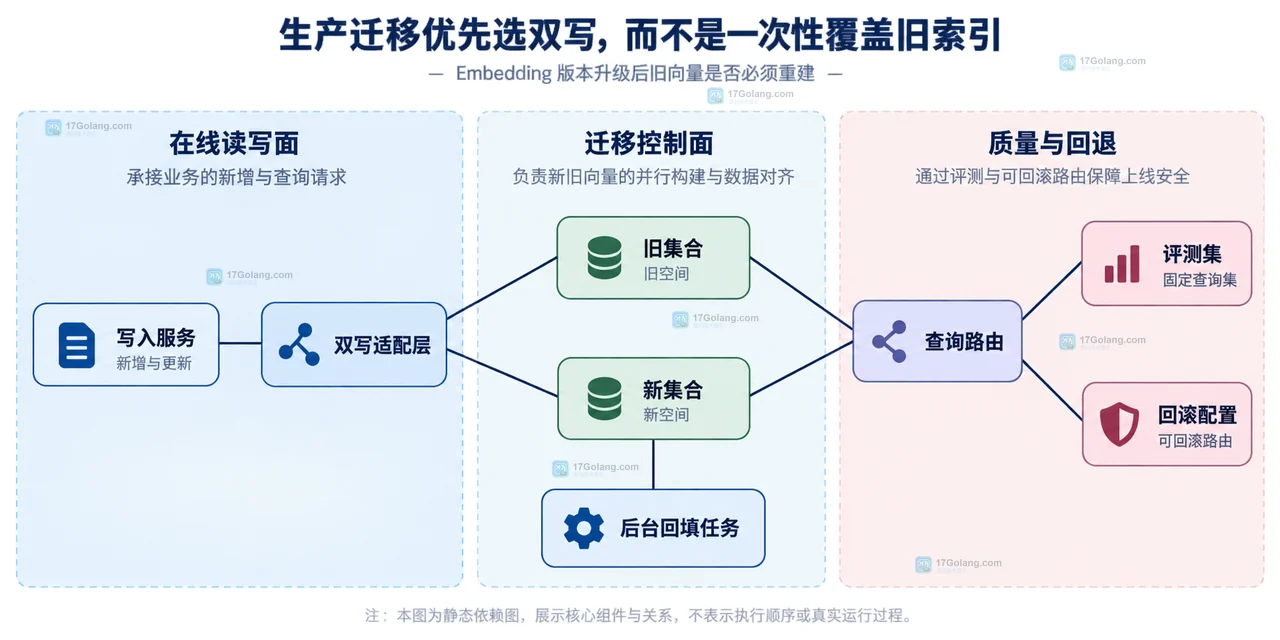 Embedding 模型、维度或距离度量升级后,旧向量通常不能直接混用。本文说明如何判断空间兼容性,并用双写、后台回填、灰度评测和可回滚切换完成生产迁移。173 收藏
-
 本地量化模型显存不足时,先拆分权重、KV cache 和计算缓冲区,再按真实输入选择上下文长度。本文给出 2048、4096、8192 的起点判断,以及上下文、KV 缓存精度、批大小和量化档位的调节顺序。258 收藏
-
 用多模态模型抽取发票时,不要只保存模型返回的文本。本文用 JSON Schema 设计字段证据对象,把字段值、原图归一化坐标、证据说明和人工复核标记绑定在一起。446 收藏
-
 LLM评测集不要只放正常问答。更稳妥的做法是把样本分成正常任务、明确拒答和可澄清的边界请求,为每条记录期望行为、原因标签和替代方向,再按分片统计完成率、拒答准确率、澄清率与不必要拒答率。177 收藏
-
 工具调用参数校验失败时,不要直接重放可能产生副作用的工具。本文拆解 strict Schema、应用侧业务校验、tool_call_id 错误反馈、幂等键和有限重试的分工。215 收藏
-
 模型返回枚举值错误时,先区分 schema 不匹配、拒答和输出不完整,再用 JSON Schema 的 enum 约束允许值,并保存脱敏原始响应。本文给出结构化输出的约束、解析、重试和监控做法。345 收藏
-
 向量检索召回低时不要盲目更换嵌入模型。本文用固定评测集、Recall@k 和命中排名,分别拆分切片、嵌入模型与召回阈值问题。446 收藏
-
 RAG 处理 PDF、Excel 或 Markdown 表格时,固定长度切片容易丢失表头和来源。本文用行级知识块、metadata 和检索组合保留表格关系。311 收藏