
人工智能技术文章
-
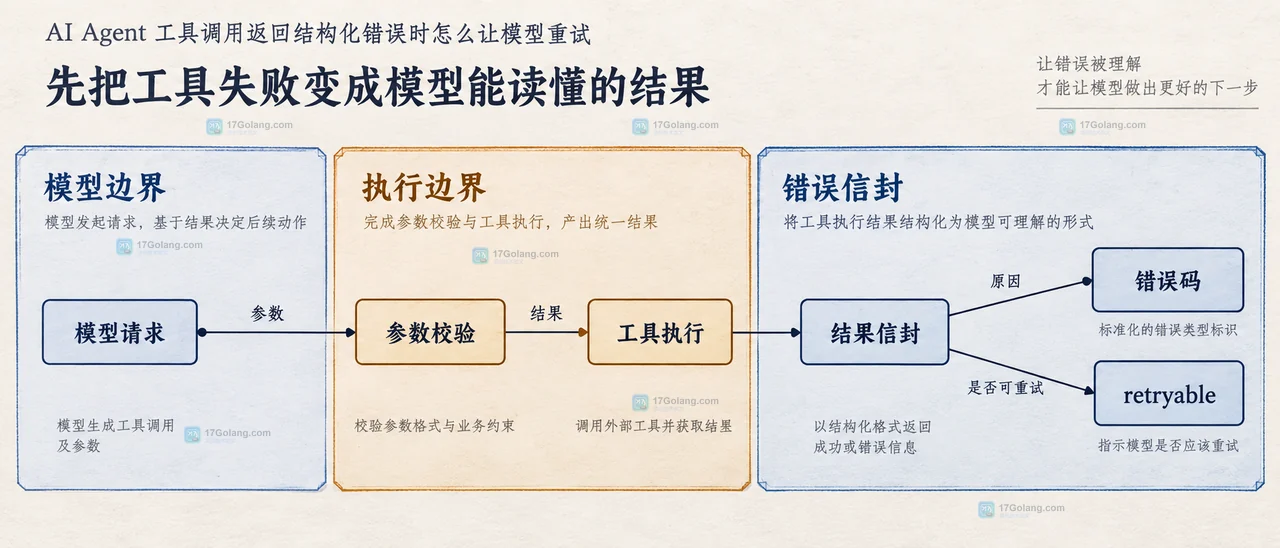 AI Agent 工具调用失败时,不要无条件重放模型请求。本文用统一错误信封、错误码分层、原始 call_id 回传和有限重试预算,让模型只重试可修复问题,并避免副作用重复执行。307 收藏
-
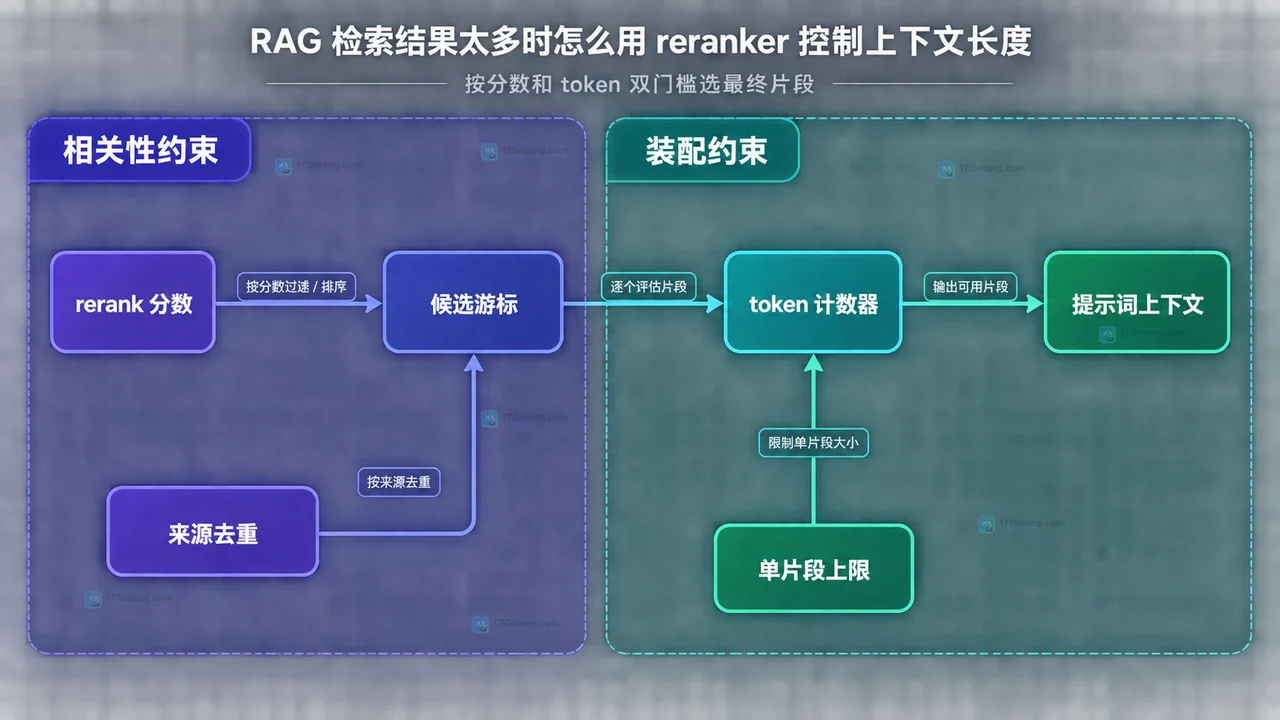 RAG 不应该把向量召回的所有片段直接塞进上下文。本文用 reranker 重排候选片段,再用 token 预算、单片段上限和来源去重装配最终上下文,给出可观测的参数与 Python 示例。281 收藏
-
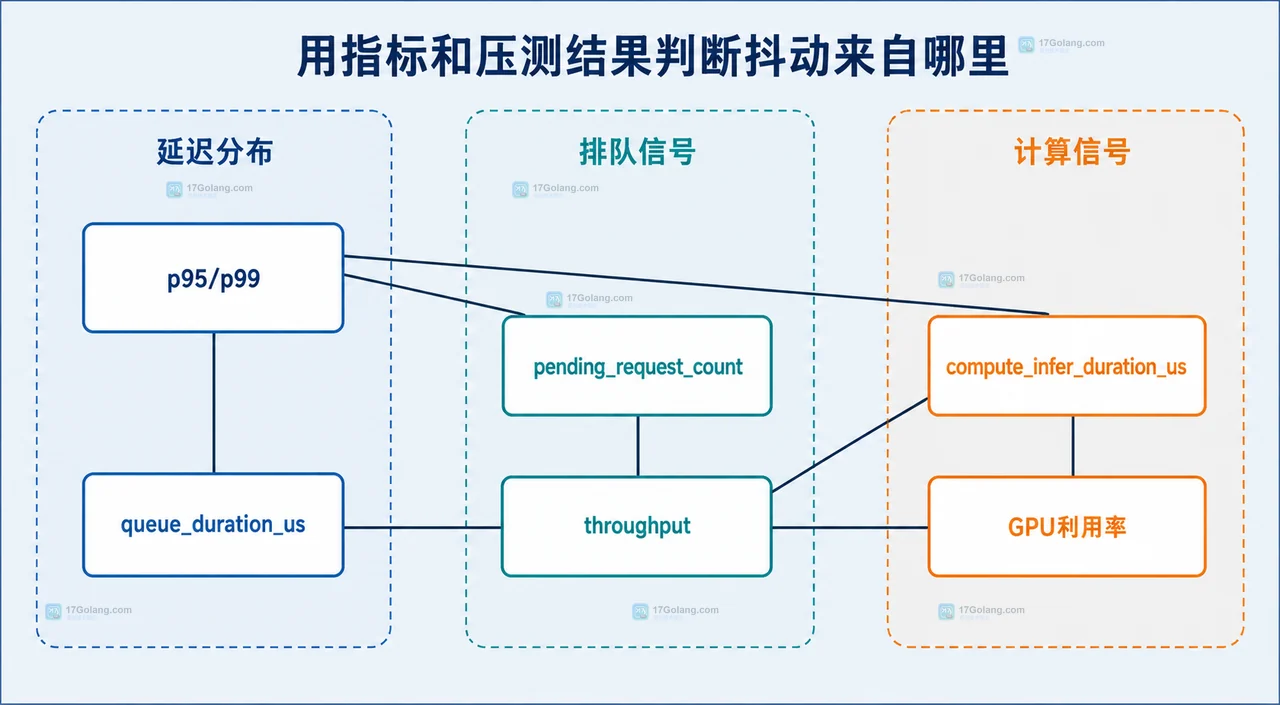 AI 推理服务的 p95、p99 延迟突然抖动时,不要只看 GPU 利用率。本文用请求、排队、输入处理、模型计算和输出处理的分段指标,结合并发与吞吐变化,判断瓶颈究竟在调度排队还是模型计算。462 收藏
-
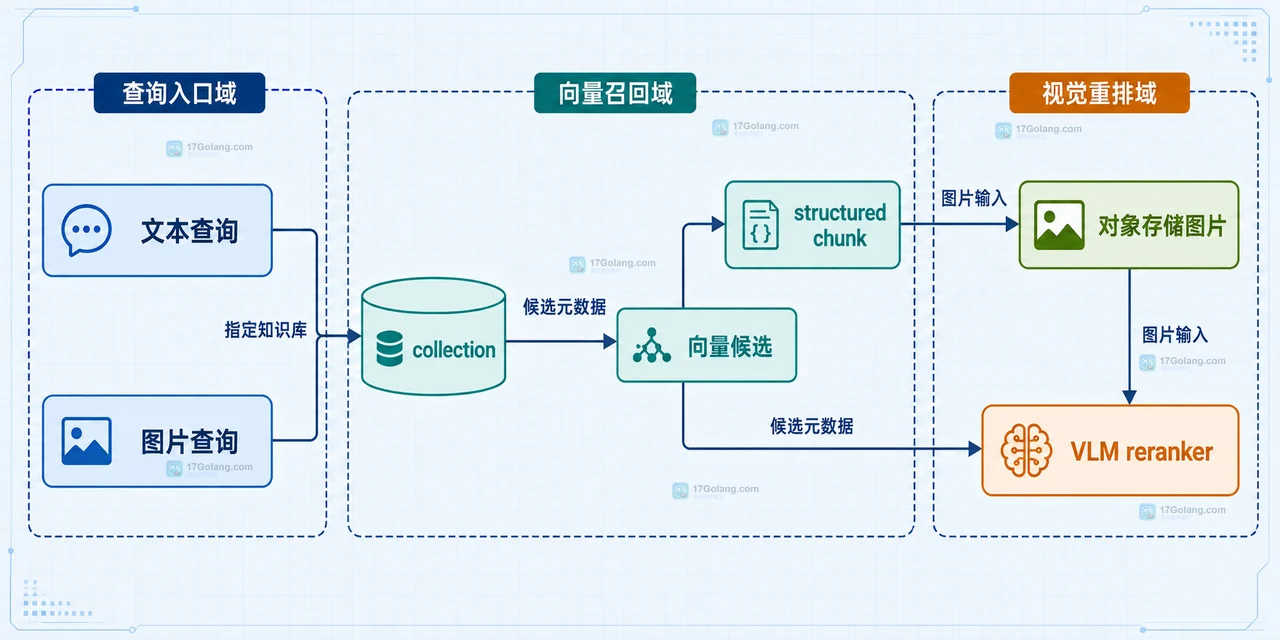 PDF 图表检索失败时,先区分抽取、模态 embedding、向量集合和视觉重排四层。本文用固定回归样本和配置检查,定位图表到底在哪一层丢失。132 收藏
-
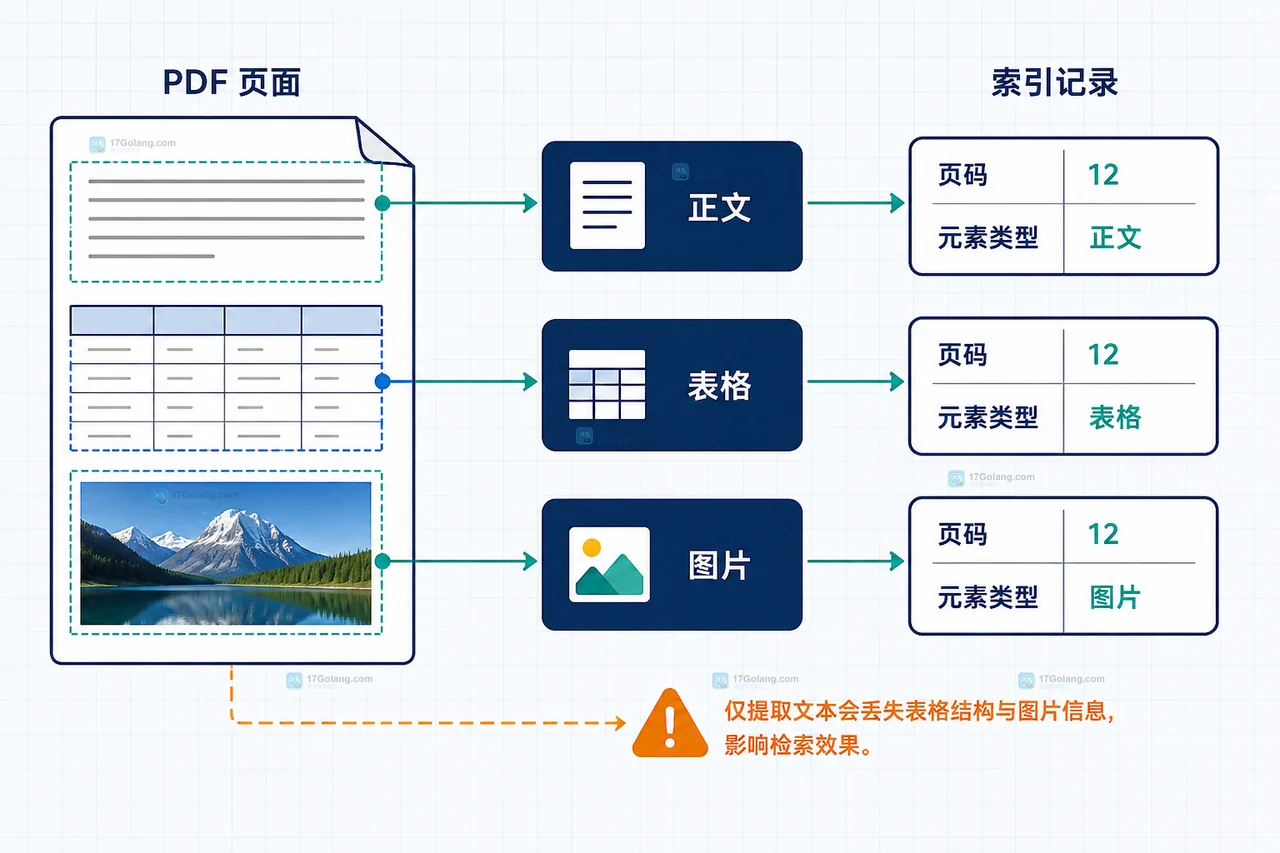 PDF 表格在 RAG 中不能只靠正文抽取。本文用摄取、元素表示和检索核对三层方法,说明如何保留表格结构、图片与页码元数据。244 收藏
-
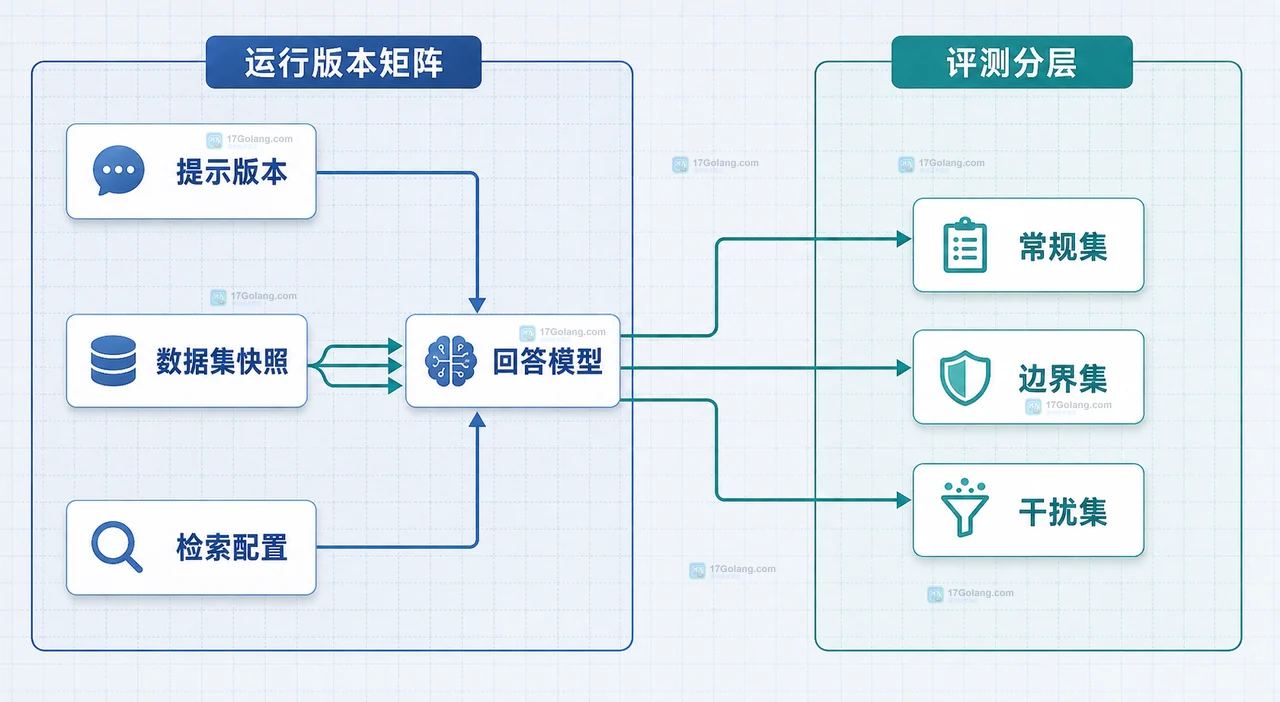 AI 问答评测不稳定,通常不是模型分数本身的问题,而是提示、检索配置和数据集同时在变化。本文给出一套可重复的 RAG 评测拆分、数据字段和回归清单。215 收藏
-
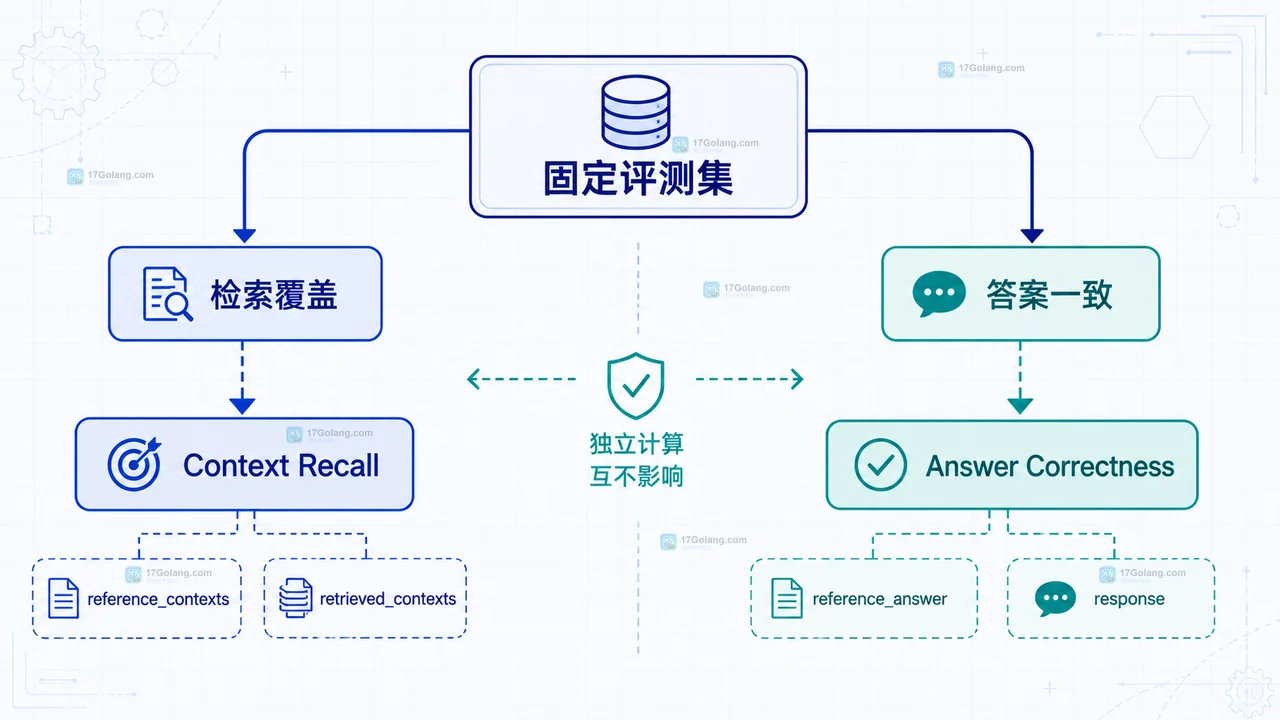 RAG 评测不要只看一个总分。本文用固定 JSONL 样本,把检索上下文覆盖率与最终答案正确率拆开统计,并用指标组合定位检索、生成和数据集问题。293 收藏
-
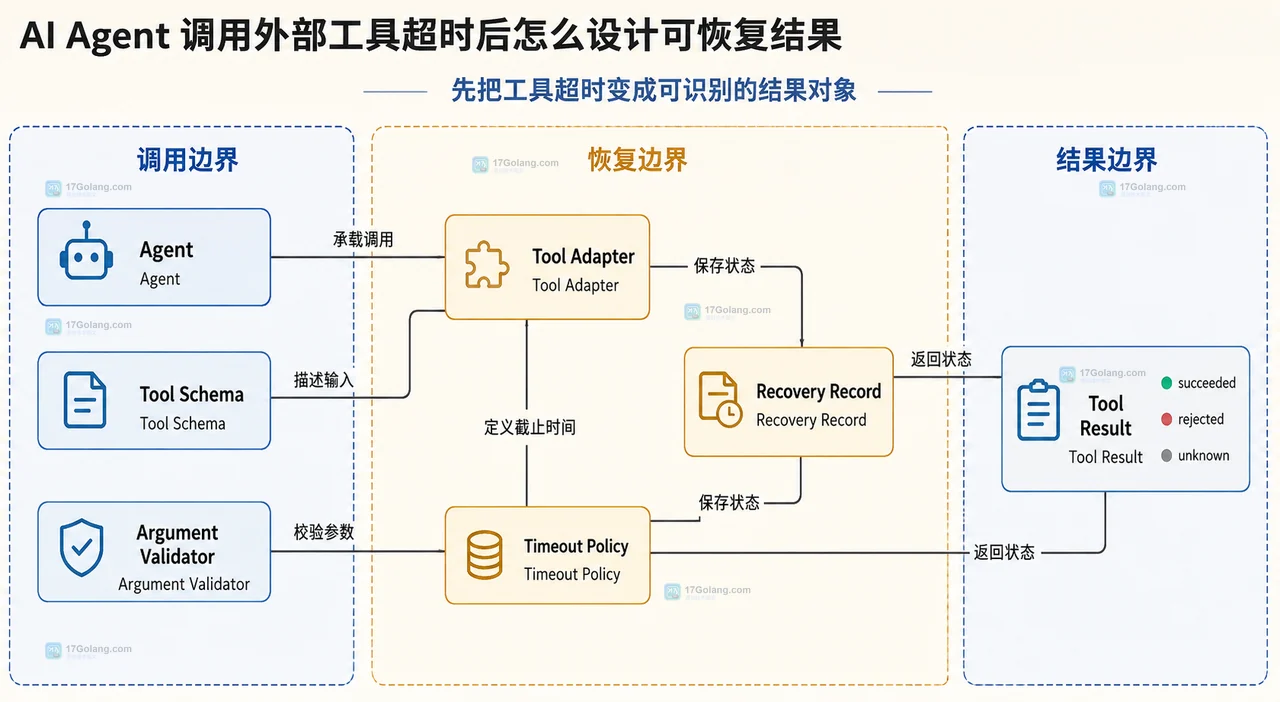 AI Agent 调用外部工具超时后,不要把异常当空结果或无条件重试。通过 schema、参数校验、幂等键、未知状态和恢复队列,设计可判断、可追踪、可继续处理的结果。203 收藏
-
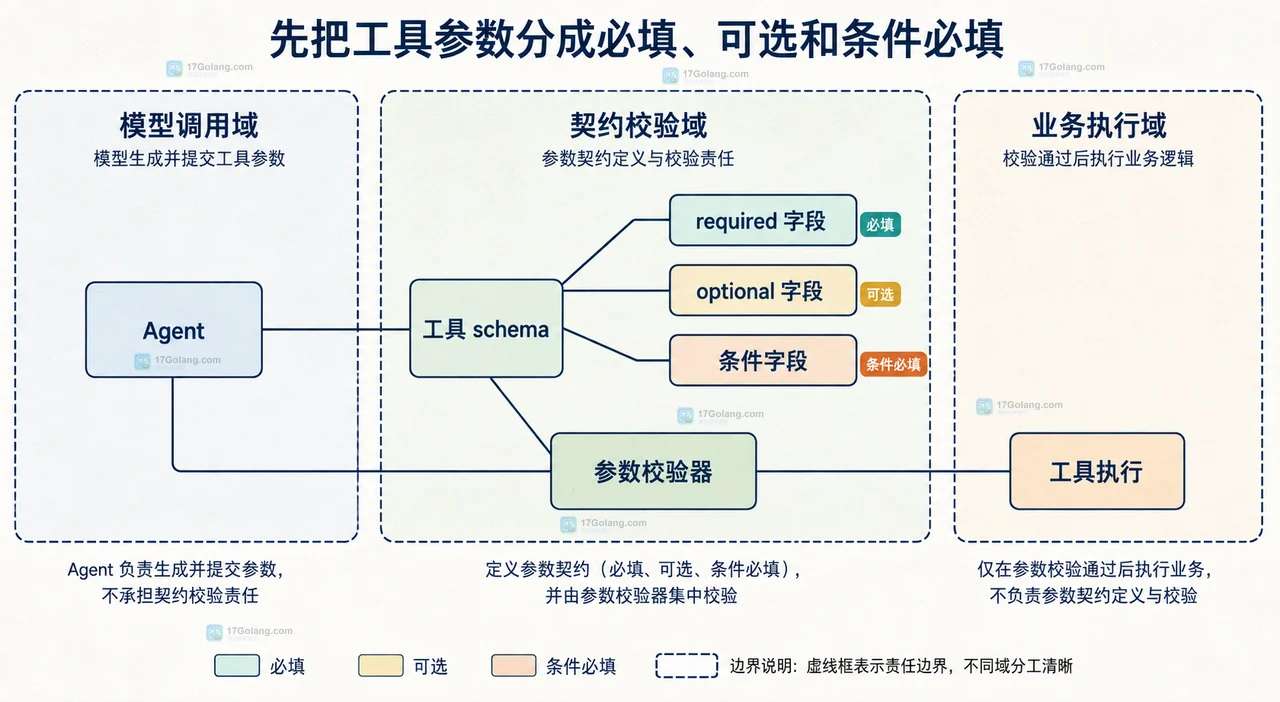 AI Agent 调用工具时经常漏传必填字段,问题通常不在提示词,而在工具契约没有收紧。本文用 JSON Schema 拆分必填、类型、额外字段和失败回传,给出可落地的校验与重试边界。316 收藏
-
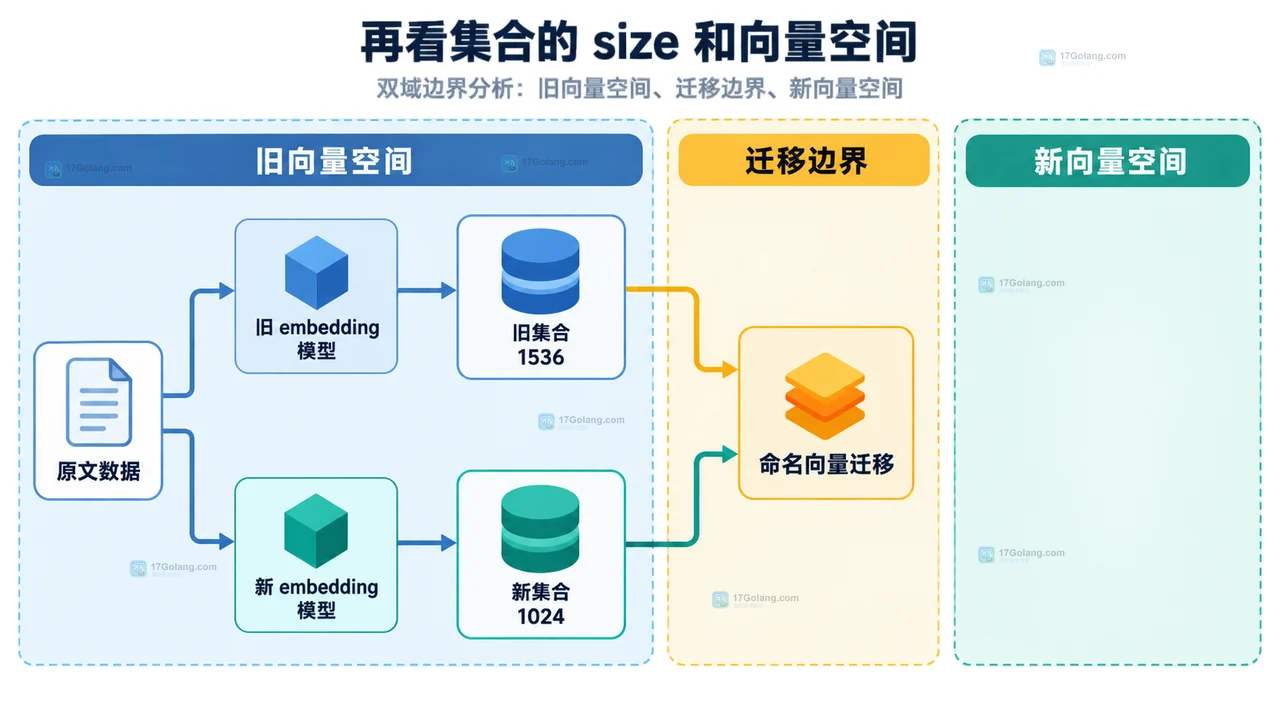 向量库维度不一致通常源于 embedding 模型输出、批量请求和集合 schema 没有对齐。本文给出从 expected/actual 到模型配置、命名向量和迁移方案的检查清单。498 收藏
-
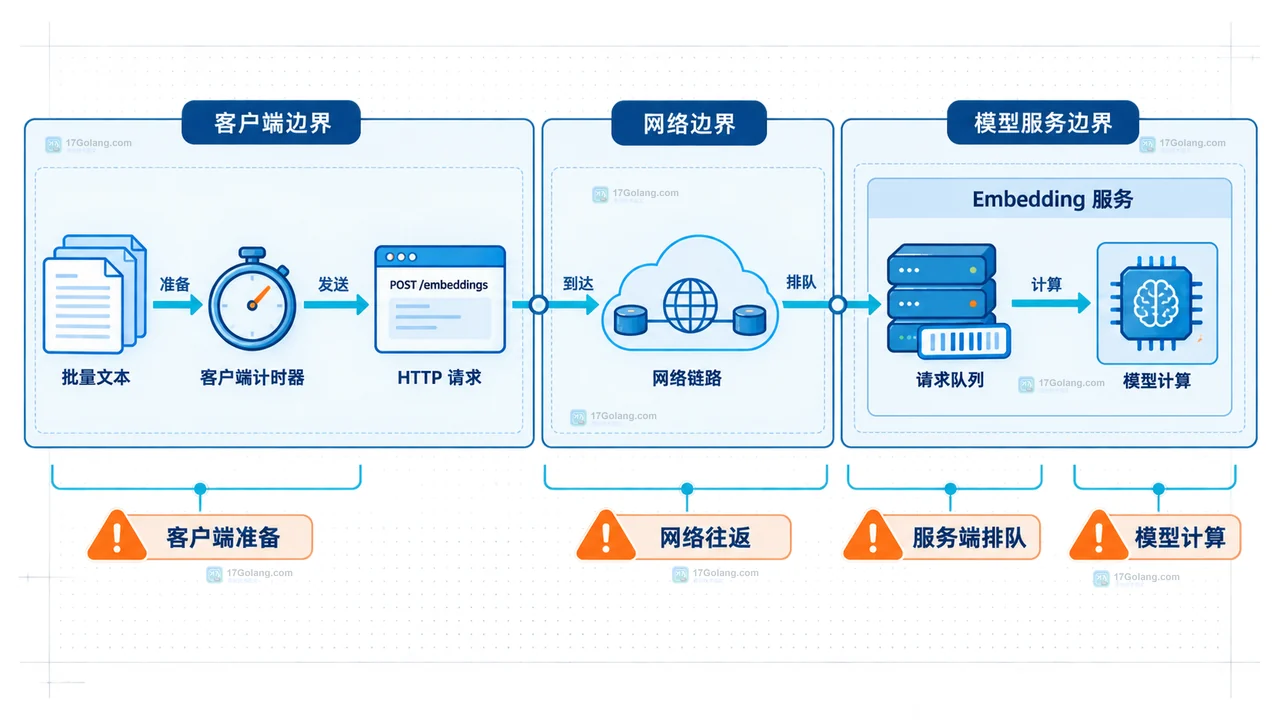 AI Embedding 批量请求变慢时,先把客户端准备、网络往返、服务端排队和模型计算拆开记录,再用固定文本与批次对照区分瓶颈;同时核对输出维度和向量库 schema,避免把维度不一致误判成网络问题。264 收藏
-
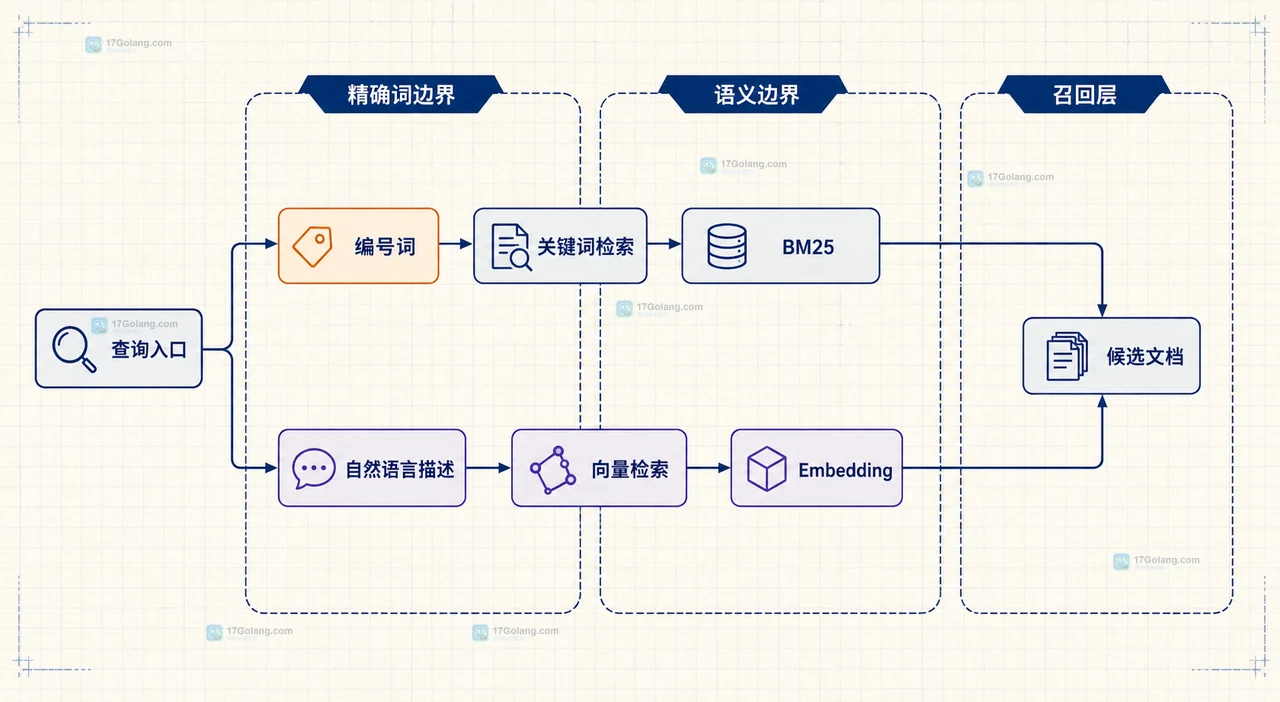 RAG 的关键词检索和向量检索出现重复结果时,应按文档 ID 去重、按切片 ID 保留证据,并用 RRF 处理两路分数尺度不同的问题。244 收藏
-
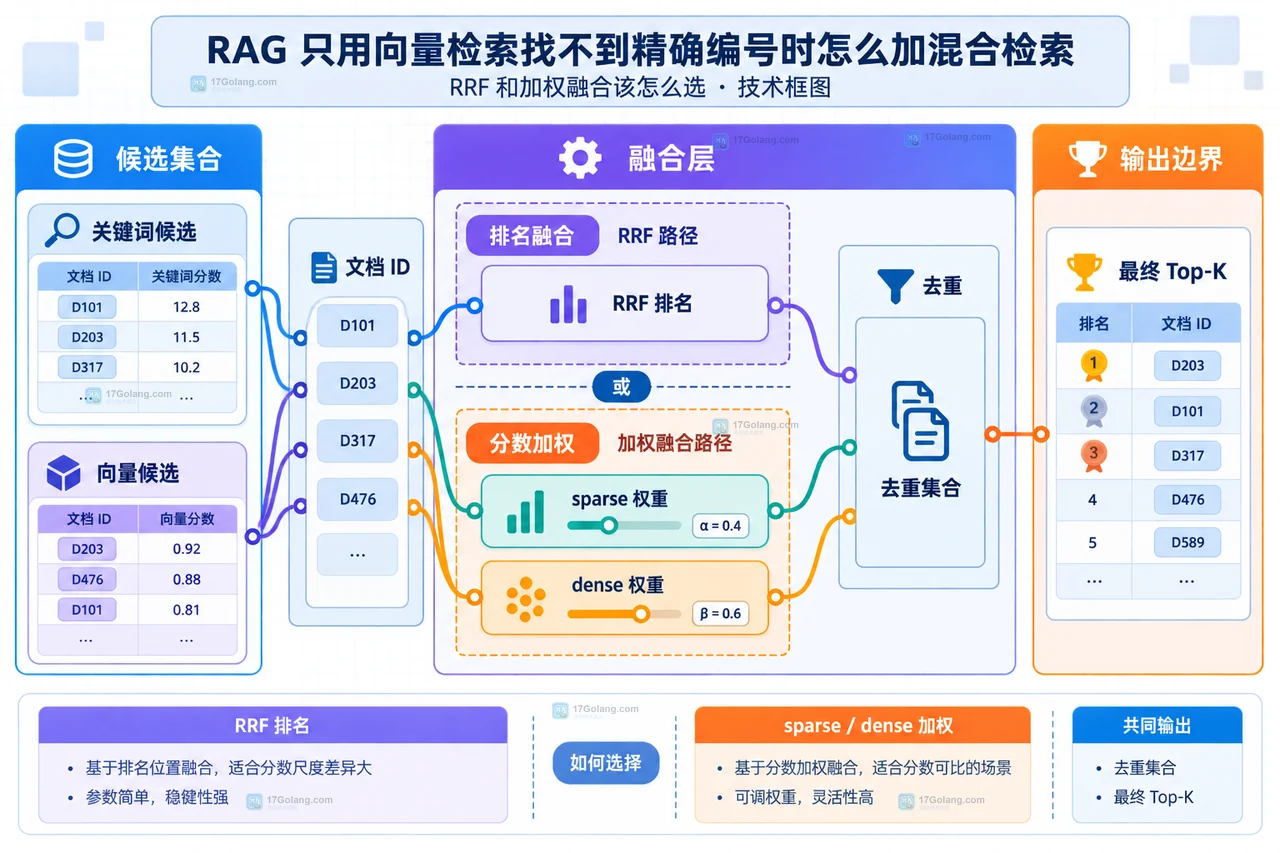 RAG 遇到订单号、设备编号、产品型号等精确词时,单纯向量检索可能把关键文档排到后面。本文用关键词检索加向量检索的混合召回,再用 RRF 或可解释权重合并结果。320 收藏
-
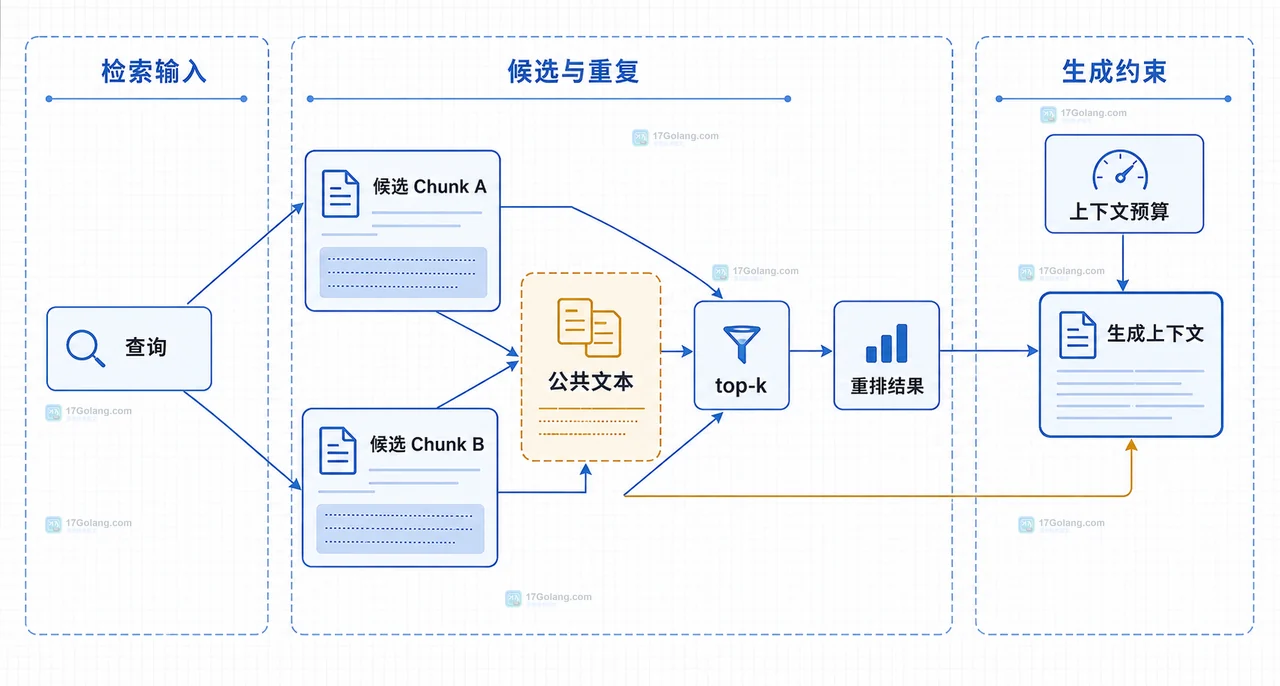 RAG overlap 过高时,不要只看切片数量;应结合 chunk size 的相对比例、召回候选的公共文本和最终上下文长度判断,再用固定问题集对照调参。355 收藏
-
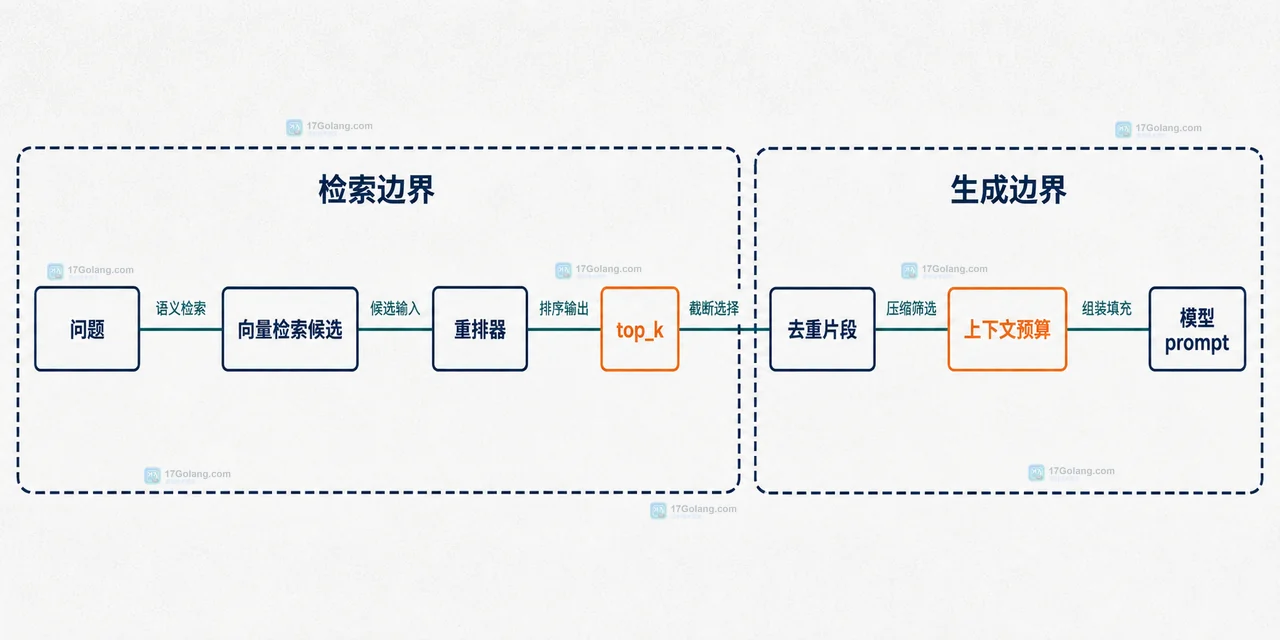 RAG 文档切片太大或重叠过高,都会让召回上下文变长并拖慢回答。本文按 chunk size、overlap、top_k 和上下文预算拆开排查,用固定问题集找到兼顾证据完整性与延迟的参数组合。277 收藏