-
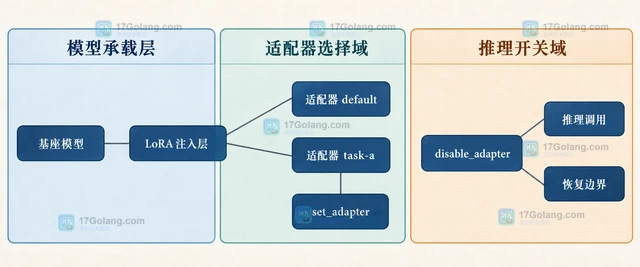
PEFT 中启用和停用 LoRA,关键是区分临时禁用全部适配器、按名称切换活动适配器,以及永久卸载模块。本文用 PeftModel 和 Transformers 两种接口说明调用边界,并给出状态检查清单。
-
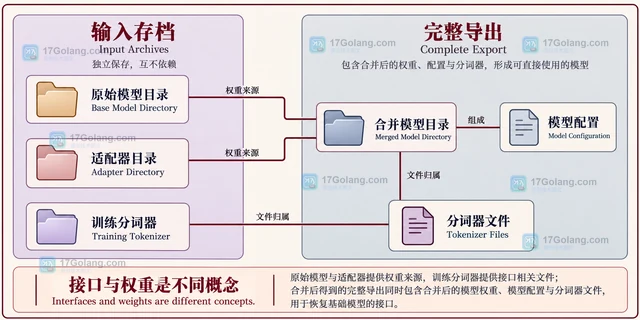
PEFT通过merge_and_unload返回保留适配器效果的普通模型。文章说明返回值使用、完整导出、可撤销合并,以及恢复接口与还原原始权重的区别。
-
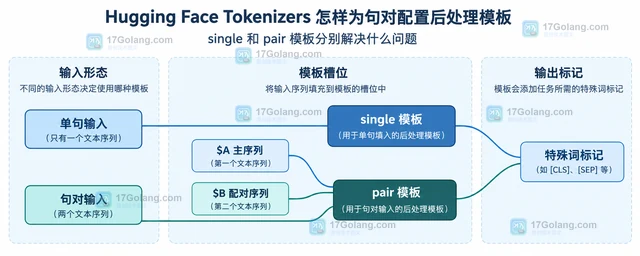
用 TemplateProcessing 为 Hugging Face Tokenizers 配置 single 与 pair 模板,说明 $A、$B、special_tokens 和 type_id 的对应关系,并整理句对长度与常见配置错误。
-

用 tokenizers.normalizers.Sequence 按顺序组合 NFD、Lowercase、StripAccents 等正规化器,说明如何挂到 Tokenizer、观察结果并保留对齐信息。
-
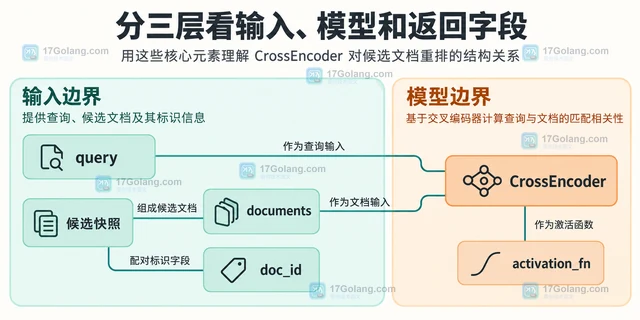
用CrossEncoder重排候选文档,保留corpus_id与业务ID映射,并区分召回缺失、分数含义、语言不匹配和长文本截断问题。
-
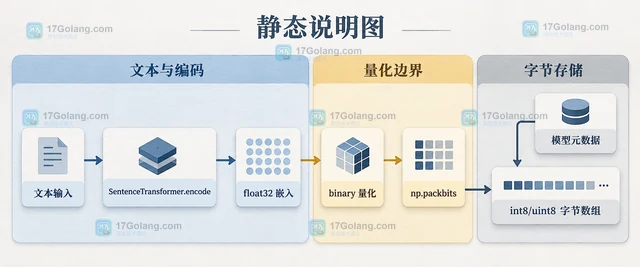
Sentence Transformers 可以在 encode 阶段直接生成 binary 嵌入,也可以把已有 float32 向量交给 quantize_embeddings。本文说明 bit 打包后的 shape、dtype、保存元数据,以及二进制召回与高精度重排的配合方式。
-
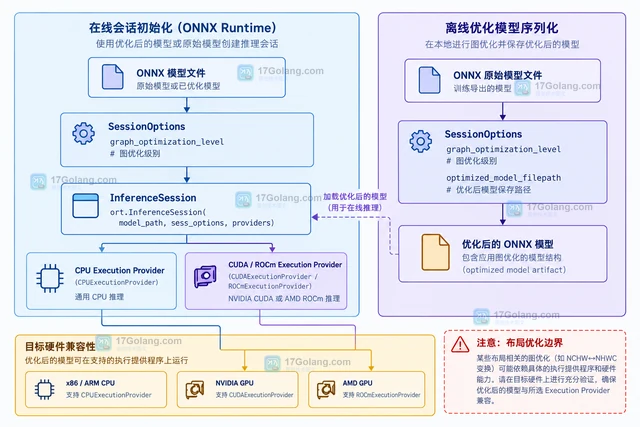
ONNX Runtime 的图优化等级绑定在 SessionOptions 上,EXTENDED 会包含 basic,ALL 还包括 layout。本文给出指定 InferenceSession 的 Python 配置、在线与离线优化的边界,以及按 Execution Provider 和目标硬件做基准、回退的实用方法。
-

ONNX Runtime 通过 SessionOptions 的图优化级别和 optimized_model_filepath 在创建推理会话时保存优化后的模型。本文说明 Python 写法、ONNX 与 ORT 格式边界,以及文件未生成时的排查方向。
-
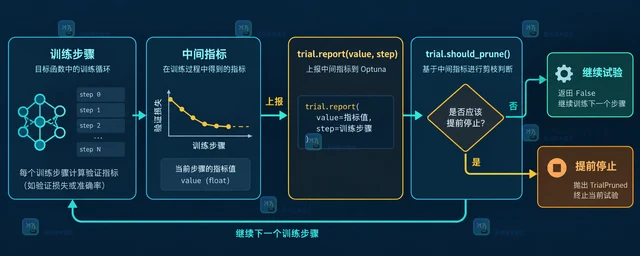
Optuna 的 MedianPruner 不会自动猜测训练进度,关键是让 objective 在每个可比较的步骤调用 report,再用 should_prune 响应剪枝判断。本文用一个单目标验证损失示例说明启动试验数、预热步骤、检查间隔和最小样本数如何配合。
-
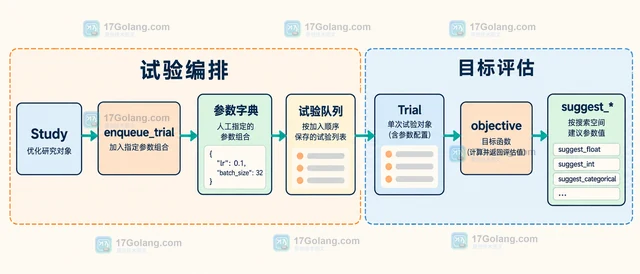
Optuna 的 enqueue_trial 可以把人工指定的参数组合放入试验队列,让 objective 先评估这些候选,再继续交给 sampler 搜索。本文演示调用顺序、skip_if_exists、参数范围和并发边界。
-
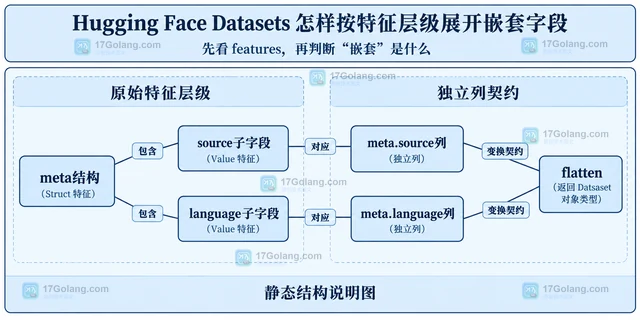
Hugging Face Datasets可用flatten把struct子字段展开成带层级前缀的独立列。本文通过原创样本区分Dataset与Features展开、列表拆行和索引整理,并说明下游列名契约。
-
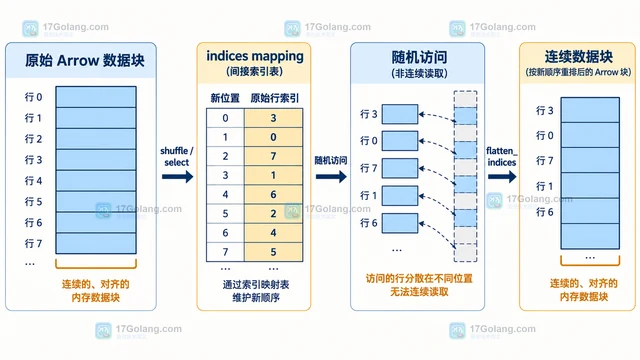
Hugging Face Datasets 在 shuffle、select 等操作后可能带有 indices mapping,导致访问不再连续。本文用 flatten_indices 重写数据,说明缓存、批量写入、并行和 IterableDataset 的选择边界。
-
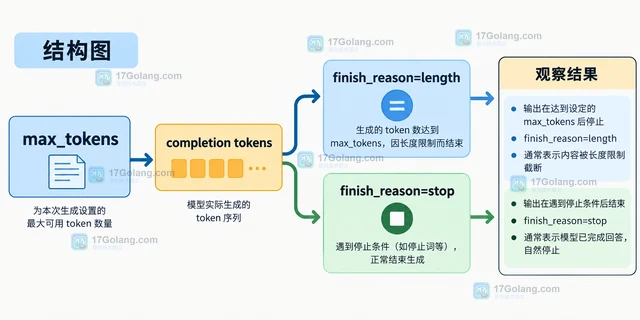
讲清 vLLM 在线服务中请求级 max_tokens 的设置位置、上下文边界与 finish_reason 判断方法,帮助按业务预算控制输出长度。
-
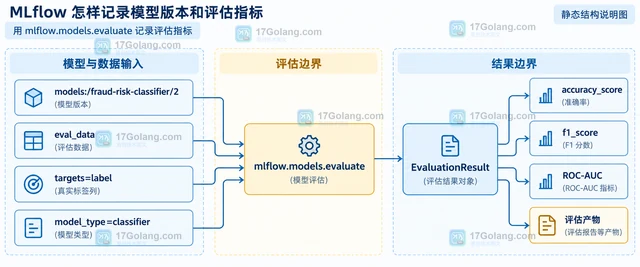
用一个完整的 MLflow Run 串起参数、手工指标、模型制品、注册模型版本和测试集评估结果:先固定实验与注册模型名,再用 registered_model_name 生成版本,最后通过 mlflow.models.evaluate 读取 accuracy、F1 等指标。
-
用 ONNX Runtime SessionOptions 开启 profiling,完成代表性推理后通过 end_profiling 导出 JSON,再按 Node、Kernel 与 dur 字段定位算子级延迟,避免误把主机事件和设备事件重复计算。
