-
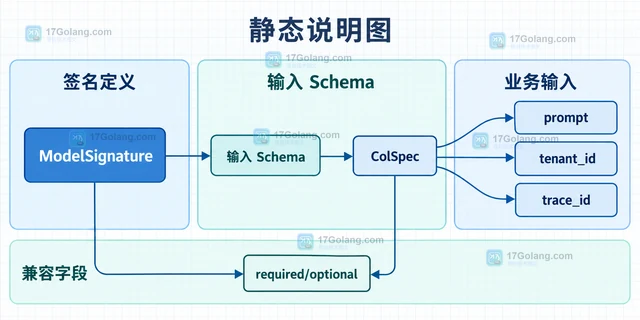
MLflow signature 的 required 字段决定调用方不能省略哪些输入。本文用显式 Schema 与 input_example 两种方式收窄输入契约,并说明缺字段、可选字段与额外字段的处理边界。
-
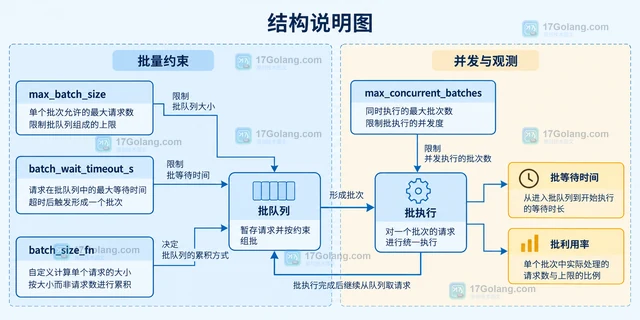
本文围绕 Ray Serve DeploymentHandle 的异步批处理,说明 DeploymentResponse 的提交与等待方式、@serve.batch 的参数边界、等长结果约束,以及如何用批等待和利用率指标判断参数是否合适。
-
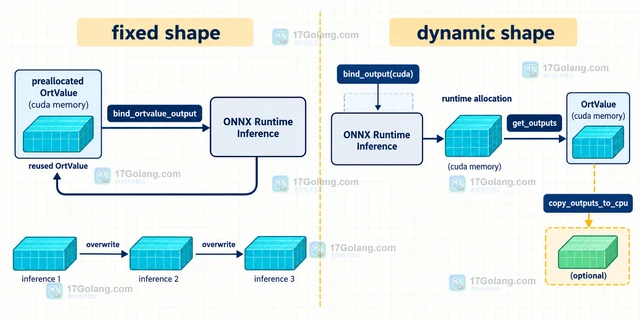
ONNX Runtime IOBinding 适合把固定形状的输入输出绑定到 CUDA 等目标设备,通过复用 OrtValue 减少 CPU-GPU 数据搬运和重复分配。本文给出 Python 绑定写法,并说明动态 shape 与 CPU 读回的边界。
-
JAX 未注册的自定义类会整体作为叶子,无法让 jax.jit 看到内部数组。本文用 register_pytree_node、register_pytree_node_class 和 register_dataclass 说明动态字段、静态元数据与对象重建的注册边界。
-
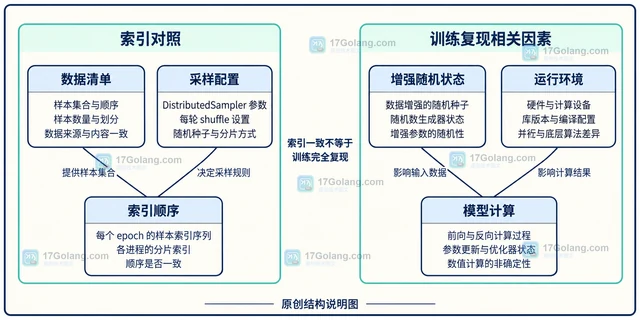
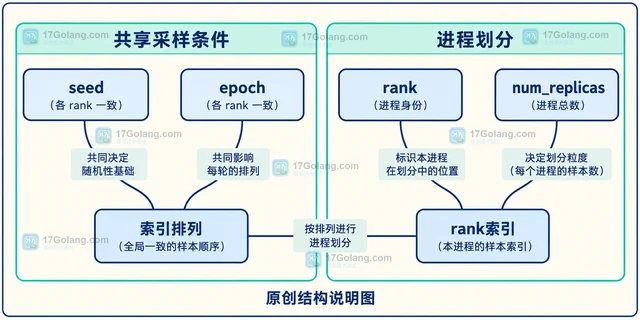
PyTorch DistributedSampler 以共同 seed 与逐轮 set_epoch 控制打乱。本文说明调用位置、rank 划分、尾部处理和恢复训练时的索引复现范围,并给出小样本对照代码。
-
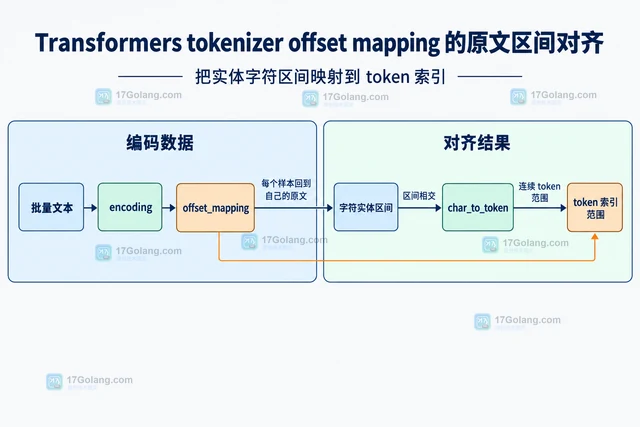
围绕 Hugging Face Transformers 的 Fast tokenizer 说明 offset_mapping 如何返回 token 对应的原文半开区间,处理特殊 token、空白、批量句对和截断,并给出实体字符区间转换为 token 范围的 Python 示例。
-
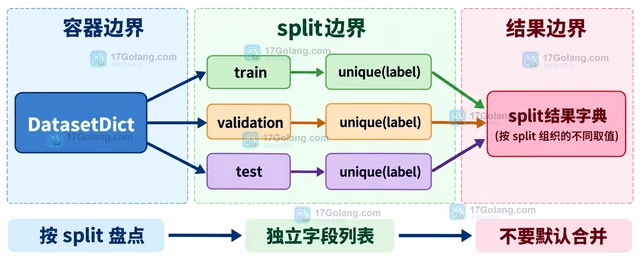
Hugging Face Datasets 的 Dataset.unique 和 DatasetDict.unique 可以直接列出字段的不同取值。本文用最小示例说明字段检查、split 结果、返回顺序以及高基数字段的内存边界。
-
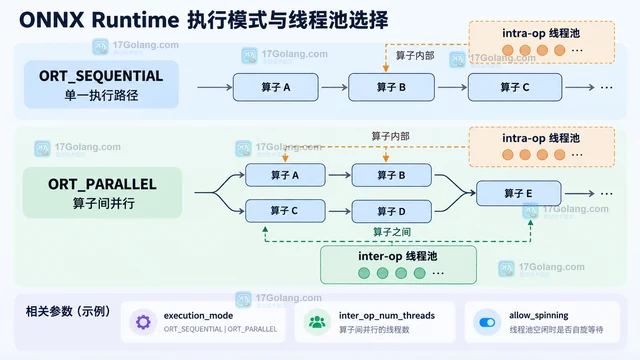
ONNX Runtime 的线程数不是只改一个参数:intra_op_num_threads 控制算子内部并行,inter_op_num_threads 只在 ORT_PARALLEL 下控制算子之间并行。本文用 Python SessionOptions 说明两类线程池、等待策略和多会话场景的配置边界。
-
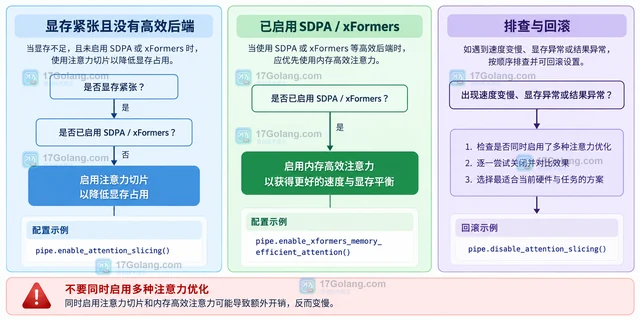
讲清 Diffusers attention slicing 与 SDPA、xFormers 等高效注意力后端的关系,说明为什么重复开启可能变慢,并给出选择与回滚配置。
-
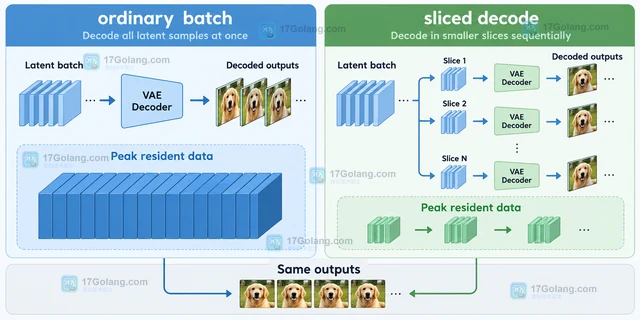
本文围绕 Diffusers enable_vae_slicing,说明多图 VAE 解码的显存峰值来源、管线级启用方式、受控测量方法和速度与显存之间的取舍。
-
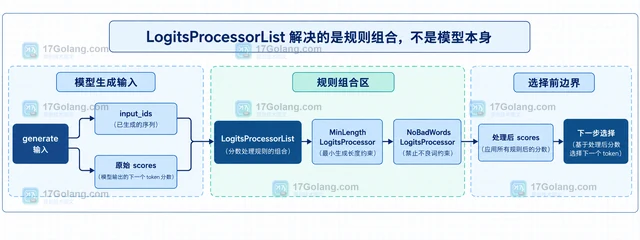
Transformers LogitsProcessorList 会按列表顺序依次处理生成分数。本文用最小长度、禁用词、分数归一化和自定义处理器说明如何组合规则,并给出接入 generate 与排查失效的实用方法。
-
StoppingCriteriaList 是 Transformers 生成过程中的停止条件容器。本文用长度、时间和自定义条件说明如何组合它们,并解释按 batch 样本合并布尔结果、scores 依赖和 max_length 冲突。
-
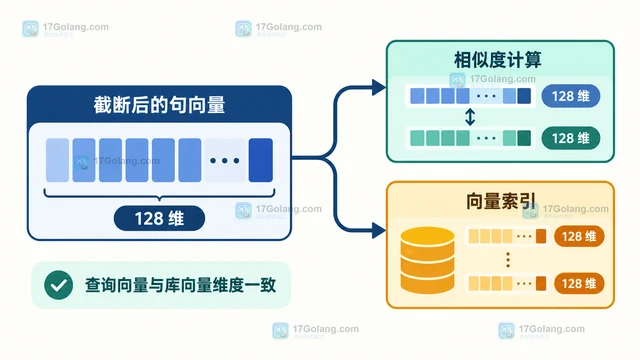
Sentence Transformers 的 truncate_embeddings 用于把已有嵌入矩阵截取到目标维度。本文说明样本轴与维度轴的区别、NumPy 与 Tensor 输入、相似度计算、索引迁移和模型适配边界。
-
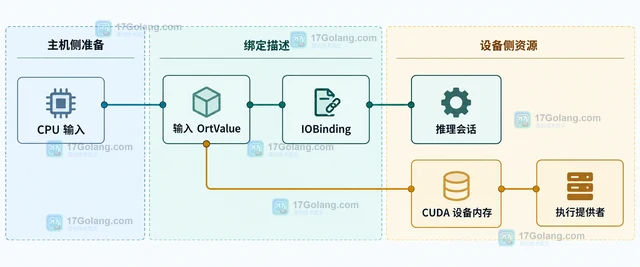
ONNX Runtime 普通 run 路径可能让输入输出在 CPU 与加速设备之间来回搬运。本文以 Python IOBinding 为主线,说明如何准备设备 OrtValue、预分配固定形状输出、调用 run_with_iobinding,并区分动态输出、CPU 回读和内存生命周期边界。
-
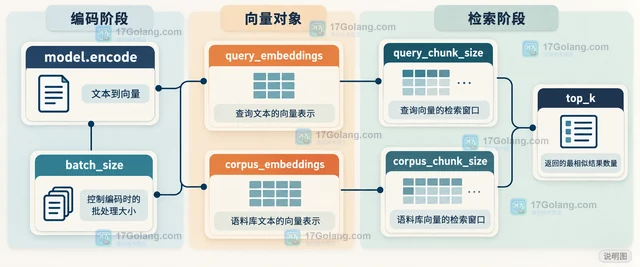
Sentence Transformers semantic_search 的分块大小由 query_chunk_size 和 corpus_chunk_size 控制。本文区分编码 batch_size、检索 chunk 与 top_k,给出按内存和耗时逐步调整的处理方法。
