
人工智能技术文章
-
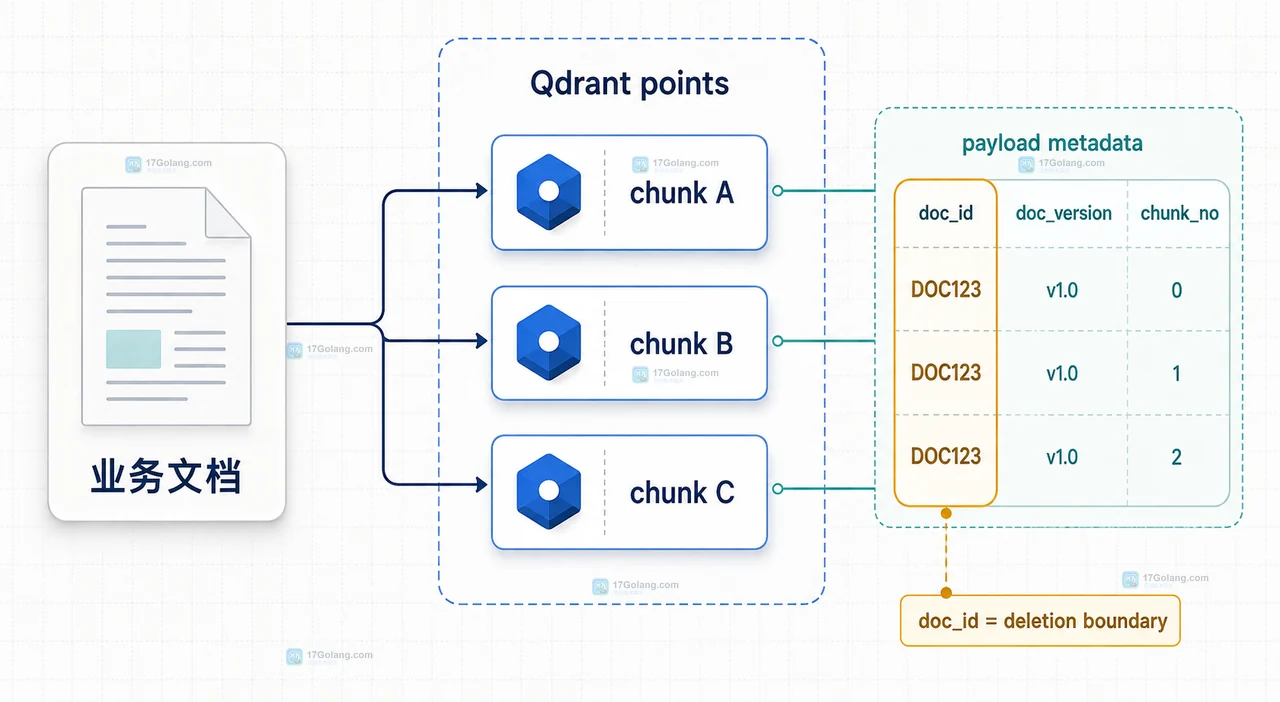 知识库删除原文时,不能只删业务数据库记录,还要依据稳定的 doc_id 清理 Qdrant 中的全部 points。本文说明 payload 设计、按过滤器删除、wait/ordering 选择,以及如何避免并发重建任务把旧向量重新写回。335 收藏
-
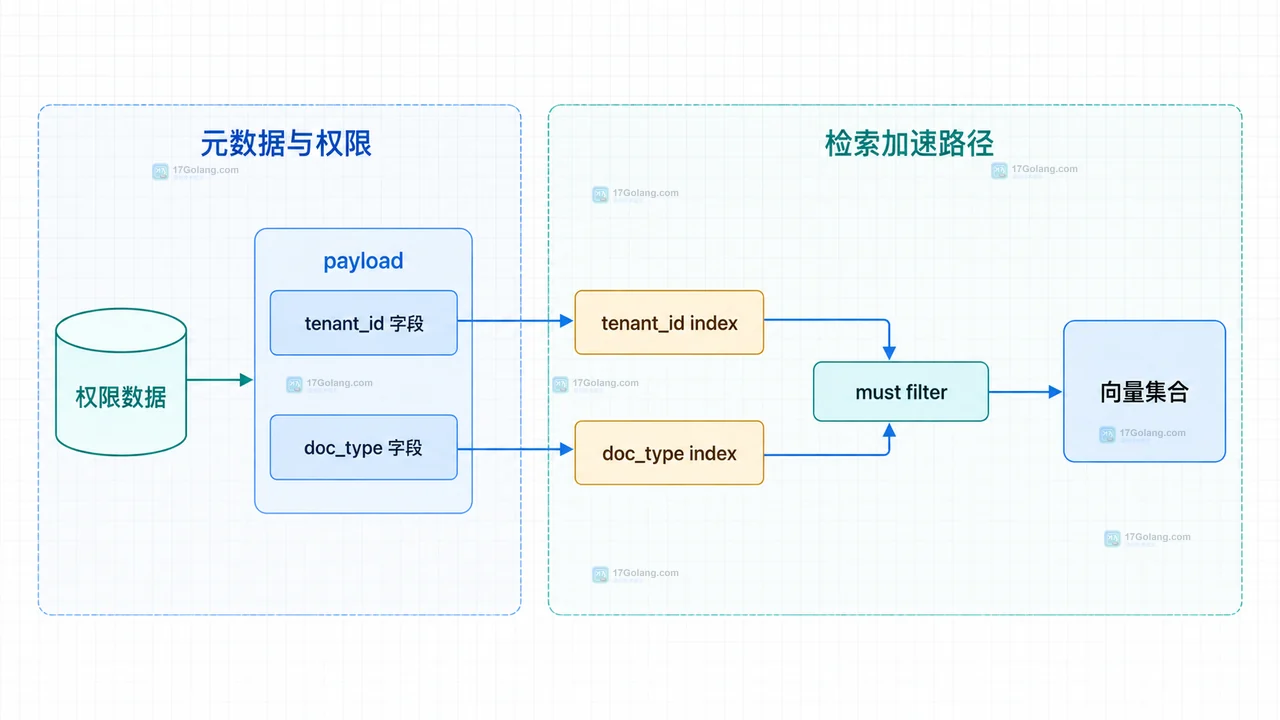 用 Qdrant payload 保存 tenant_id 和 doc_type,通过 must 组合租户与文档类型过滤条件,并为高频字段建立 payload index,让向量检索先守住知识库权限边界。473 收藏
-
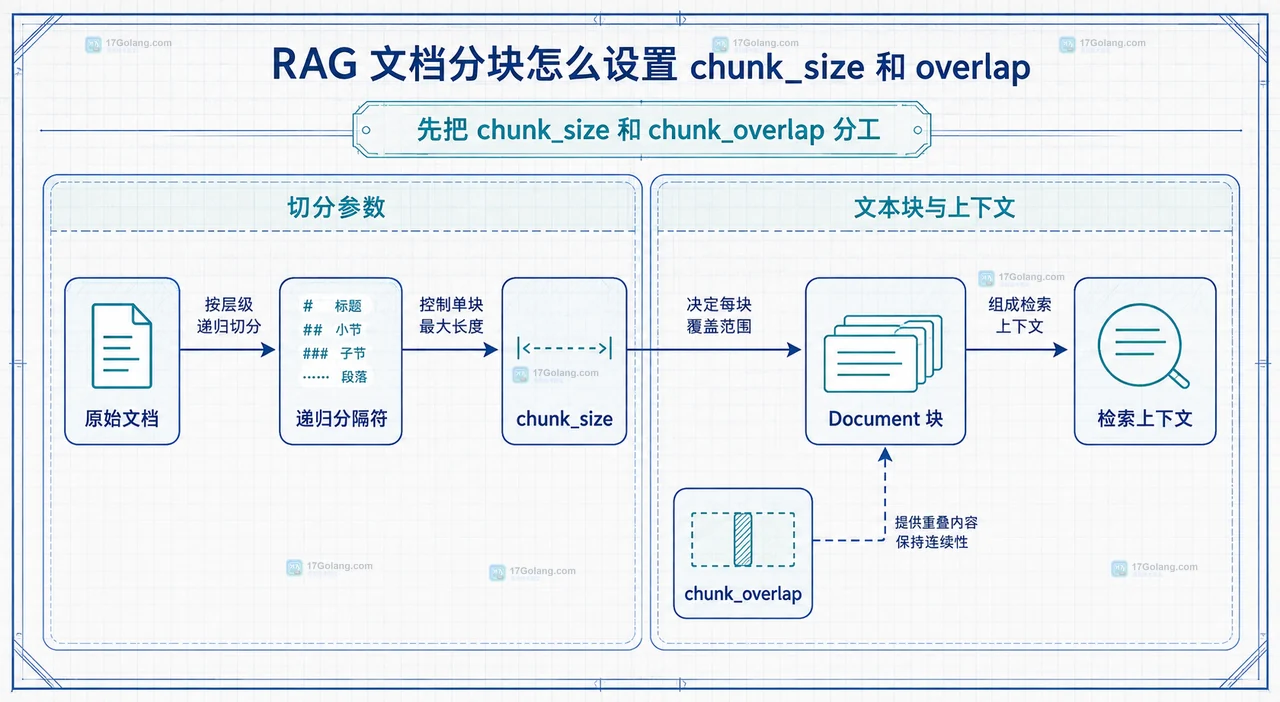 RAG 文档分块没有一组对所有知识库都适用的固定参数。本文以 RecursiveCharacterTextSplitter 为例,说明 chunk_size、chunk_overlap 和中文分隔符的职责,并给出从检索效果反推参数的调整方法。192 收藏
-
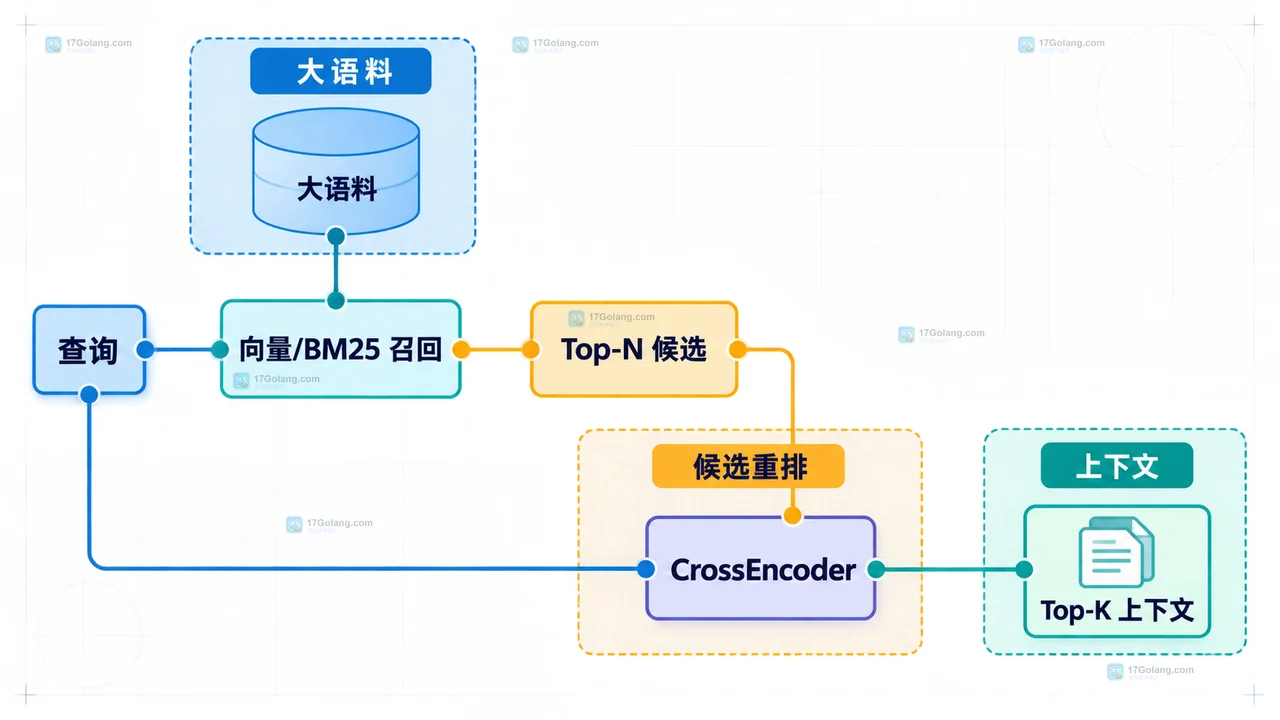 RAG 可以先用双编码器或 BM25 召回候选,再让 CrossEncoder 对查询和候选片段逐对打分,按分数取最终 Top-K。本文给出可运行的 Python 写法,并说明候选规模、分数和延迟边界。237 收藏
-
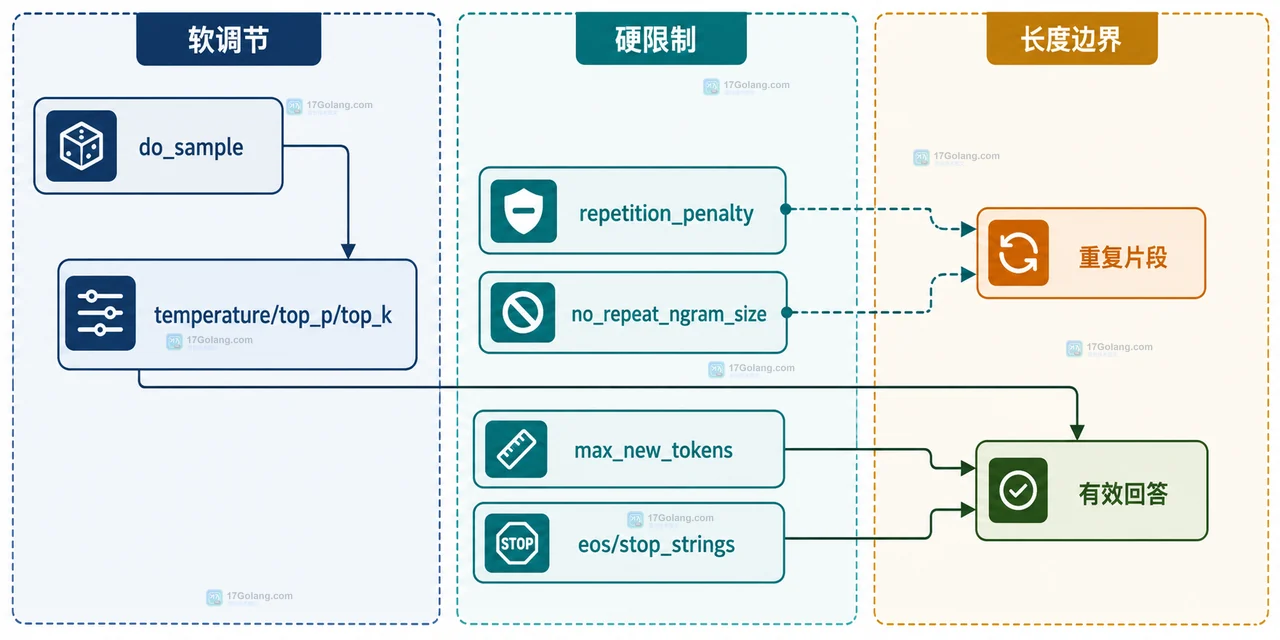 本地大模型反复输出同一句话时,从采样开关、temperature、top_p、repetition_penalty、no_repeat_ngram_size 和长度边界逐项调整,并给出 Transformers 示例。501 收藏
-
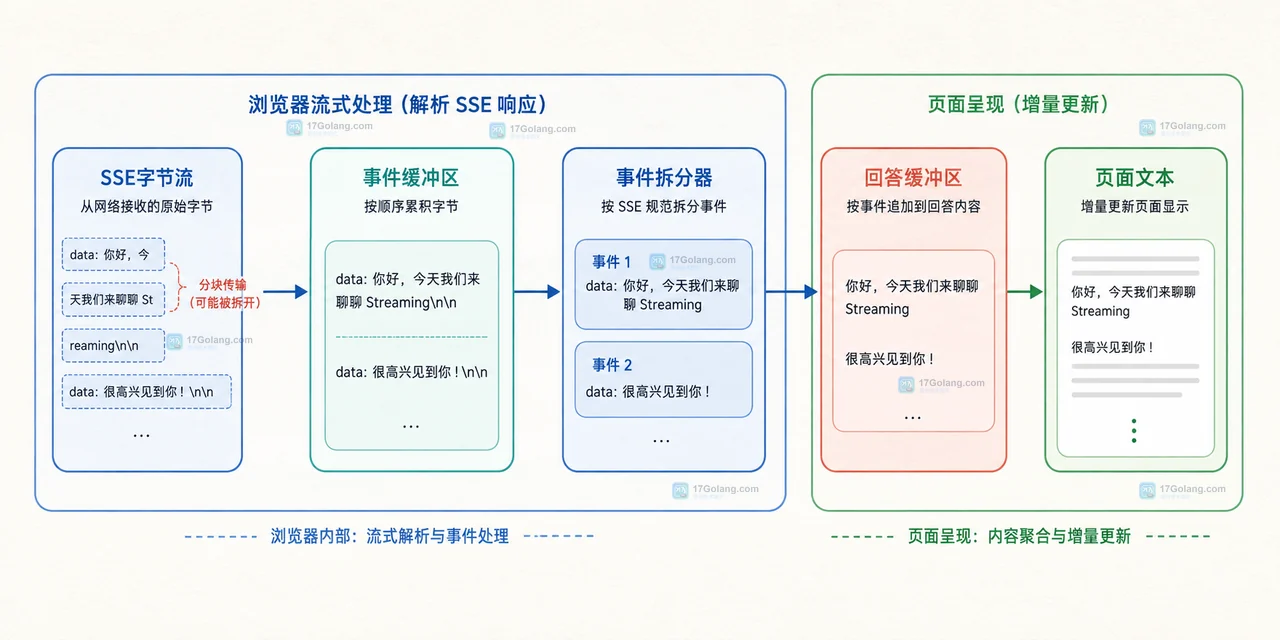 用 TextIteratorStreamer 接收 Transformers 的增量文本,再通过 FastAPI SSE 传给浏览器,完成一个可处理异常和断开的流式生成接口。472 收藏
-
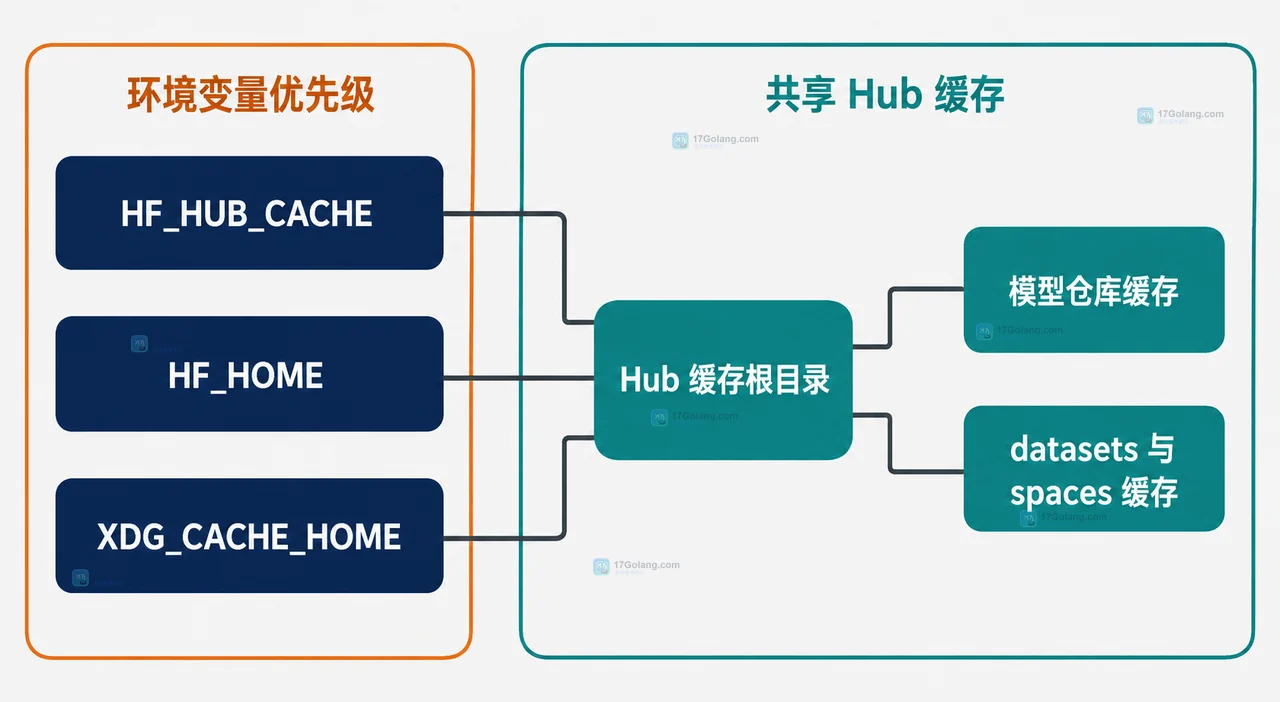 用 HF_HUB_CACHE 或 HF_HOME 把 Hugging Face 模型缓存放到指定磁盘,再用 snapshot_download 提前准备文件,结合 HF_HUB_OFFLINE=1 与 local_files_only=True 完成无网加载。384 收藏
-
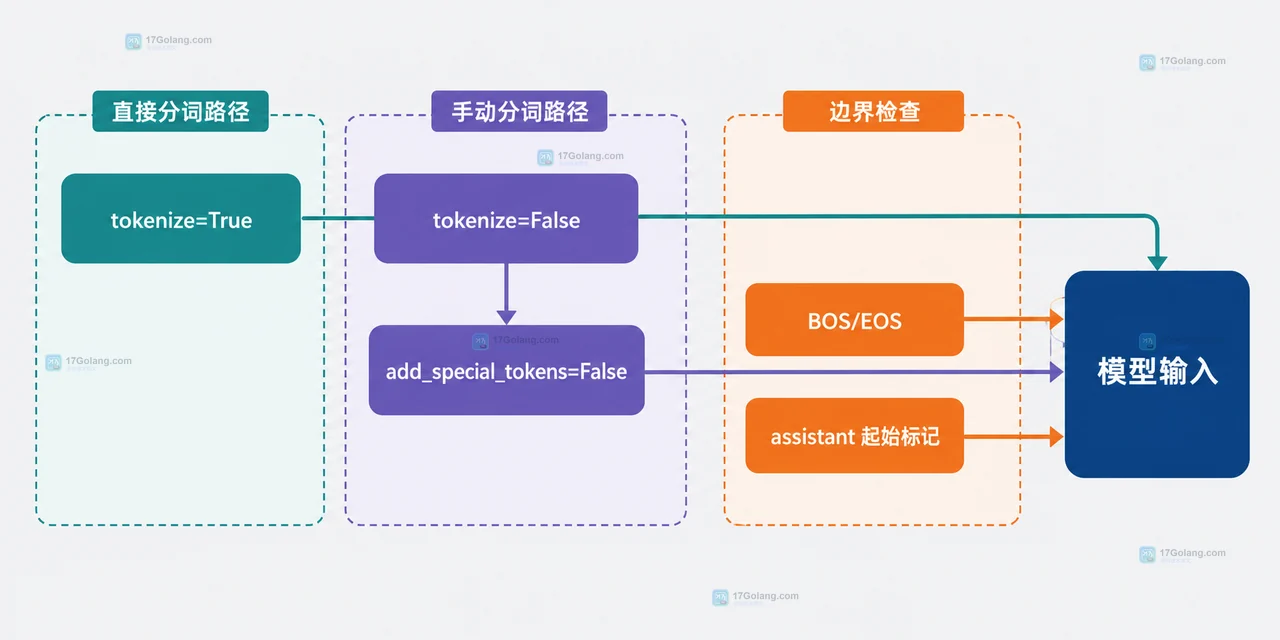 本地大模型聊天效果差时,先检查 chat template 是否正确渲染 messages、assistant 回复起点和特殊 token,本文给出一套可回滚的排查清单。273 收藏
-
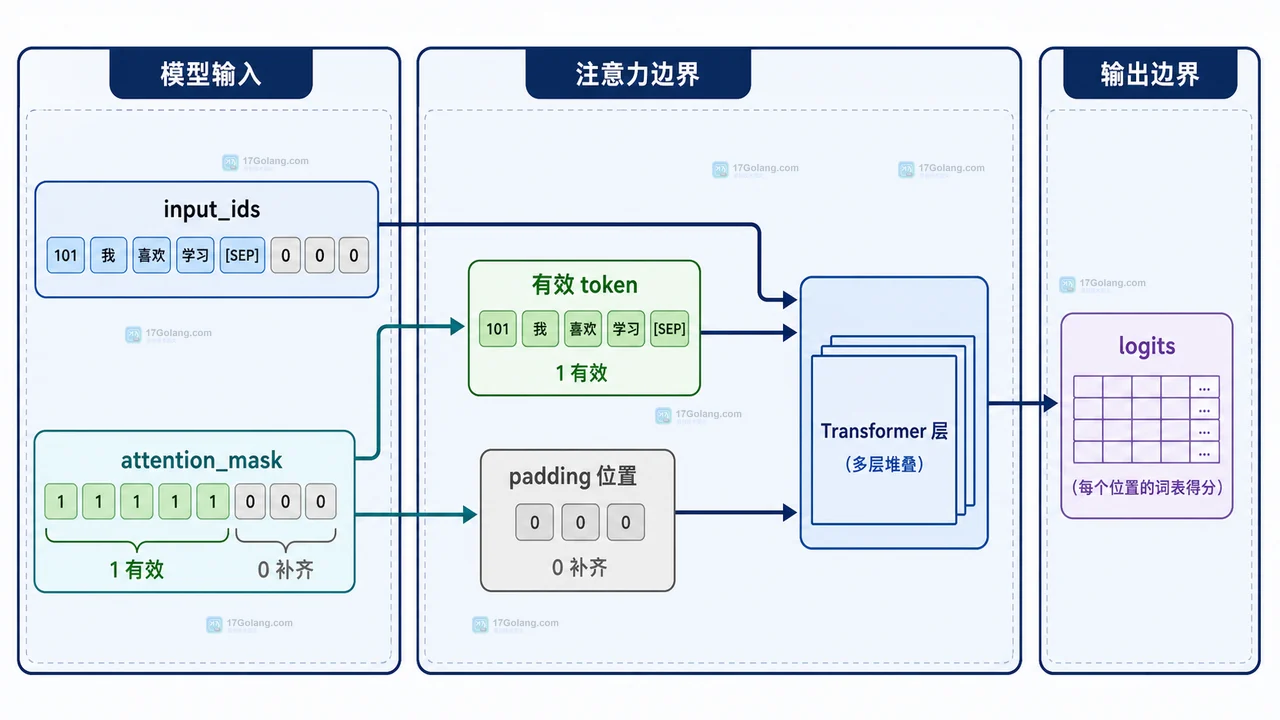 用 Hugging Face Transformers 拆解大模型批量输入中的 padding 与 attention_mask,说明不等长文本、超长截断、左侧补齐和模型调用的配置边界。282 收藏
-
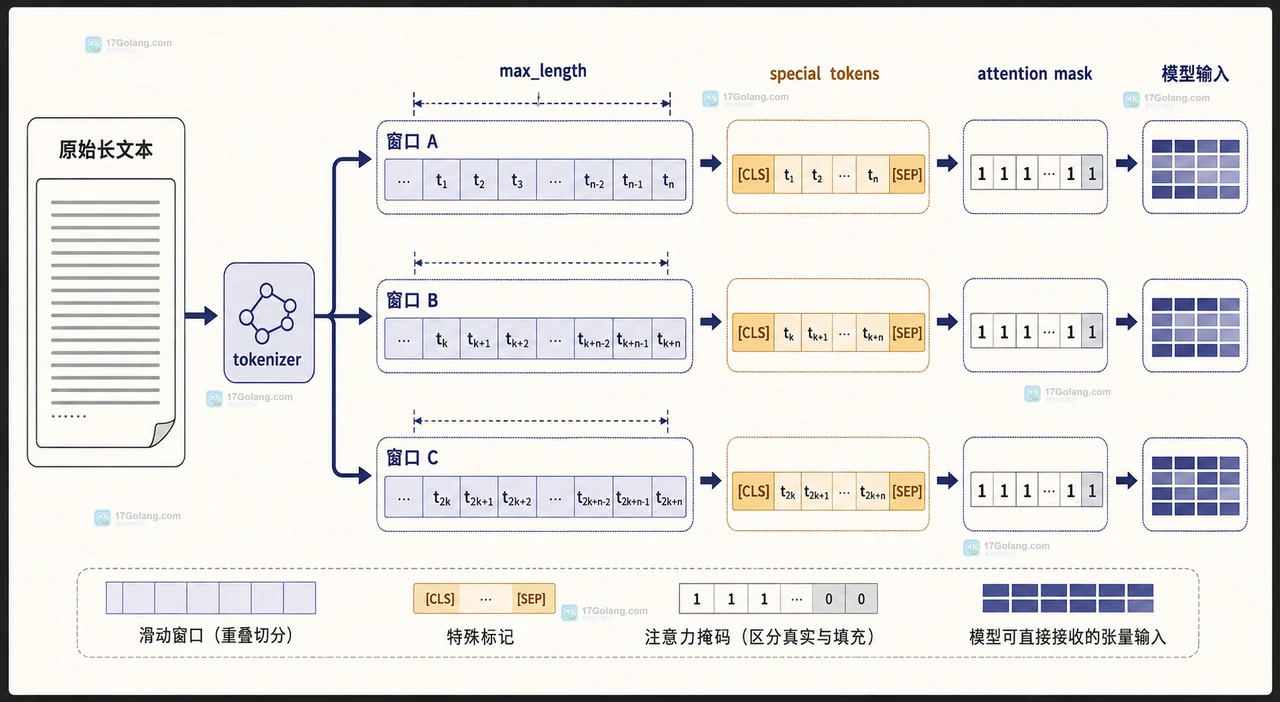 Transformers 文本超过模型输入上限时,不要只开启 truncation 丢掉后半段。本文用 max_length、stride 和 return_overflowing_tokens 按 token 生成重叠窗口,并说明批量输入如何保留原文映射。286 收藏
-
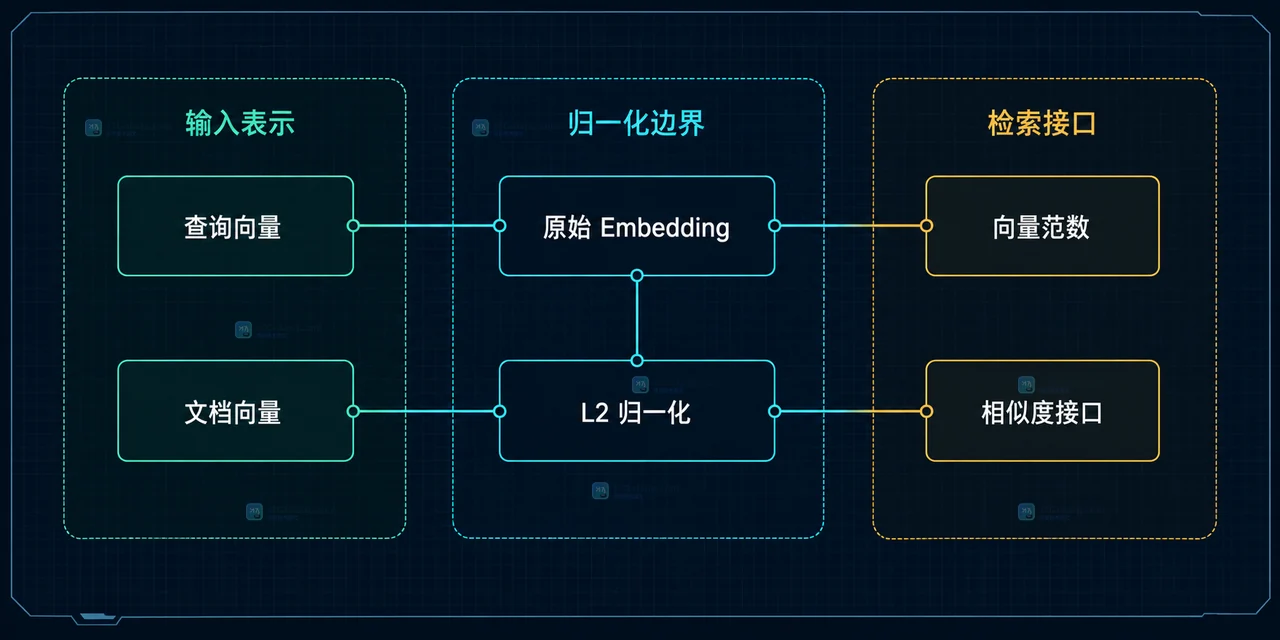 Embedding 已做 L2 归一化时,点积与余弦相似度在数学上等价,工程上通常优先点积以避免重复归一化;若输入状态不确定或链路混用,则应显式使用余弦并先统一预处理。103 收藏
-
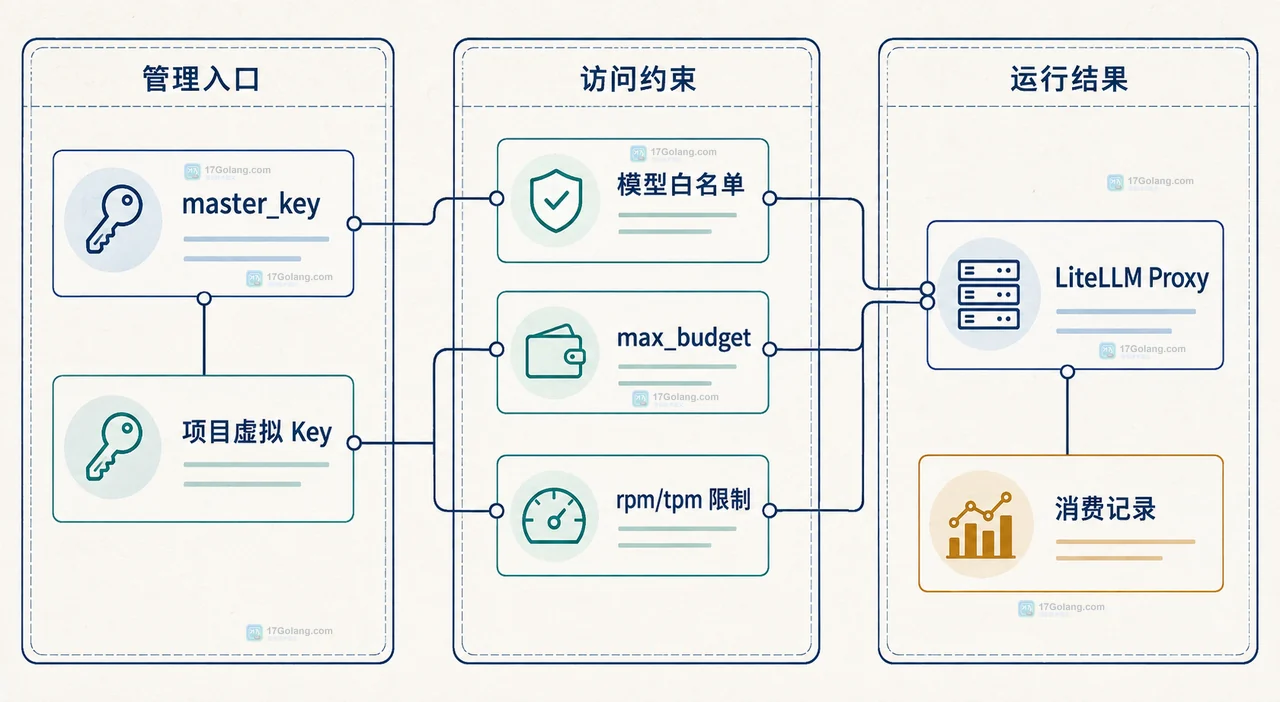 用 LiteLLM Proxy 把多家模型收敛到统一入口,再通过虚拟 Key 做模型白名单、团队预算和速率限制,让客户端不用感知供应商差异。299 收藏
-
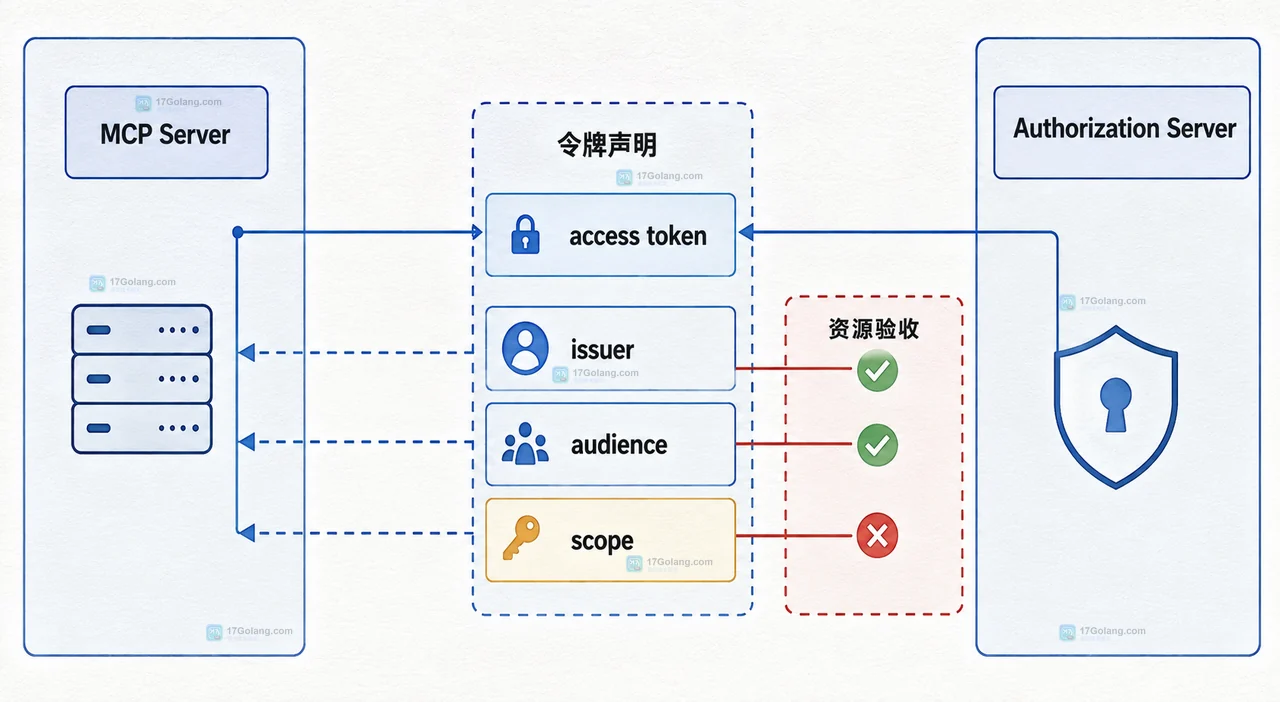 远程 HTTP MCP 的 OAuth 授权不能只把 Bearer token 透传过去。客户端要以 MCP 服务器的 canonical URI 作为 resource,同时放入授权请求和令牌请求;服务端还要校验 token 是否确实签发给自己。本文用一个最小实现拆开这条受众绑定链路,并说明 401、403 与跨服务器误用的边界。123 收藏
-
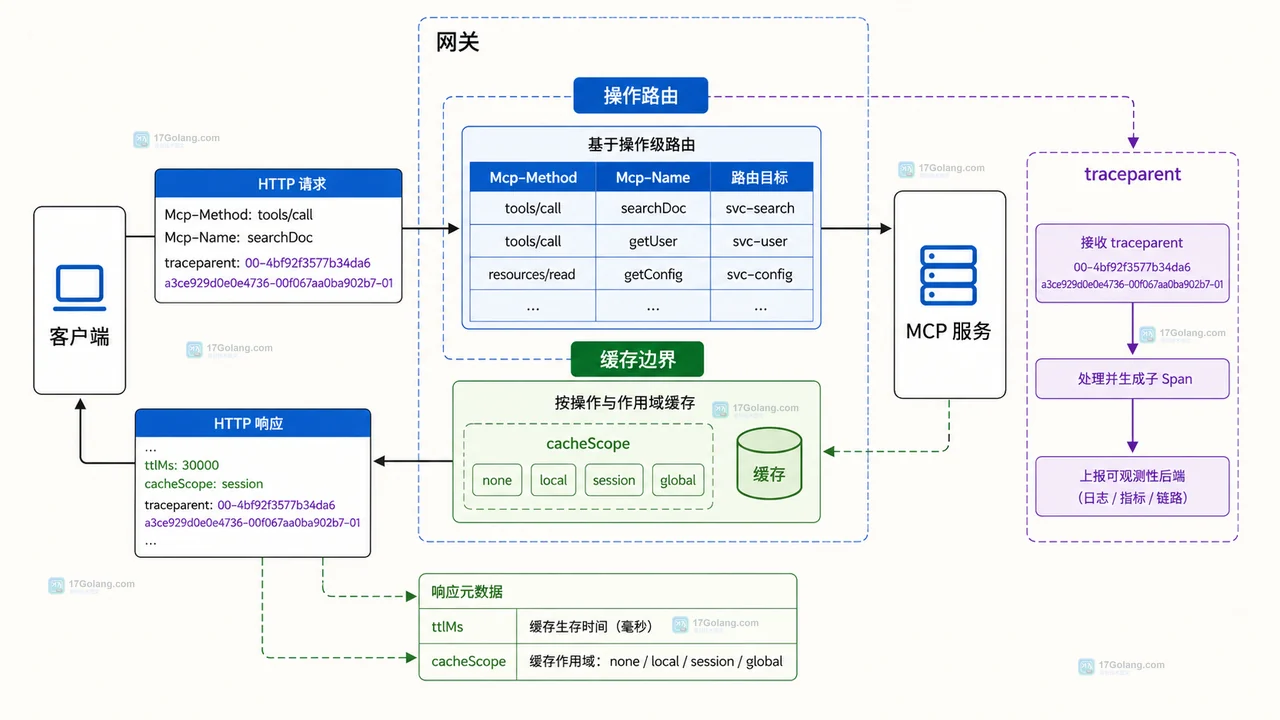 MCP 2026-07-28 将协议层改为无状态,但业务仍可能有状态。本文用显式句柄、请求级路由、缓存范围和 Trace Context 拆解迁移边界。119 收藏
-
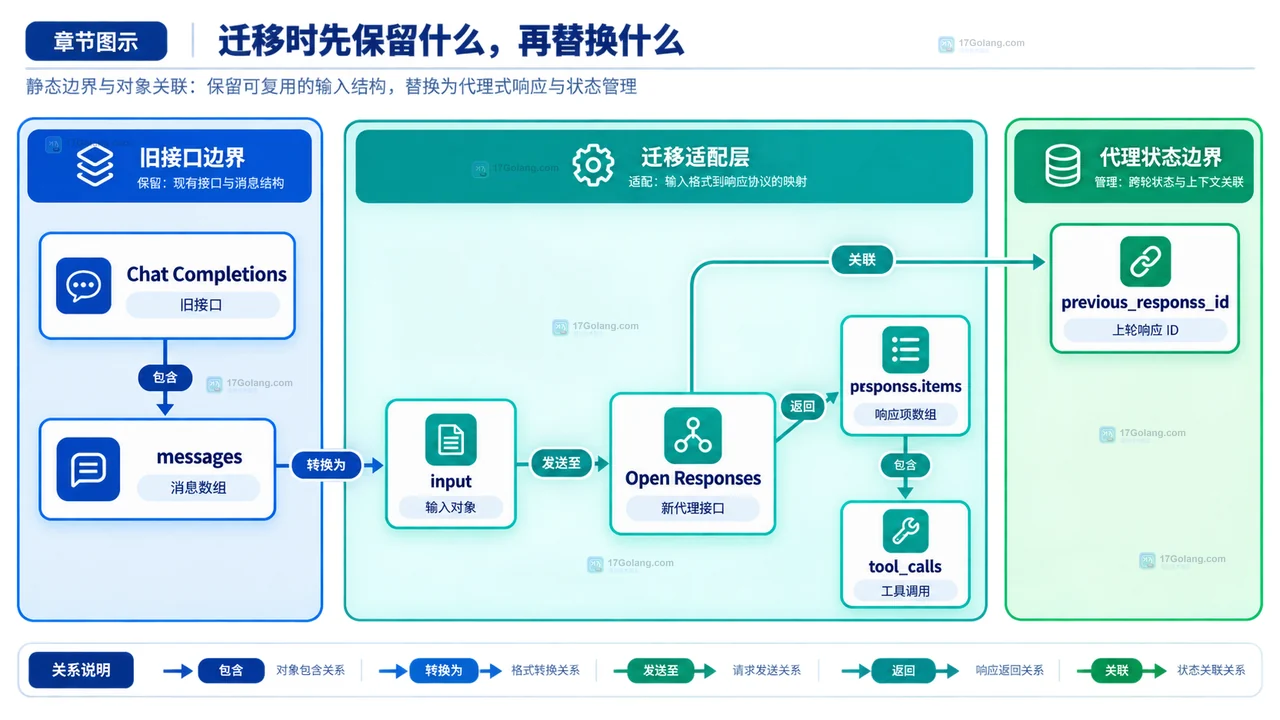 从 messages、tool_calls 到 response.items,拆清 Open Responses 面向代理循环的输入输出对象变化,给出兼容层和最小验证方法。293 收藏