-
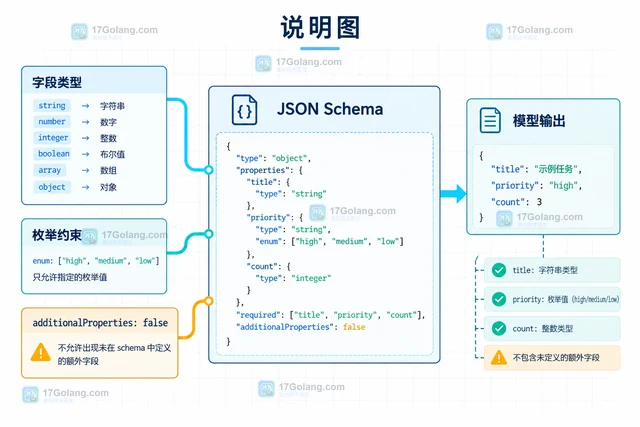
OpenAI API 需要固定输出格式时,应优先使用 Structured Outputs,在 Responses API 的 text.format 中声明 JSON Schema,并处理拒答、截断和旧版参数迁移边界。
-
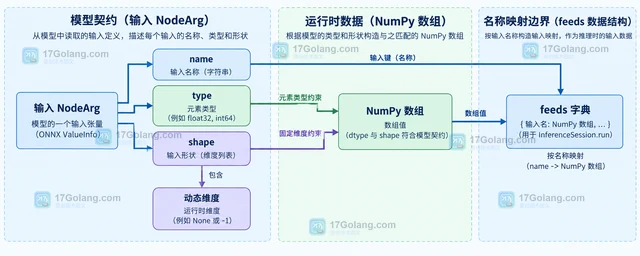
ONNX Runtime 加载模型后,可以通过 InferenceSession.get_inputs() 读取每个输入 NodeArg 的名称、类型和形状。本文说明如何识别动态维度,并按真实输入名构造 feeds 映射。
-
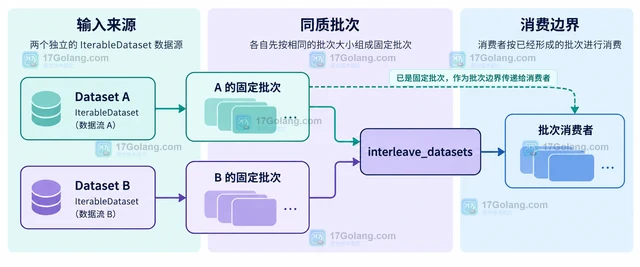
讲清 Hugging Face Datasets 流式 IterableDataset 如何用 batch_size 和 drop_last_batch 组成固定批次、处理尾批,并区分 map 与 DataLoader 的批次语义。
-
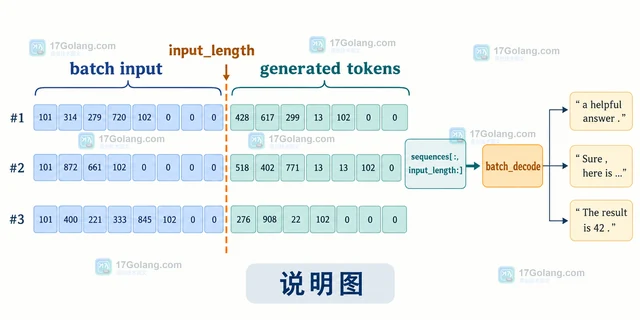
用 Hugging Face Transformers generate 控制新生成 token 数,厘清 max_new_tokens 与 max_length 的区别,并给出批量解码和长度边界的实用写法。
-
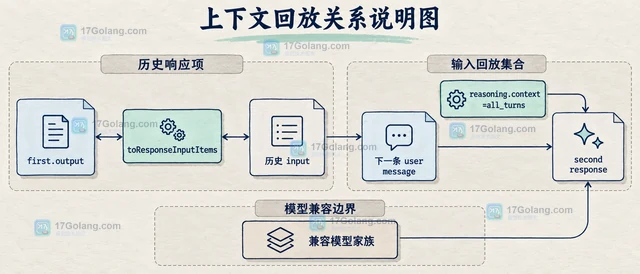
Responses API 在 store=false 或零数据保留场景下仍可延续推理上下文。本文说明如何原样保留 reasoning output item、回放 encrypted_content,并处理 all_turns、模型家族和数据边界。
-
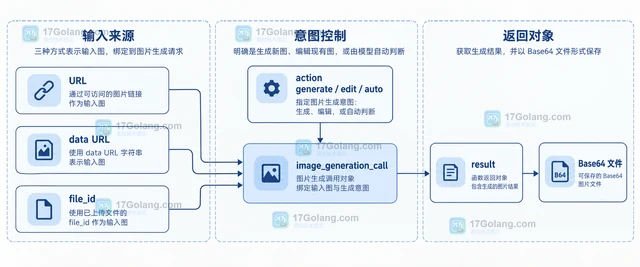
讲清 Responses API 如何用 input_image 绑定参考图,以及 URL、Base64 data URL、file_id 和 action=edit 的选择边界。
-
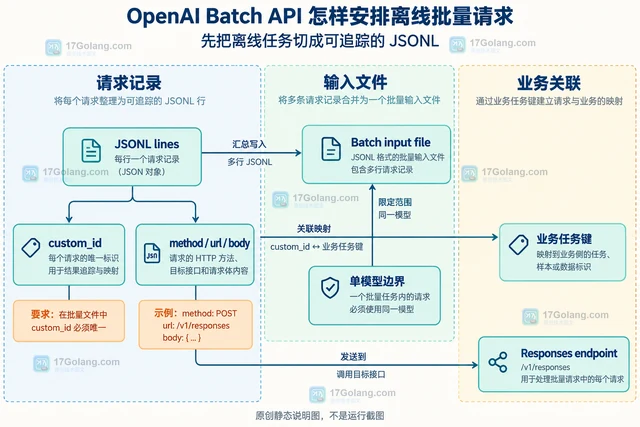
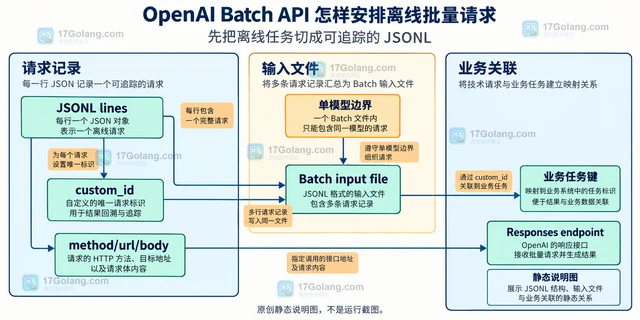
OpenAI Batch API 适合不要求即时返回的批量任务。本文用 JSONL、Files API 和 Python SDK 说明如何创建 24 小时批次,按 custom_id 回填结果,并处理 failed、expired、文件大小和单模型边界。
-
用 finish_reason、status 和 incomplete_details.reason 区分模型自然结束、达到输出上限、工具调用、内容过滤与流式未结束状态,避免把半截答案当成完整结果。
-
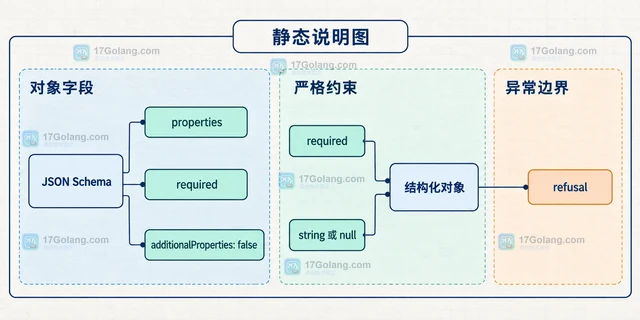
OpenAI API 的结构化输出不是只打开 JSON mode,而是把 JSON Schema 放进 Responses API 的 text.format 或 Chat Completions API 的 response_format,并配合 strict、required 与 additionalProperties false。本文用 Node.js 示例说明定义、读取和边界处理。
-
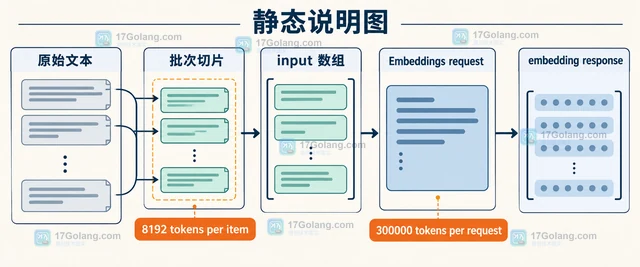
OpenAI Embeddings 支持在一次请求中传入多条文本。本文用 Python 组织可控批次,说明单条输入、整批 token、返回 index、失败重试和 dimensions 的边界。
-
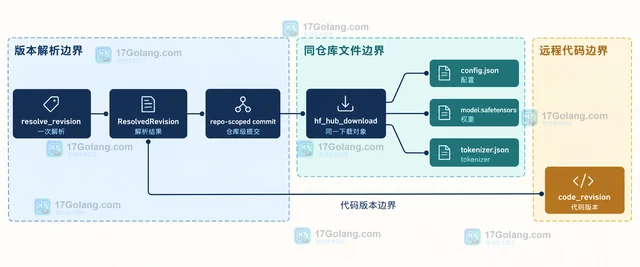
Hugging Face Hub 的 revision 可以指向分支、标签或提交版本。本文从单文件、整仓库和 Transformers 加载三种场景说明怎样固定模型版本,并用 resolve_revision 解决多组件下载时版本漂移的问题。
-
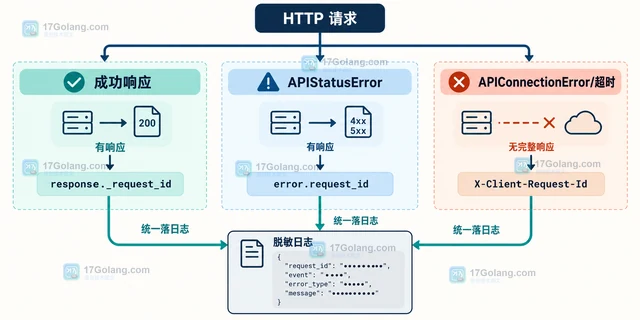
OpenAI API 的 x-request-id 是定位单次请求的重要线索。本文按成功响应、SDK 异常和网络超时三种场景,说明如何读取服务端请求 ID、设置 X-Client-Request-Id,并用脱敏日志保留可复查证据。
-
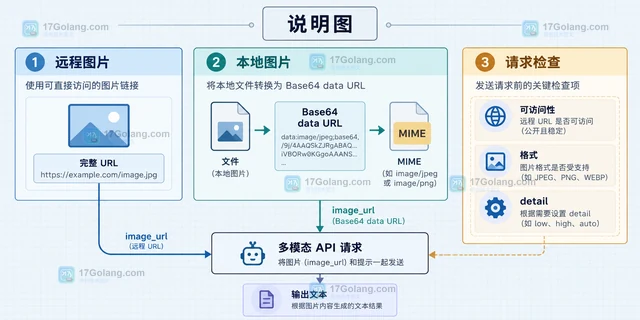
用 OpenAI Responses API 同时提交图片和文本问题,掌握 input_text、input_image、URL、Base64 data URL 与 detail 参数的写法、检查方法和边界。
-
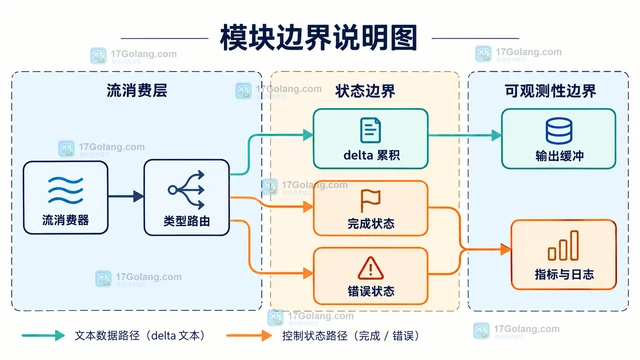
OpenAI API 的 Responses 流由带类型的语义事件组成。本文说明如何只提取 response.output_text.delta 文本增量,并分别处理 response.completed 与 error,避免控制事件混入回答。
-
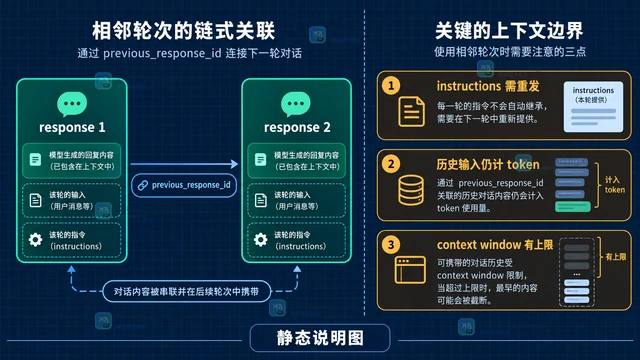
OpenAI Responses API 保留多轮上下文有两条常用路径:用 conversation 保存可跨会话复用的状态,或用 previous_response_id 串联相邻响应。本文用最小 Node.js 示例说明两种写法、指令重发、token 计费和上下文窗口边界。
