-
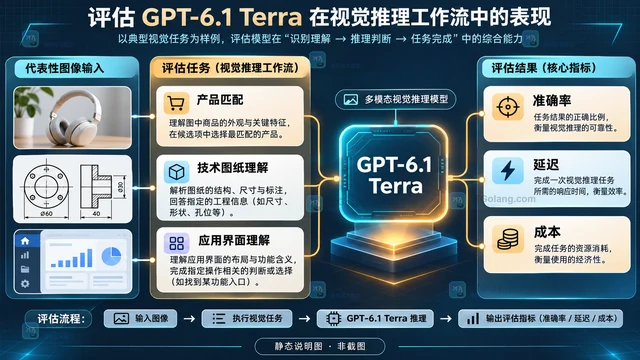
GPT-6.1 Terra 上线后,评估重点不是复述发布会分数,而是用同一批代表性图片、相同 reasoning effort 和准确率、延迟、成本指标做回放,再决定灰度范围。
-
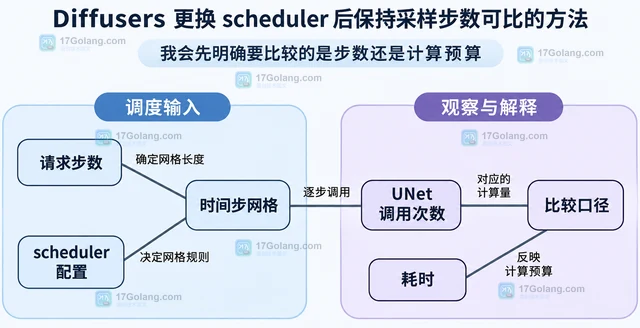
说明 Diffusers 更换 scheduler 时如何区分请求步数、时间步网格和实际网络调用,给出配置继承、独立随机生成器及 UNet 调用记录示例,建立同预算比较方法。
-
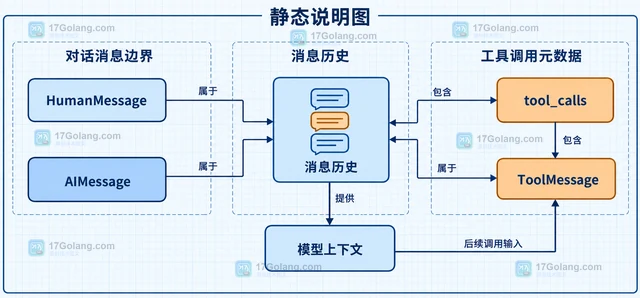
LangChain 工具调用需要保留完整 messages,而不是只取最终文本。本文说明 AIMessage、ToolMessage、tool_call_id、content 与 artifact 的关系,以及如何保存中间消息并继续交给模型。
-
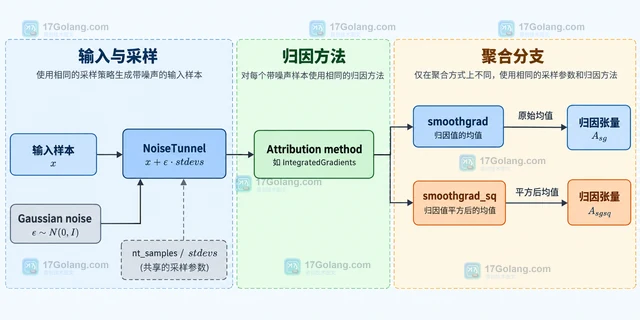
Captum NoiseTunnel 的 SmoothGrad 与 SmoothGradSquared 都会对加噪输入重复计算归因,但前者聚合原始归因均值,后者聚合平方后的归因均值。本文用公式、代码和选型表说明符号、强度与参数边界。
-
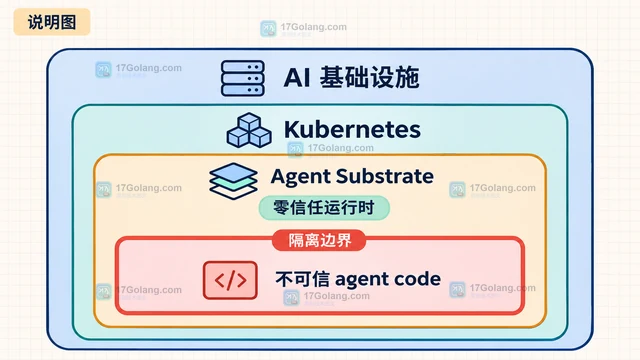
CNCF 将 OpenShell 与 Agent Substrate 纳入 Sandbox 后,生产 AI agent 的基础设施边界更容易按两层理解:OpenShell 关注运行时策略与资源治理,Agent Substrate 关注 Kubernetes 上的不可信代码隔离。本文只按官方公告解释项目定位,并说明 Sandbox 不等于生产就绪。
-
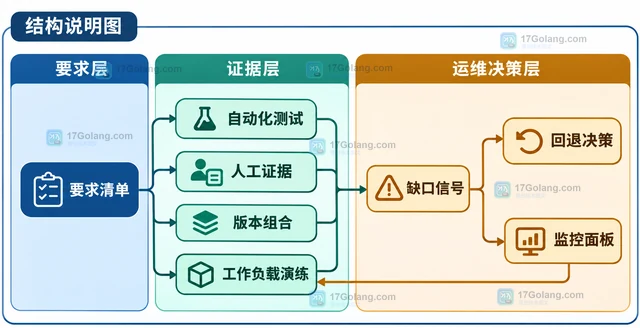
CNCF Kubernetes AI Conformance 试图把 GPU、推理网络、分布式调度、自动扩缩容、指标和隔离等能力整理成跨平台基线。本文解释它解决什么问题、平台团队怎样阅读清单,以及上线前如何保留版本组合和回退依据。
-
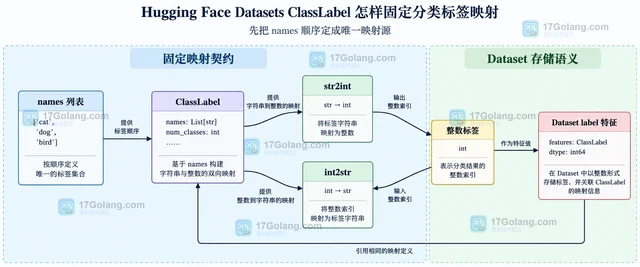
Hugging Face Datasets 的 ClassLabel 不应根据每个数据切片临时推导。本文用固定 names 顺序统一训练、验证和推理标签,并说明 map、cast_column、names_file、int2str 与 str2int 的边界。
-
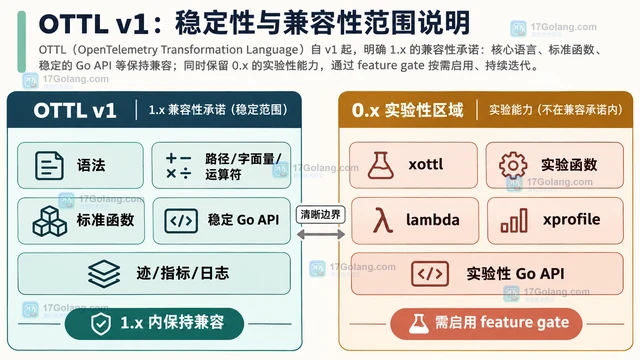
OpenTelemetry OTTL 从 contrib v0.164.0 起进入 v1。本文拆开 1.x 兼容承诺、xottl 等实验区域和升级时的删除项,帮助你按语句、函数、feature gate 与 Go API 逐层排查。
-
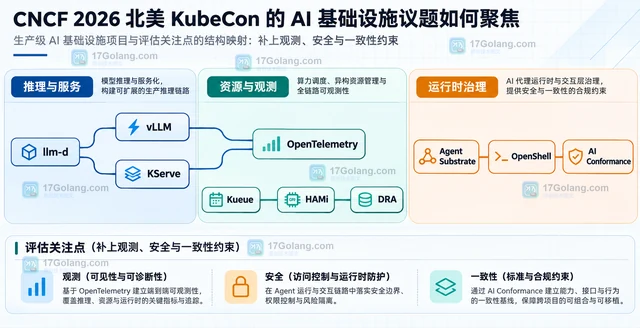
CNCF 2026 北美 KubeCon 的 AI 基础设施议题从生产推理、GPU 调度和 Agent 工作流展开,并延伸到平台工程、可观测性、安全隔离与 AI Conformance。本文用分层方法说明会后如何筛选相关内容和工程证据。
-
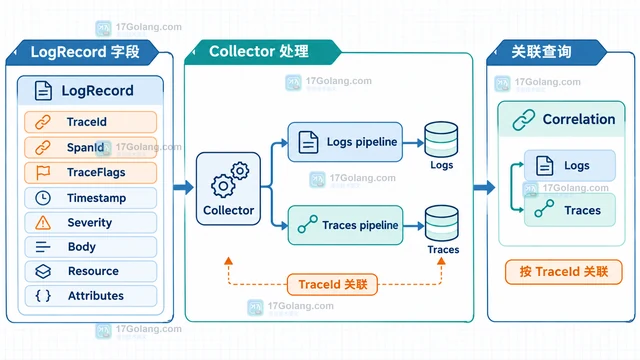
OpenTelemetry Logs 与 traces 的关联关键在于沿用同一请求上下文,把 TraceId、SpanId、TraceFlags 和 Resource 写进结构化日志,再由 Collector 分流处理。本文从高并发链路的旧瓶颈、字段模型、Collector 管道和上线信号说明如何落地。
-
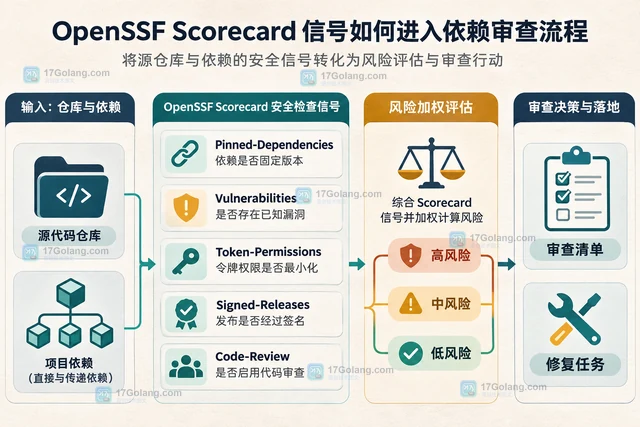
OpenSSF Scorecard 会把仓库维护、依赖、构建和发布实践拆成检查项,并按风险等级给出分数与修复提示。本文不把总分当作安全结论,而是说明怎样选择关键检查、接入 SARIF、把风险信号转成审查问题和修复 PR,再用复查形成闭环。
-
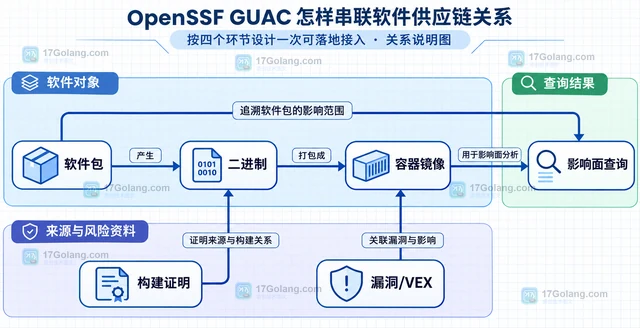
OpenSSF GUAC 的作用不是重新生成一份 SBOM,而是把 SBOM、构建证明、漏洞和 VEX 等元数据围绕软件实体组织成可查询关系图。本文解释输入、身份对齐、关系查询和数据边界。
-
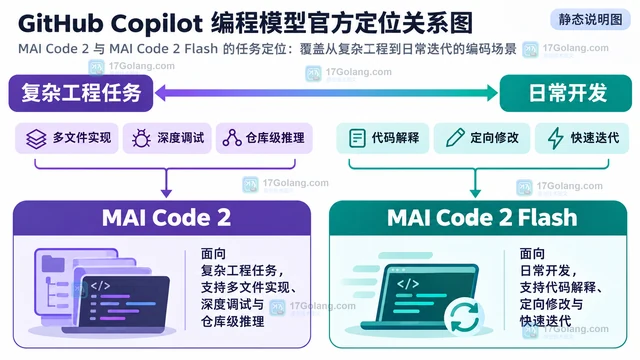
围绕 GitHub 官方公告解释 MAI Code 2 与 MAI Code 2 Flash 的任务定位、Copilot 入口、订阅资格、企业模型策略和按用量计费边界。
-
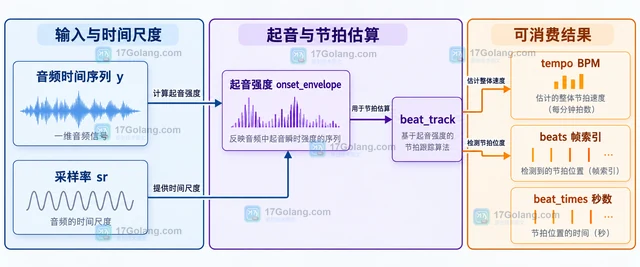
用 librosa.beat.beat_track 从音频的起音强度中估算 BPM 和节拍位置,并把帧索引稳定转换为秒;同时说明空结果、BPM 为 0 和 hop_length 不一致时怎样排查。
-
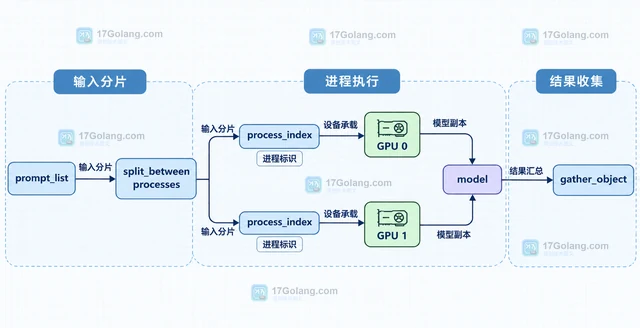
用 CUDA_VISIBLE_DEVICES 和 accelerate launch 明确可见 GPU 与进程数量,再通过 PartialState 读取每个进程的设备,给出多进程推理时的绑定、分片和排错方法。
