-
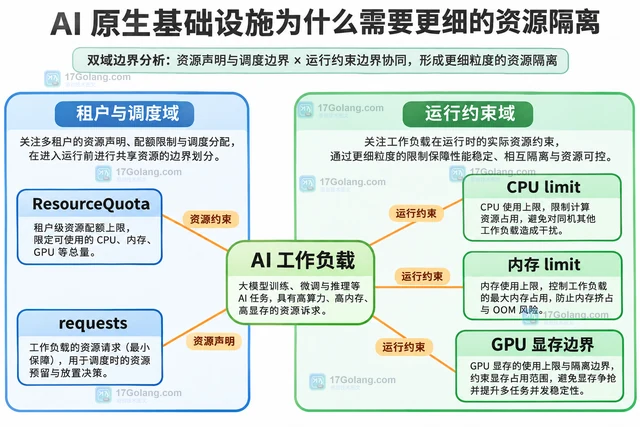
AI任务对CPU、内存、显存和存储的需求不同,资源配额不能替代运行隔离。本文结合Kubernetes与NVIDIA官方进展,说明配额、限制、GPU共享及观测验收之间的边界。
-
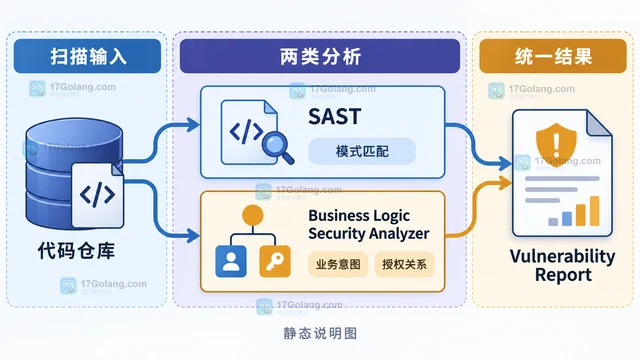
GitLab 业务逻辑分析器已面向部分 Ultimate 客户早期开放。本文用最小接入配方说明它与传统 SAST 的分工、合并请求与默认分支的扫描入口、BL_SCAN_EFFORT 和 BL_TARGET_FILES 的配置边界,以及结果报告和成本限制。
-
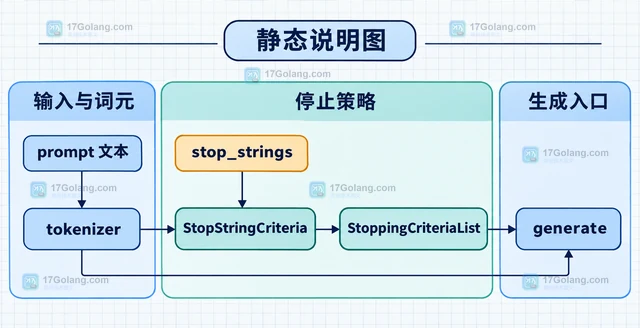
用 StopStringCriteria 和同一 tokenizer 组合生成终止条件,让 Transformers 在文本出现指定结束字符串后停止,并说明标记后处理与框架边界。
-
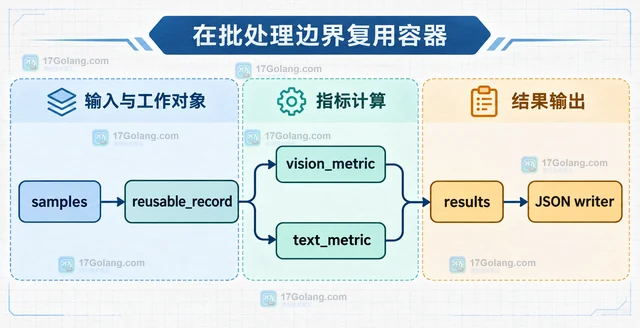
多模态评测同时包含图像理解和文本生成时,不要把所有分数塞进同一个字段。本文用 Hugging Face Evaluate 的指标分类思路设计分区结果对象,并通过复用容器、批量计算和一次序列化减少批处理中的额外分配。
-
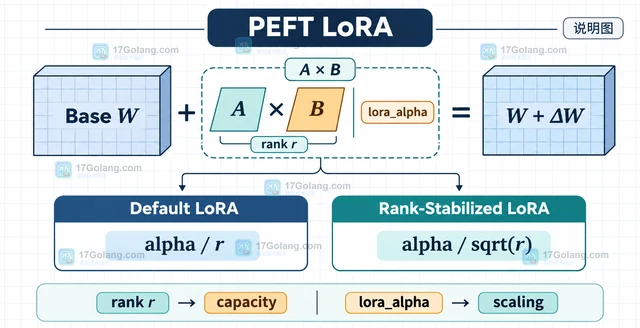
解释 PEFT LoRA 中 rank、lora_alpha 与适配器缩放因子的关系,比较默认 LoRA 和 rsLoRA 的公式,并给出可复查的 LoraConfig 配置与参数检查方法。
-
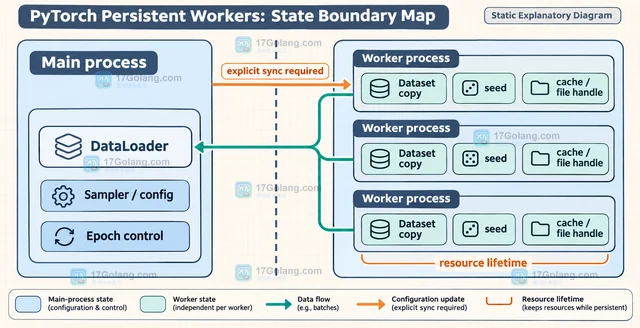
通过 persistent_workers=True 复用 PyTorch DataLoader 的多进程 worker,本文说明 DataLoader 的放置位置、Dataset 状态边界、参数取舍和关闭条件。
-
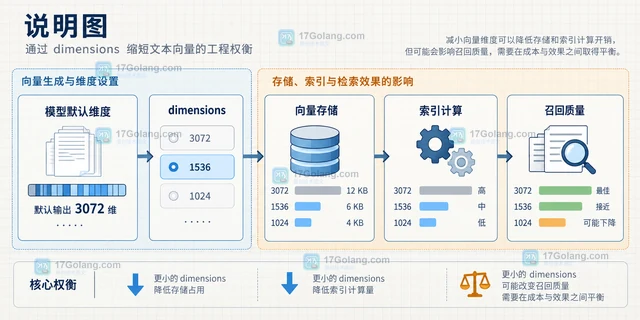
OpenAI embeddings 的 dimensions 不是越大越好。本文从默认维度、向量库限制、检索质量、存储与回滚几个方面,说明 text-embedding-3-small 和 text-embedding-3-large 怎样选择维度缩减参数。
-
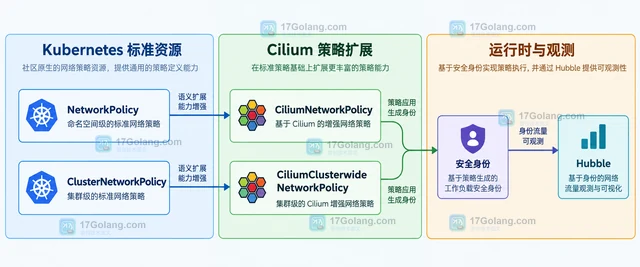
Cilium 1.20 扩展了 ClusterNetworkPolicy、Cluster Mesh 策略实体和 Gateway API 能力,但替换成本不只在 YAML 转换。本文按策略语义、身份、观测、跨集群、入口链路和回滚拆解评估方法。
-
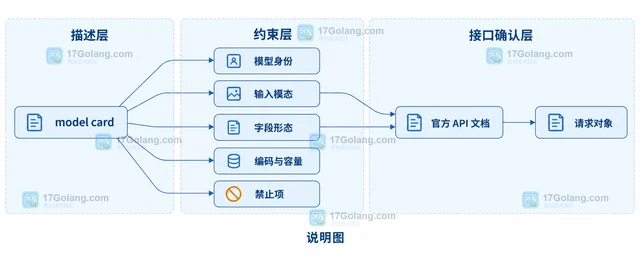
model card 更适合作为输入契约的索引,而不是可直接提交的接口 schema。本文按输入模态、字段形态、编码与容量、禁止项和已知局限拆读,再用官方 API 文档确认最终请求字段。
-
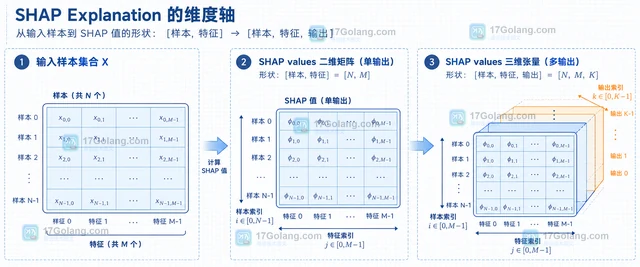
SHAP Explanation 的 values 形状需要结合样本、特征和模型输出一起读取。本文用单输出与多输出示例说明 shape、feature_names、output_names 的对应关系,以及如何按样本和输出安全切片。
-
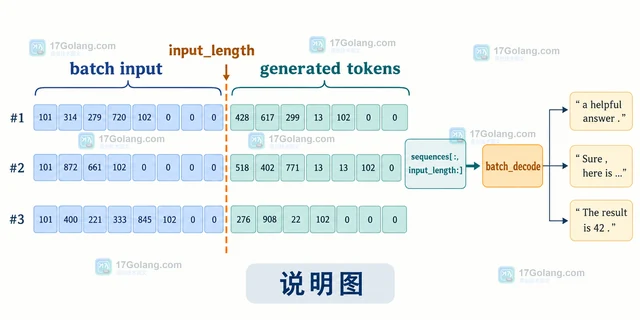
用 Hugging Face Transformers generate 控制新生成 token 数,厘清 max_new_tokens 与 max_length 的区别,并给出批量解码和长度边界的实用写法。
-
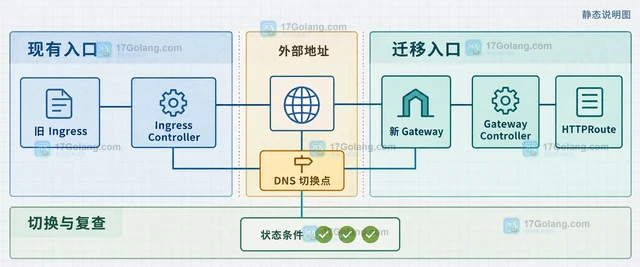
从 Ingress 迁移到 Gateway API 时,不要只替换资源名称。本文用一条订单路由说明 Gateway、监听器、HTTPRoute、TLS Secret 与 Service 的映射,并介绍如何用 ingress2gateway 发现遗漏、保留新旧入口并行以及按状态条件安排切换。
-
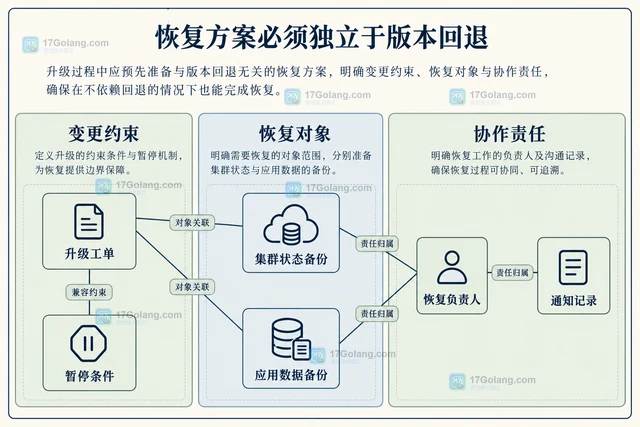
围绕 Kubernetes 1.37 Garhwal 的版本偏差、cgroup v1 默认限制、API 与插件兼容,说明如何建立分批升级、暂停条件、恢复责任和通知记录。
-
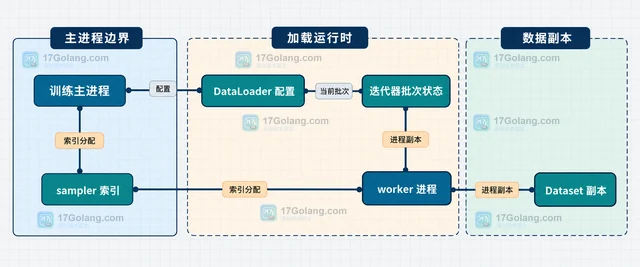
本文说明 PyTorch DataLoader 的 persistent_workers 如何影响 worker 进程、迭代器和 Dataset 副本的生命周期,给出跨 epoch 复用的最小配置,并说明内存、状态管理、IterableDataset 分片和调试边界。
-
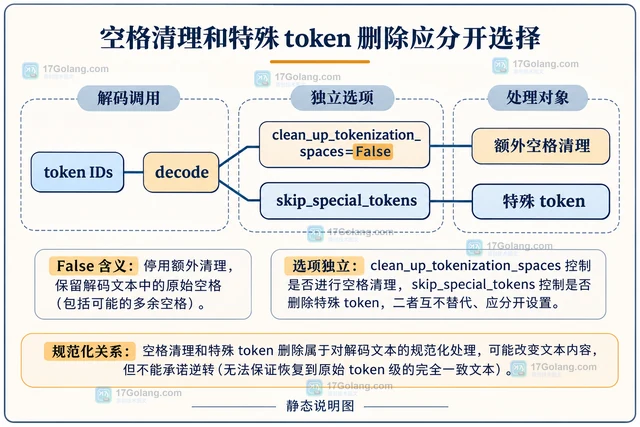
Transformers decode 可用 clean_up_tokenization_spaces=False 停用额外空格清理。结合示例区分特殊 token 删除、后端解码与原文保存,给出展示和诊断场景的参数选择。
