-
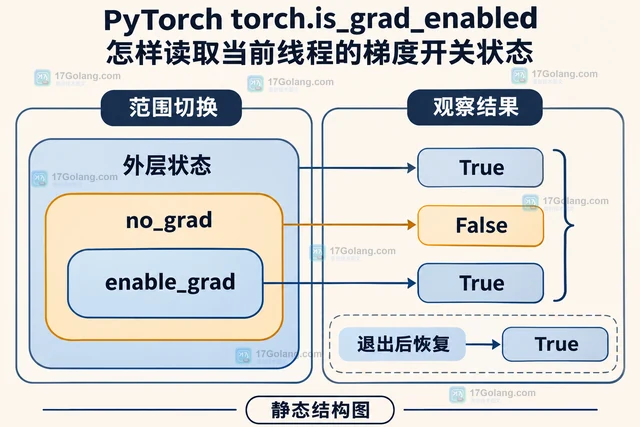
torch.is_grad_enabled() 用于读取当前执行上下文是否开启梯度记录。本文用最小示例说明它在默认模式、no_grad 和 enable_grad 中的变化,并区分它与 requires_grad、model.eval()、inference_mode 的职责。
-
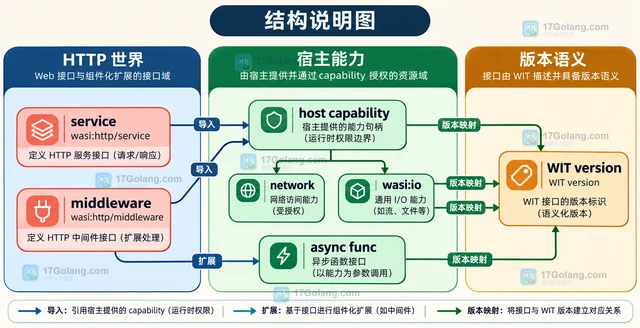
WASI HTTP 的组件化边界不等于一组 URL 路由,而是由 WIT 接口、world 的导入导出、request/response 资源和宿主 capability 共同组成。本文结合 WASI 0.3 的 service 与 middleware 设计,说明怎样划分服务契约、横切逻辑和运行时权限,并提醒 0.2/0.3 的版本边界。
-
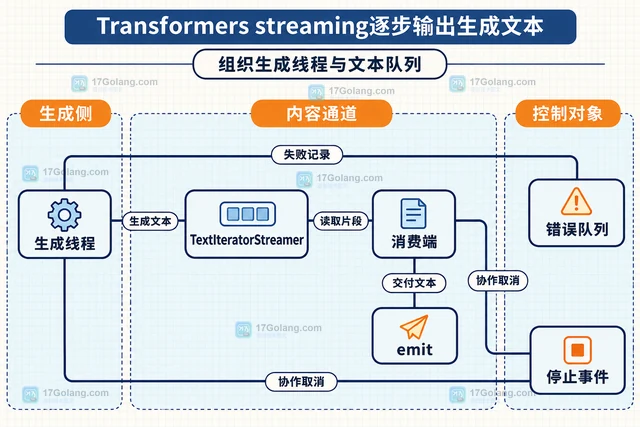
Transformers用TextIteratorStreamer将生成与文本消费分开,实现逐步输出。本文提供单请求原创函数,说明队列超时、协作取消、后台异常回传和完成事件,并给出服务接入的观察指标。
-
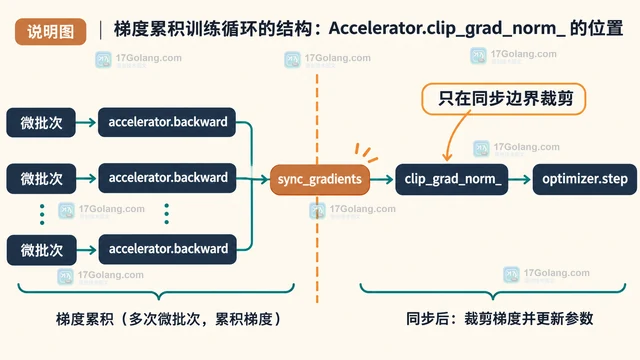
在 Accelerate 的梯度累积和混合精度训练中,使用 Accelerator.clip_grad_norm_ 统一裁剪模型梯度;本文说明调用时机、参数含义、返回值和与 sync_gradients 的配合方式。
-
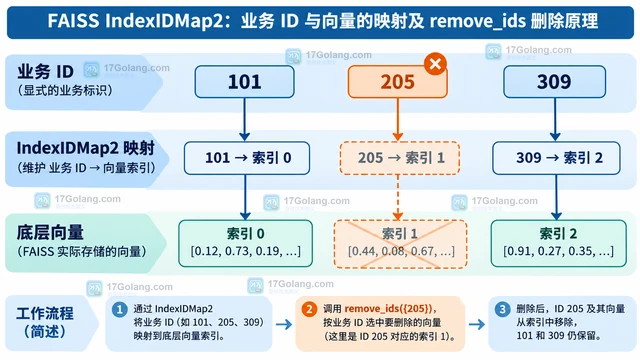
FAISS IndexIDMap2 适合把业务 ID 与向量绑定后再维护索引。本文用 Python 说明怎样写入自定义 ID、按 ID 批量删除、读取删除数量,并解释删除后其他 ID 为什么不会像顺序位置那样整体前移。
-
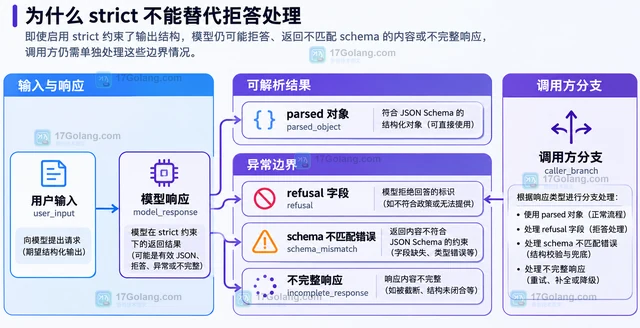
Structured Outputs 解决的不是“返回一段看起来像 JSON”,而是让模型输出尽量贴合调用方定义的 JSON Schema。本文用 schema、strict=true 和 refusal 三个边界,整理 Responses API 与 Chat Completions API 的写法、适用条件和常见误区。
-
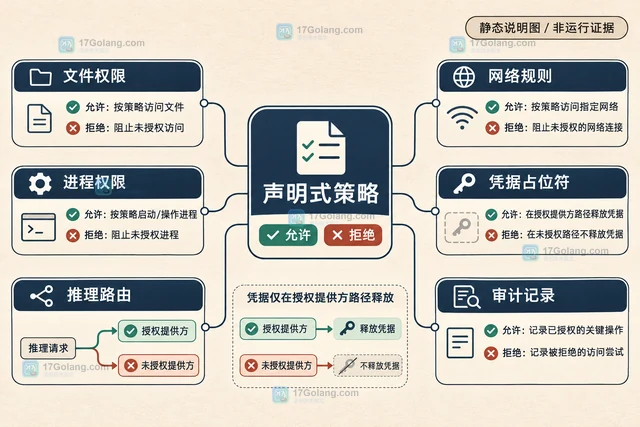
CNCF 将 OpenShell 纳入 Sandbox 后,AI 代理的安全重点从提示词约束转向运行时边界。本文用沙箱、网关、策略、凭据和推理路由五个角度,说明它适合解决什么问题、不能替代什么系统,以及团队如何评估落地。
-
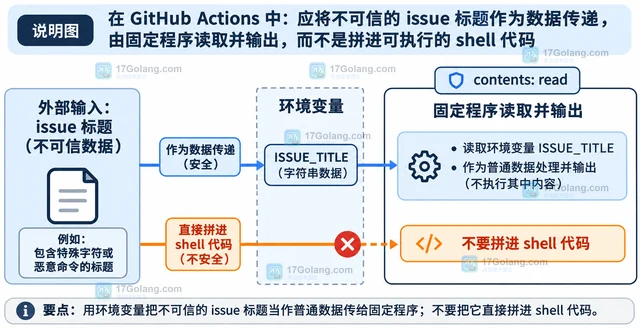
OpenSSF Scorecard 的 Dangerous-Workflow 检查主要关注 GitHub Actions 中的不可信代码检出与脚本注入风险。本文按触发器、权限、检出对象和变量边界拆解检查结果,并给出一份便于复查的最小工作流写法。
-
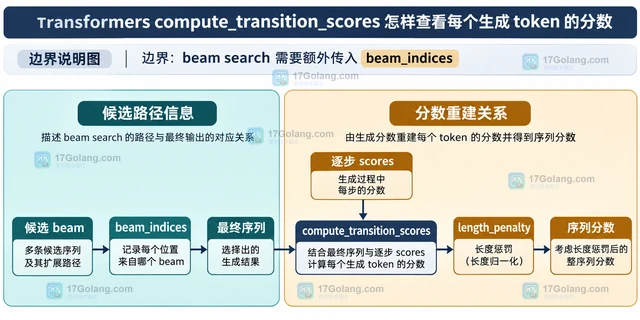
用 Transformers 的 compute_transition_scores 对齐 generate 选中的 token,查看每个 token 的转移分数、对数概率和概率,并区分贪心生成与 beam search 的参数差异。
-
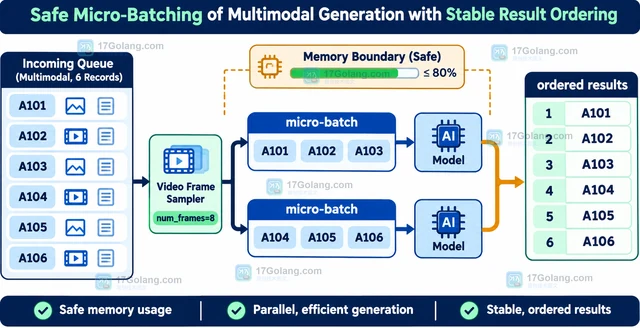
Transformers 处理多模态批次时,关键不是把图片简单塞进列表,而是让每条样本的消息结构、处理器字段和结果顺序保持一致。本文用 AutoProcessor、聊天模板、padding 与 micro-batch 说明一套可落地的批处理写法。
-
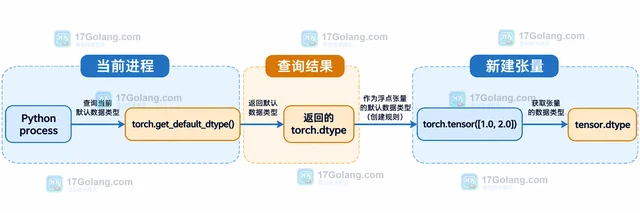
用 torch.get_default_dtype() 读取 PyTorch 当前默认浮点类型,分清已有张量 dtype、显式 dtype 与新建张量默认类型之间的关系。
-
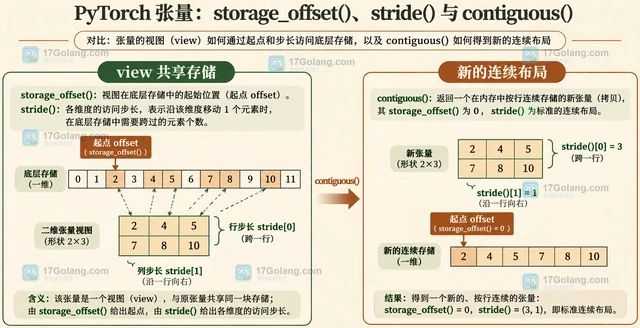
用切片和转置示例说明 PyTorch Tensor.storage_offset() 的读取方式,解释返回值是底层 storage 的元素偏移而非字节数,并把 storage_offset、stride、numel 与 contiguous() 放在同一套布局排查方法中。
-
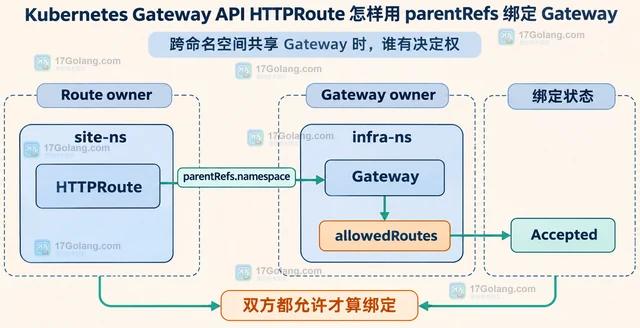
HTTPRoute 通过 spec.parentRefs 声明要绑定的 Gateway;同命名空间通常只写名称,跨命名空间还要写目标 namespace,并满足 Gateway Listener 的 allowedRoutes 约束。本文用原创说明图和 YAML 示例讲清绑定方式、sectionName 选择与 Accepted 状态排查。
-
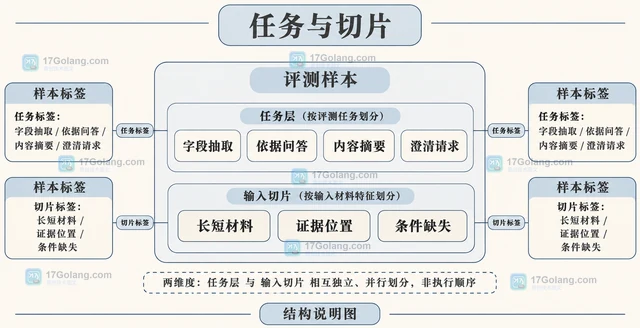
以客服助手为例,说明生成式模型评测集如何划分任务与切片、保存评分条件、配置常规集和挑战集,解释分层结果与加权汇总的区别,并维护固定测试集。
-
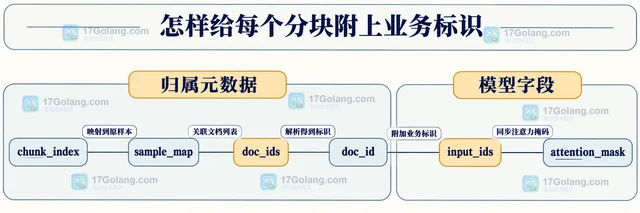
说明 Transformers BatchEncoding 的 overflow_to_sample_mapping 如何关联分块与原批样本,给出 truncation、stride 和业务文档 ID 的处理示例,并澄清分块编号与样本下标的区别。
