-
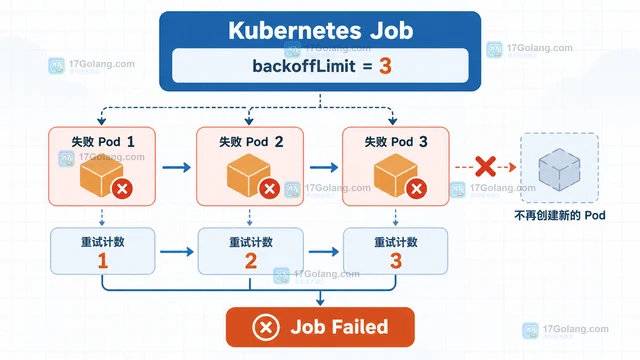
Kubernetes Job 通过 spec.backoffLimit 设置失败重试上限,默认值为 6;本文用一个最小 YAML 说明失败计数、restartPolicy、指数退避和 activeDeadlineSeconds 的关系。
-
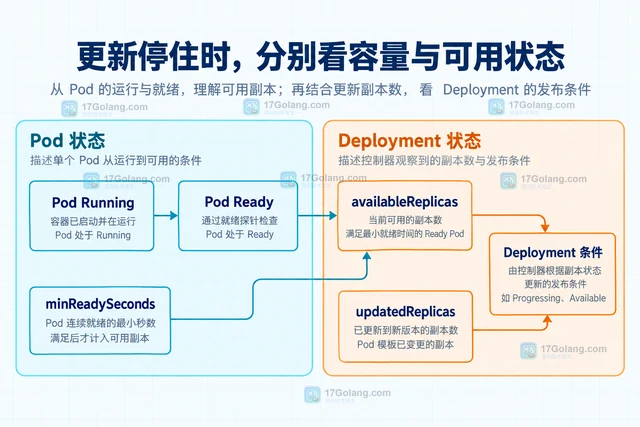
Kubernetes Deployment 的 maxUnavailable 是滚动更新可用副本预算。本文用副本计算和排查场景说明百分比舍入、maxSurge、Ready与Available,以及发布停滞的判断。
-
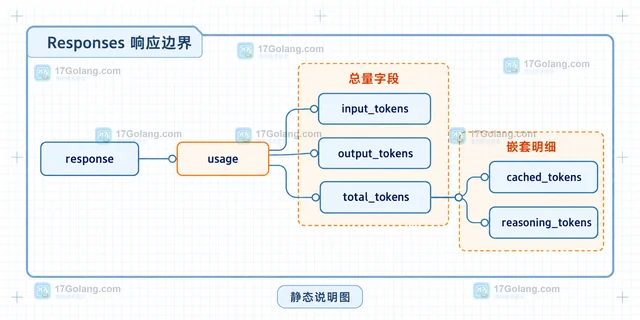
OpenAI API 的 usage 字段位于响应对象中。本文区分 Responses API 与 Chat Completions 的字段命名,演示读取输入、输出、总量及缓存/推理明细,并说明流式响应为什么可能拿不到最终 usage。
-
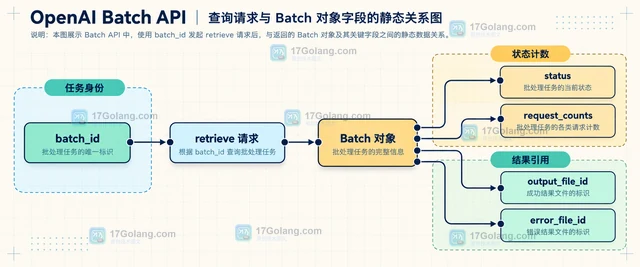
OpenAI Batch API 查询状态的关键是使用 batch_id 调用 retrieve 接口,再结合 status、request_counts 和结果文件字段判断下一步。本文给出 curl、Python 示例,并说明各个中间态、终态和失败边界。
-
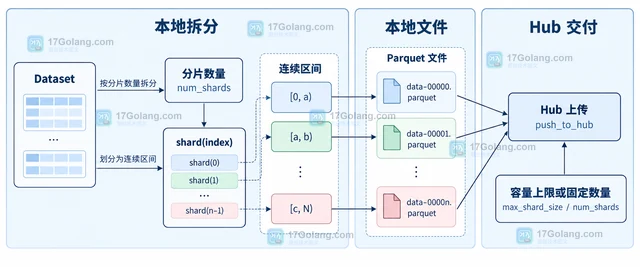
Hugging Face Datasets 里,to_parquet 的 batch_size 主要控制写入批次与内存,不等于输出文件数量;本地固定文件数要用 Dataset.shard,上传 Hub 则可用 max_shard_size 或 num_shards。
-
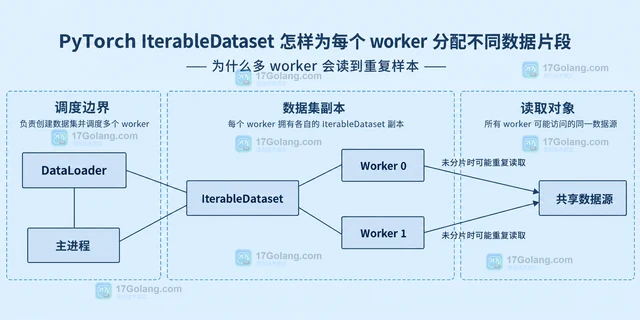
使用 PyTorch IterableDataset 配合 DataLoader 多 worker 时,数据集对象会复制到各个进程,直接迭代容易读到重复样本。本文用 get_worker_info 在 __iter__ 中计算半开区间,说明不整除、尾部数据和 drop_last 的边界。
-
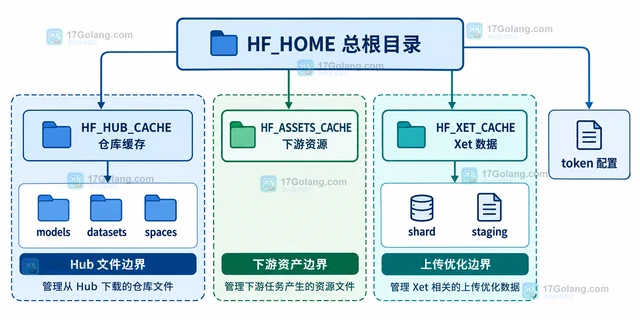
Hugging Face Hub 的模型缓存可以通过 HF_HOME、HF_HUB_CACHE、HF_ASSETS_CACHE 和 HF_XET_CACHE 分开管理。本文从目录边界、环境变量导入时机、repo 缓存结构、下载函数与清理边界几个方面说明如何让模型文件可控地复用。
-
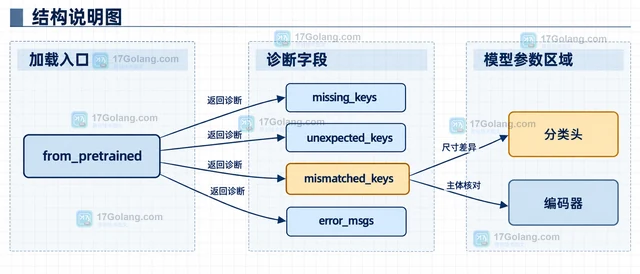
Hugging Face Transformers 加载分类模型时,如果新任务的标签数量与 checkpoint 不同,可以用 ignore_mismatched_sizes 处理分类头尺寸差异。本文说明参数边界、加载诊断和不能直接忽略的结构问题。
-
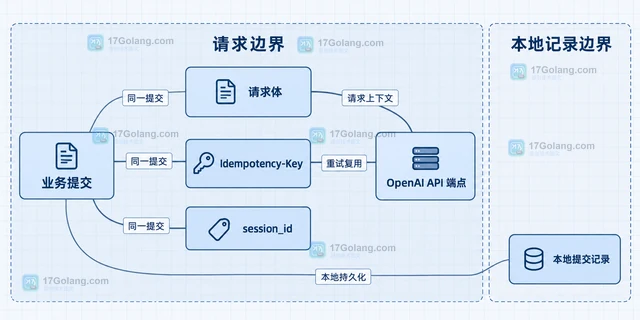
OpenAI API 请求遇到超时或连接中断时,不能简单生成新键重发。本文以官方 Agents Sessions Events 文档为边界,说明如何生成 Idempotency-Key、如何复用同一键重试,以及它和 X-Client-Request-Id、x-request-id 的区别。
-
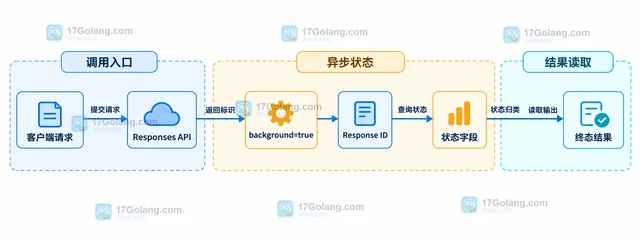
OpenAI Responses API 的 background 模式可以让长耗时任务异步运行。本文用一个可复用的轮询骨架说明如何保存 response_id、区分处理中与终态,并比较取消、流式恢复和数据保留的取舍。
-
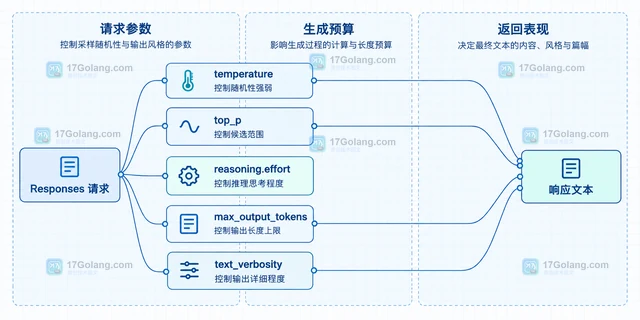
OpenAI API 中 top_p 直接影响候选概率范围,reasoning.effort 与 max_output_tokens 分别控制推理投入和输出预算。本文用 Responses API 示例说明如何区分职责并避免同时调 temperature 与 top_p。
-
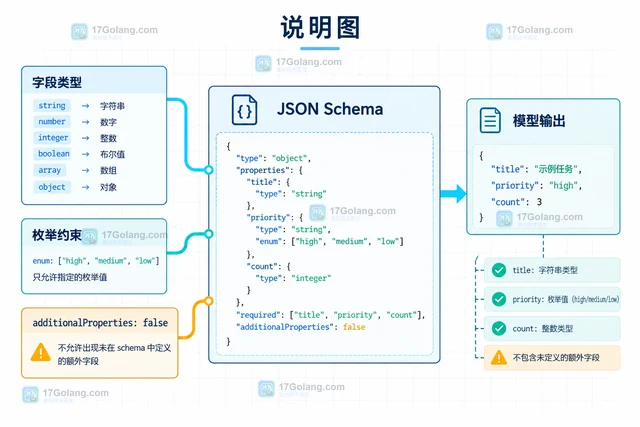
OpenAI API 需要固定输出格式时,应优先使用 Structured Outputs,在 Responses API 的 text.format 中声明 JSON Schema,并处理拒答、截断和旧版参数迁移边界。
-
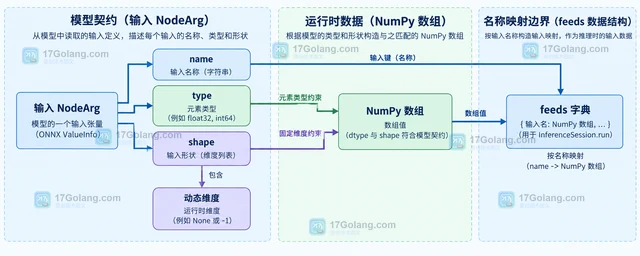
ONNX Runtime 加载模型后,可以通过 InferenceSession.get_inputs() 读取每个输入 NodeArg 的名称、类型和形状。本文说明如何识别动态维度,并按真实输入名构造 feeds 映射。
-
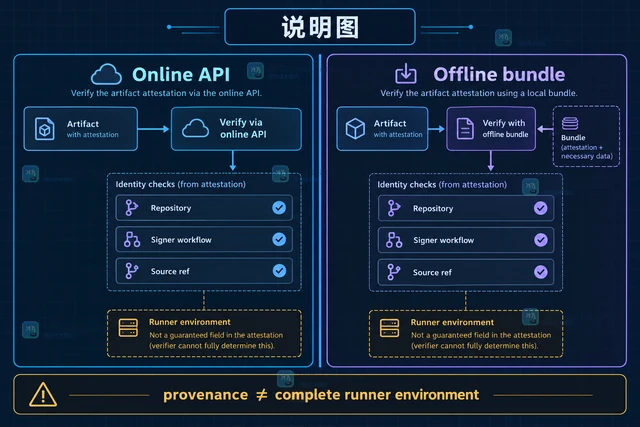
用 GitHub Actions 的 artifact attestations 为构建产物建立来源证明,再用 GitHub CLI 按仓库、签名工作流和来源提交核对;同时说明离线 bundle、trusted root 与 runner 环境的边界。
-
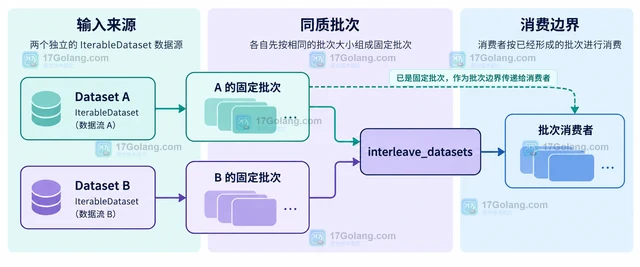
讲清 Hugging Face Datasets 流式 IterableDataset 如何用 batch_size 和 drop_last_batch 组成固定批次、处理尾批,并区分 map 与 DataLoader 的批次语义。
