-
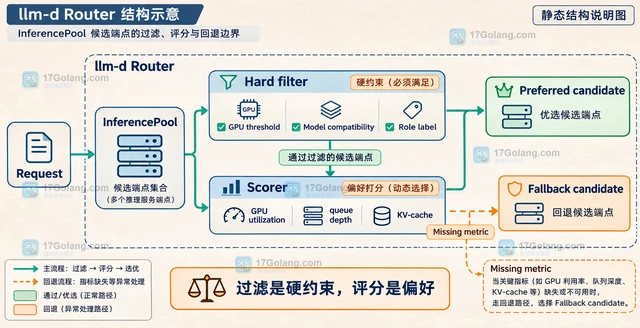
llm-d 并不是把请求直接绑定到某个 GPU 编号,而是由 Router 的 EPP 在 InferencePool 候选端点中综合静态能力、DCGM 利用率、队列、运行请求数和 KV-cache 等信号进行过滤、评分与选择。本文说明怎样拆分这些信号并设计可解释的回退边界。
-
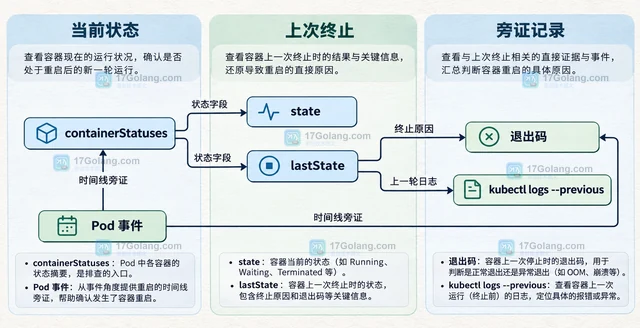
Kubernetes 里的 Pod 重启和容器重启不是同一件事。本文用 Pod UID、创建时间、restartCount、lastState、退出码、上一轮日志和事件建立一套只读排查顺序,帮助判断是同一 Pod 内的容器反复重启,还是控制器已经创建了新的 Pod。
-
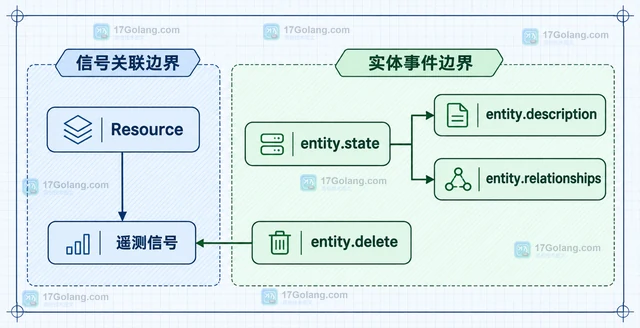
OpenTelemetry Entity Events 用 entity.state 携带完整实体状态和 entity.relationships,关系增删通过重新发送当前快照表达,entity.delete 与 report interval 共同处理生命周期。
-
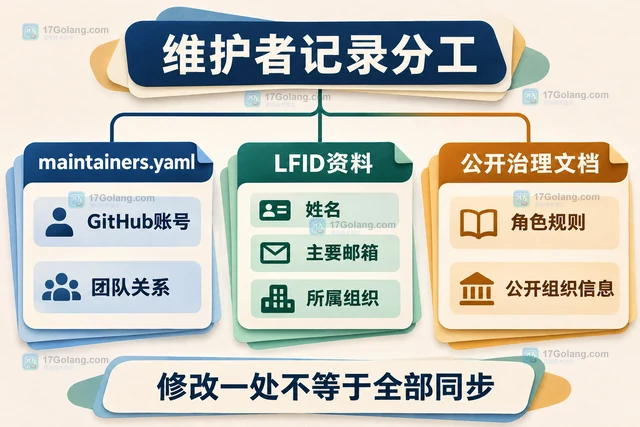
解读 CNCF .project 如何统一治理文档入口,区分 project.yaml、maintainers.yaml、LFID资料与规则正文,并说明变更审阅和下游更新的职责。
-
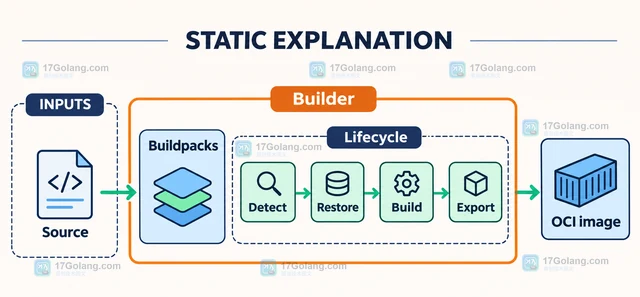
Cloud Native Buildpacks 通过 builder、buildpacks 和 lifecycle 把应用源码转换为 OCI 镜像。本文说明如何固定 builder、选择 pack build 导出目标、理解缓存与运行基镜像边界,并给出稳定交付检查清单。
-
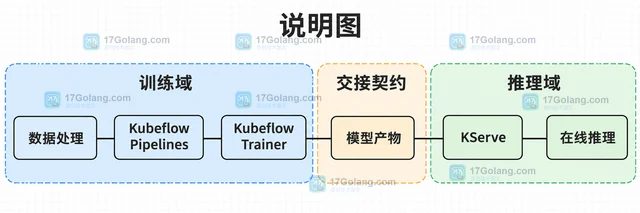
以 Kubeflow Pipelines、Trainer 和 KServe 为边界,说明如何把数据准备、模型训练、产物交接与在线推理拆成可维护的两条流水线。
-
用 MLflow GenAI 把真实 trace 中的已知失败行为固化为 pytest 回归测试,配置 @mlflow.test,组合 scorer,并用 result.passed 与 result.reason 接入 CI 断言。
-
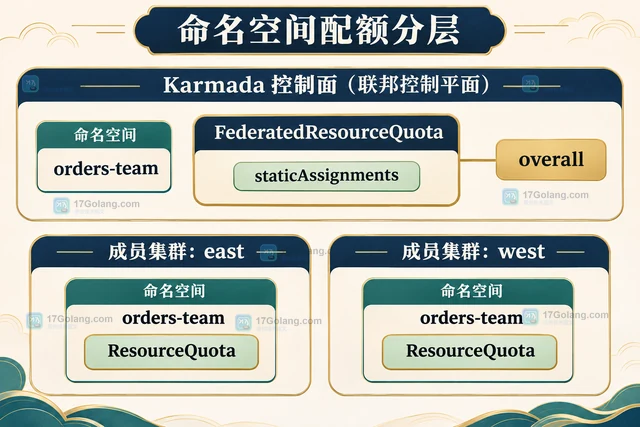
解读 Karmada 按命名空间管理跨集群资源配额的方法,区分 overall、staticAssignments、控制面执行与成员 ResourceQuota,并说明扩容和排查顺序。
-
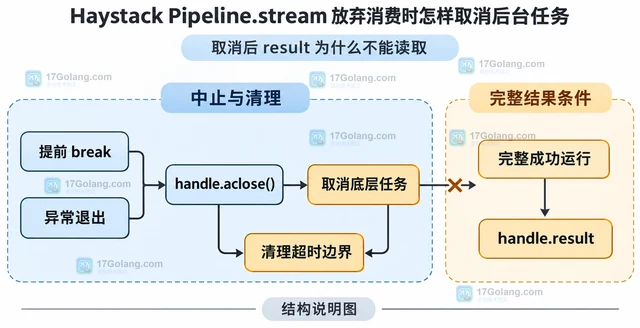
Haystack Pipeline.stream 返回可异步迭代的 PipelineStreamHandle。停止消费流式结果时,建议在 try/finally 中显式调用 await handle.aclose(),取消底层任务并完成有界清理;取消后的 handle.result 不可作为最终结果读取。
-
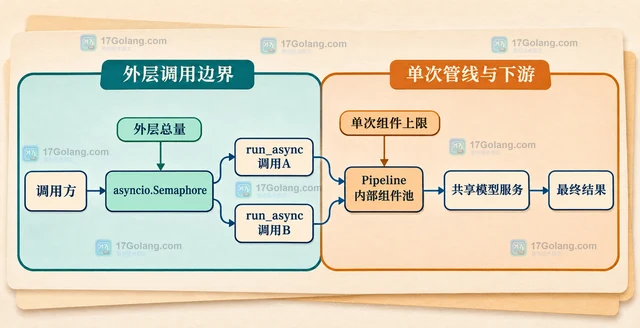
Haystack 的 Pipeline.run_async 可以用 concurrency_limit 限制一次异步管线中同时运行的组件数量。本文区分单次管线、多个调用和组件内部线程池三个边界,并给出 Python 调用示例。
-
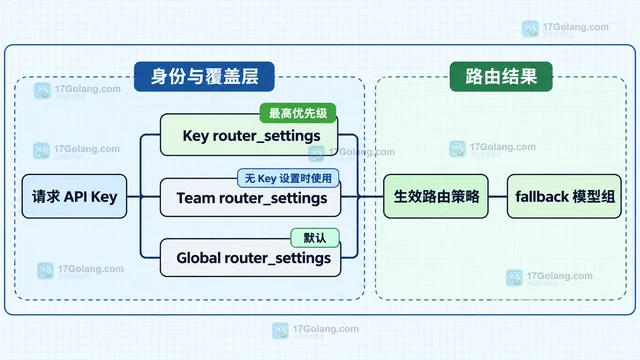
LiteLLM Proxy 支持按 Key、Team、Global 的层级解析 router_settings。本文用一个具体配置说明如何给不同 API Key 设置独立 fallback、timeout、num_retries 和故障冷却,并解释权限与配置覆盖关系。
-
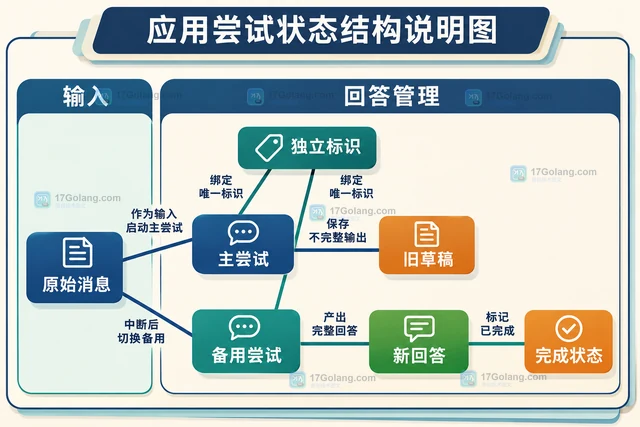
解释 LiteLLM Chat Completions 流已输出内容后的异常行为,给出应用层备用生成与 attempt 隔离写法,避免把重新生成误当成断点续传。
-
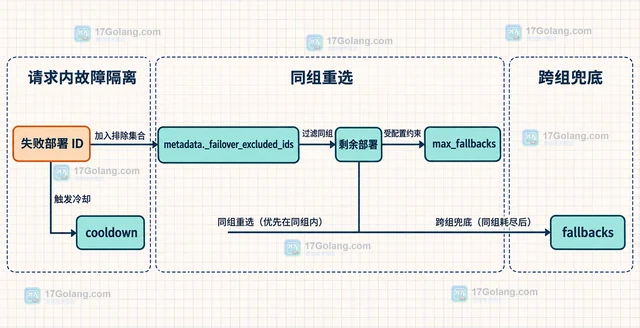
LiteLLM Router 可以把同一 model_name 下的多个区域部署组成模型组,并用 enable_weighted_failover 在异步请求失败时先切换同组健康副本。本文用权重、排除集合、max_fallbacks 和 cooldown 说明配置边界,以及它与跨模型 fallback 的区别。
-
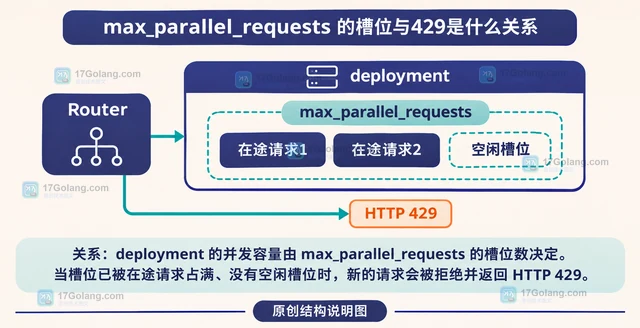
LiteLLM 的 max_parallel_requests 是部署级并发槽位上限,槽位全部占用时会在供应商调用前直接返回429。本文按配置优先级、进程边界和排查路径说明如何处理。
-
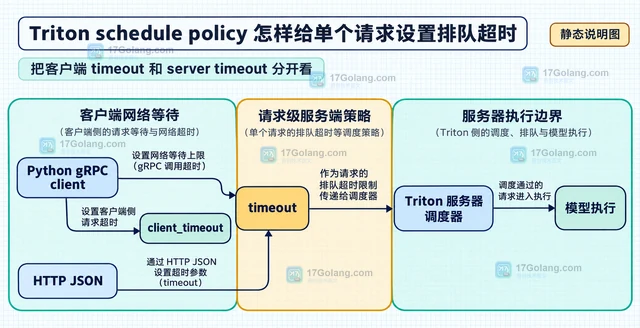
Triton 的 schedule policy 可以把 timeout 放进单个推理请求,让动态批处理队列按微秒值处理等待边界。本文说明模型队列策略、HTTP parameters.timeout、Python gRPC timeout 与 client_timeout 的区别。
