-
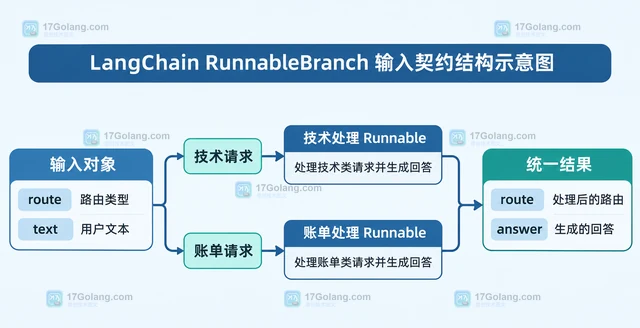
LangChain RunnableBranch 通过条件与 Runnable 对组成输入路由,按条件顺序选择第一个匹配分支,并用默认 Runnable 兜底。本文用统一输入输出契约演示如何构造、串接和控制它。
-
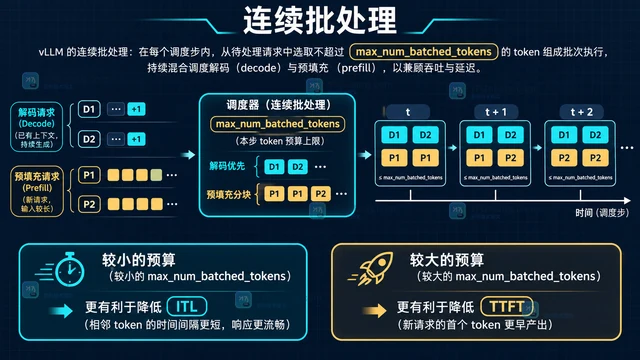
vLLM 的连续批处理 token 上限由 max_num_batched_tokens 控制。本文说明 Python 和 vllm serve 两种配置方式,并结合 ITL、TTFT、吞吐量、chunked prefill 与 KV Cache 给出调参边界。
-
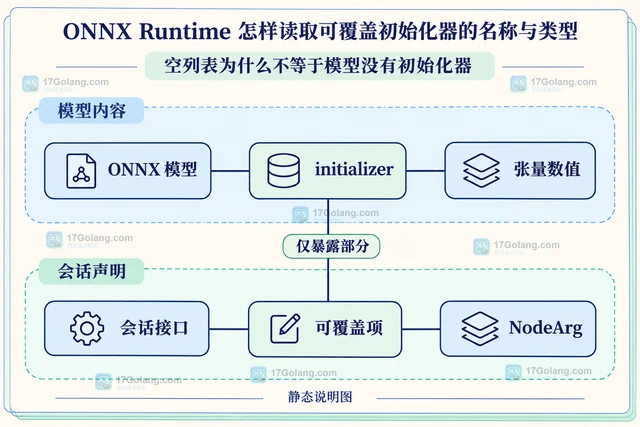
使用 ONNX Runtime get_overridable_initializers 读取可覆盖初始化器的名称、类型和形状,整理元数据报告,并区分空列表、加载异常、权重数值与性能结论。
-
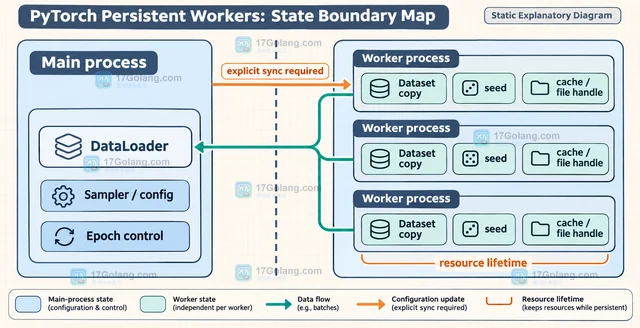
通过 persistent_workers=True 复用 PyTorch DataLoader 的多进程 worker,本文说明 DataLoader 的放置位置、Dataset 状态边界、参数取舍和关闭条件。
-
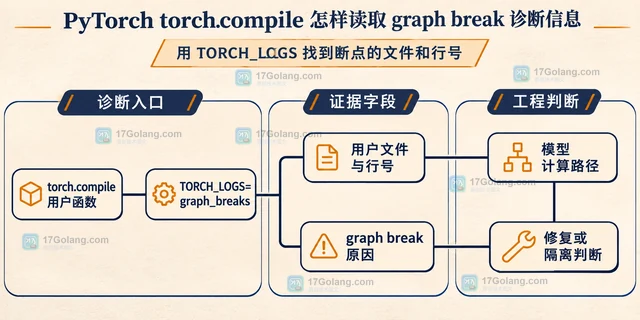
PyTorch torch.compile 遇到 graph break 时,先用 eager 基线确认问题,再通过 TORCH_LOGS=graph_breaks 和 torch._dynamo.explain 读取位置、原因与断点数量,最后根据代码错误、暂不支持行为或函数隔离选择修复方向。
-
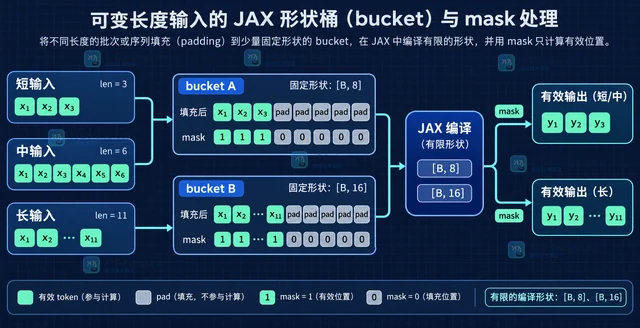
JAX jit 的缓存键包含输入的 shape 和 dtype,动态批次、可变序列长度或静态参数变化都可能触发重新编译。本文从日志定位入手,用 padding、分桶和稳定函数定义减少重复编译,并说明持久化编译缓存的适用边界。
-
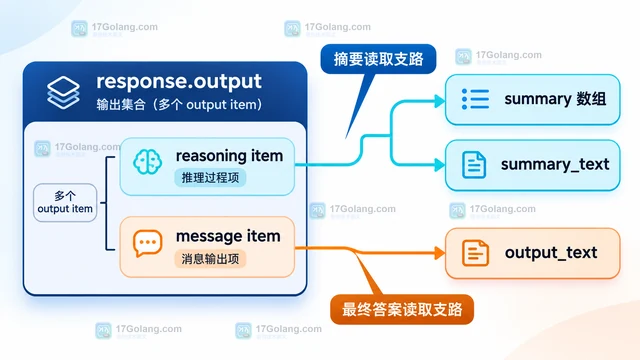
Responses API 不会默认返回 reasoning summary。本文用 reasoning.summary 开启摘要,遍历 reasoning output item 读取 summary_text,并说明 effort、output_text 与模型支持差异。
-
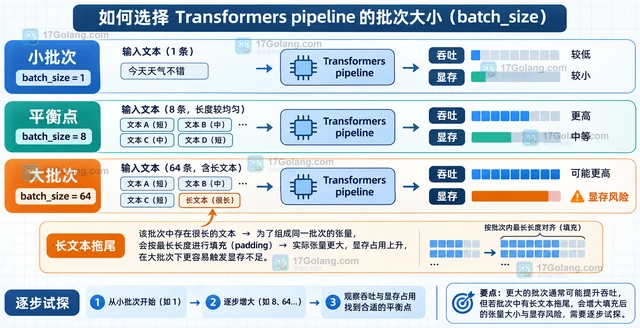
Transformers pipeline 支持列表、Dataset 和生成器输入。本文用文本分类场景说明如何设置 batch_size,解释 padding 与长文本造成的显存风险,并给出从小批次开始、同时记录吞吐和峰值显存的可回退配置方法。
-
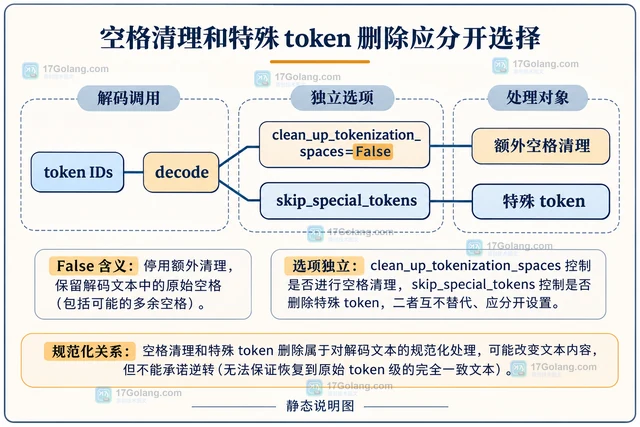
Transformers decode 可用 clean_up_tokenization_spaces=False 停用额外空格清理。结合示例区分特殊 token 删除、后端解码与原文保存,给出展示和诊断场景的参数选择。
-
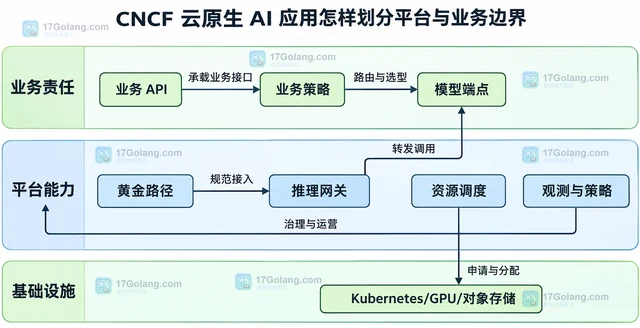
云原生 AI 应用不应把业务规则、模型运行和 GPU 集群揉成一个平台。本文用三层边界说明业务团队、AI 平台团队与基础设施团队各自负责什么,并给出模型生命周期、反例和落地判断清单。
-
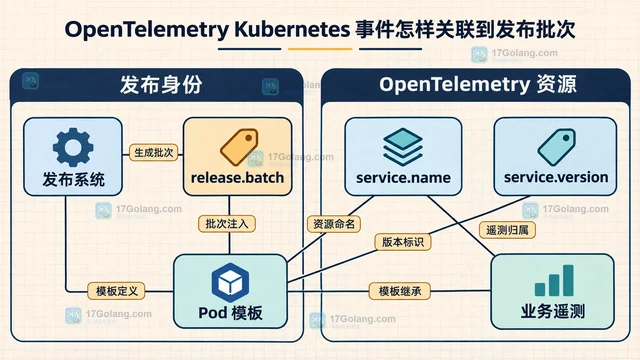
Kubernetes Event 本身不是稳定的发布审计日志。本文用发布批次标签、Pod 模板注解、k8sobjectsreceiver 和 k8sattributesprocessor,把事件与 OpenTelemetry 遥测按同一批次身份关联,并说明事件保留期、重复和语义变化的边界。
-
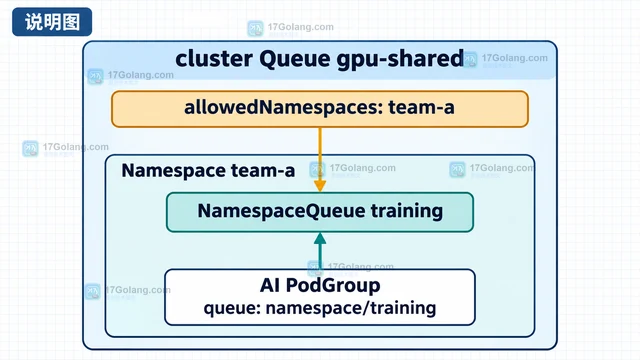
Volcano v1.16.0 将 NamespaceQueue 的命名空间队列授权与 fairshare 的共享队列历史公平拆开。本文用 AI/GPU 多租户场景说明功能边界、配置顺序、验证证据和不能抢占运行中作业的限制。
-
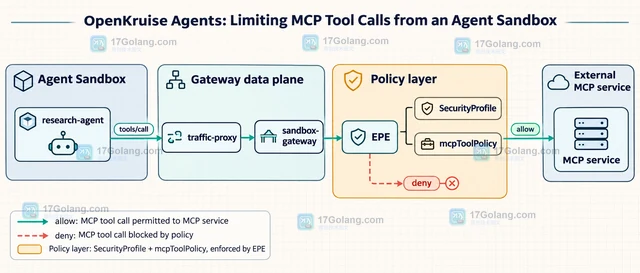
OpenKruise Agents 的 Agent Sandbox 不应把工具权限交给模型自行决定。本文按一次工具越权故障复盘,说明如何用 SecurityProfile 选择调用方,用 mcpToolPolicy 按工具名白名单放行,并梳理网关路径、规则顺序、审计和绕过边界。
-
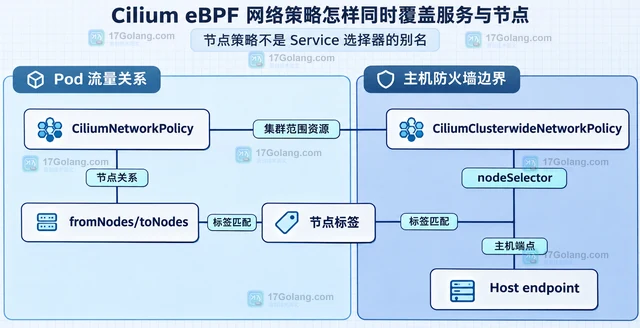
Cilium 网络策略要同时覆盖服务与节点,不能只把 Service 名称和节点标签塞进同一个选择器。本文按服务流量、Pod 到节点流量和主机网络策略拆开说明 toServices、fromNodes/toNodes 与 nodeSelector 的职责,并给出迁移清单。
-
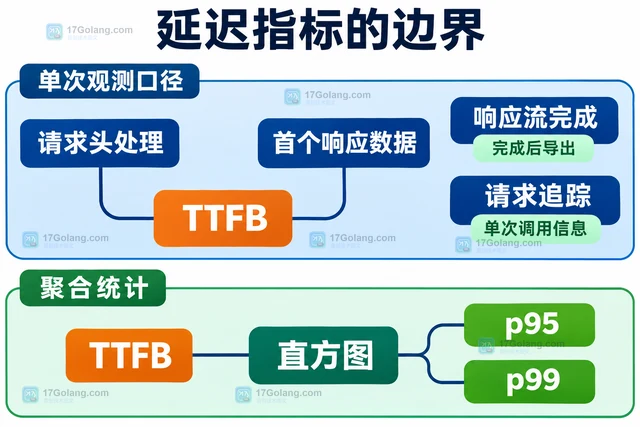
说明 Linkerd 请求延迟指标的读取方法,区分窗口分位数、TTFB与单请求追踪,并梳理指标为空、方向不同和用户耗时不一致时的排查顺序。
