-
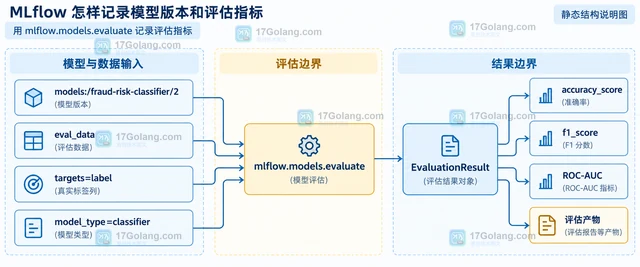
用一个完整的 MLflow Run 串起参数、手工指标、模型制品、注册模型版本和测试集评估结果:先固定实验与注册模型名,再用 registered_model_name 生成版本,最后通过 mlflow.models.evaluate 读取 accuracy、F1 等指标。
-
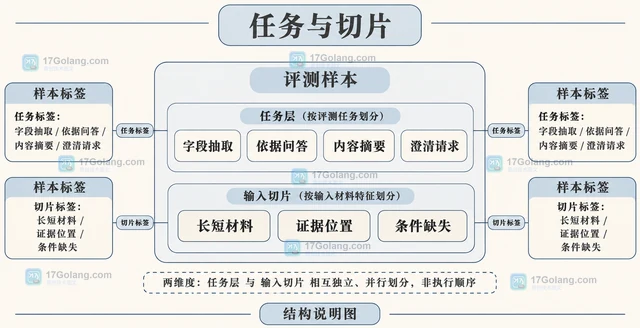
以客服助手为例,说明生成式模型评测集如何划分任务与切片、保存评分条件、配置常规集和挑战集,解释分层结果与加权汇总的区别,并维护固定测试集。
-
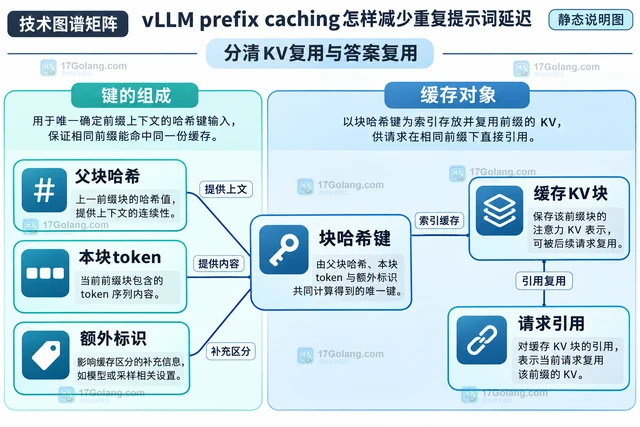
vLLM prefix caching怎样复用共同前缀KV缓存:显式启用APC、稳定提示词结构,用冷暖对照观察首字延迟,并区分预填充优化与答案缓存。
-
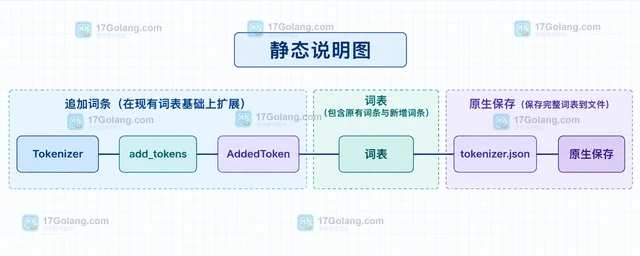
用 Hugging Face Tokenizers 添加领域词条后,如何保存并重新加载自定义词表?本文区分追加词条与重新训练词表,分别说明 save()、from_file() 与 save_pretrained() 的使用边界。
-
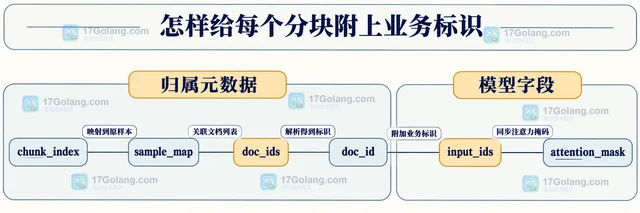
说明 Transformers BatchEncoding 的 overflow_to_sample_mapping 如何关联分块与原批样本,给出 truncation、stride 和业务文档 ID 的处理示例,并澄清分块编号与样本下标的区别。
-
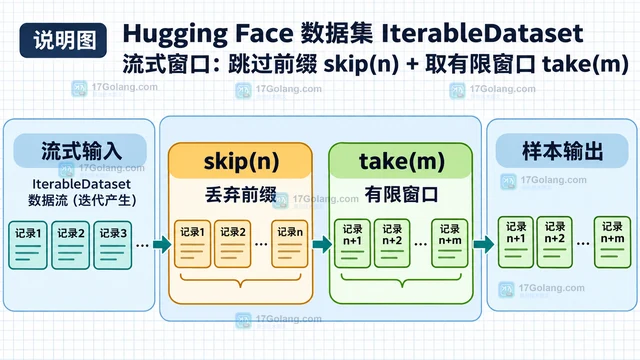
Hugging Face datasets 开启 streaming=True 后得到 IterableDataset,不适合用 dataset[1000] 做行随机索引。本文说明如何用 shuffle、skip、take 组合读取有限窗口,并解释跳过仍需顺序推进、何时应改用普通 Dataset。
-
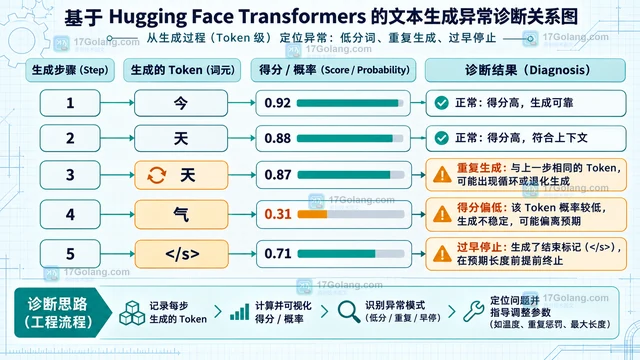
用 Transformers generate 返回逐步分数,按生成 token 对齐 scores,并区分低置信度、重复输出和提前停止。
-
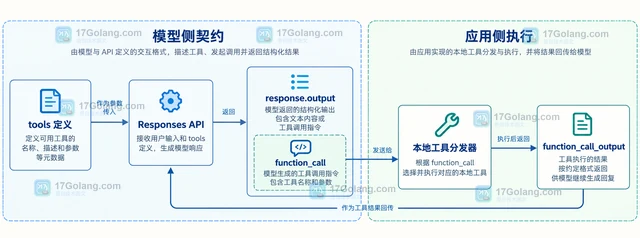
Responses API 不会替应用执行自定义函数。正确做法是读取 function_call,执行本地工具,再用同一个 call_id 回传 function_call_output,让模型继续处理下一次工具调用或生成最终答复。
-
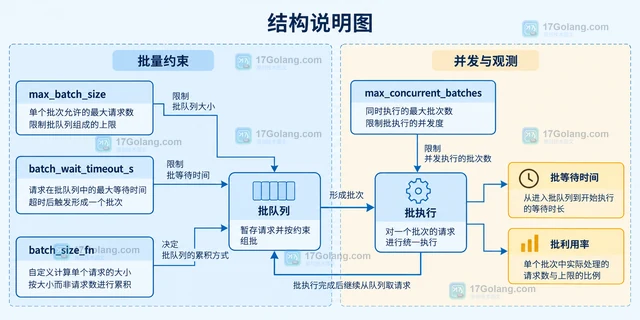
本文围绕 Ray Serve DeploymentHandle 的异步批处理,说明 DeploymentResponse 的提交与等待方式、@serve.batch 的参数边界、等长结果约束,以及如何用批等待和利用率指标判断参数是否合适。
-
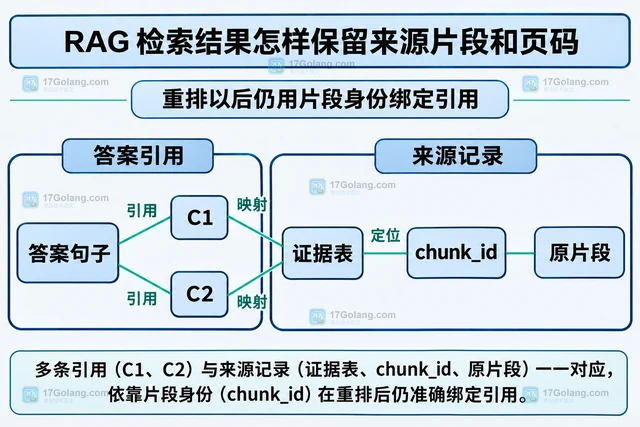
RAG应在解析和切分时保留文档版本、页位置及原文区间,并在检索重排后维持片段身份。本文给出来源字段设计、证据表绑定、旧索引迁移与页码缺失的处理方法。
-
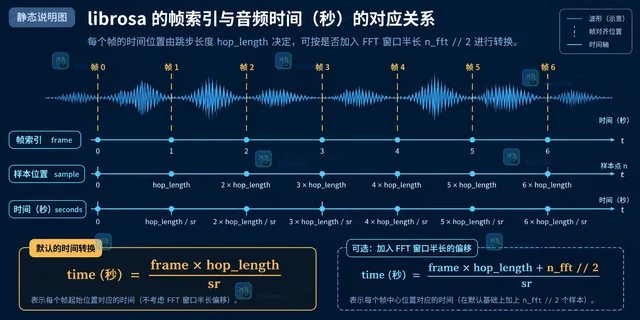
librosa 的 onset_detect 默认返回帧编号,可用 frames_to_time 按 sr 和 hop_length 换算成秒,也可以直接设置 units="time"。本文说明参数一致性、n_fft 偏移和回溯检测的时间边界。
-
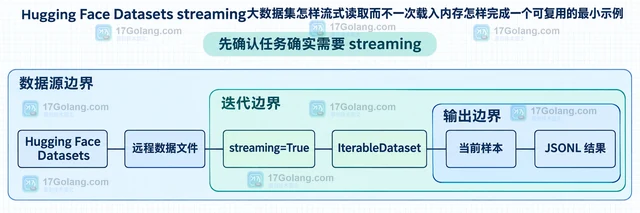
用 Hugging Face Datasets 的 streaming=True 创建 IterableDataset,按需读取大数据集并写入 JSONL,同时说明 take、shuffle、skip、shard 与随机访问的适用边界。
-
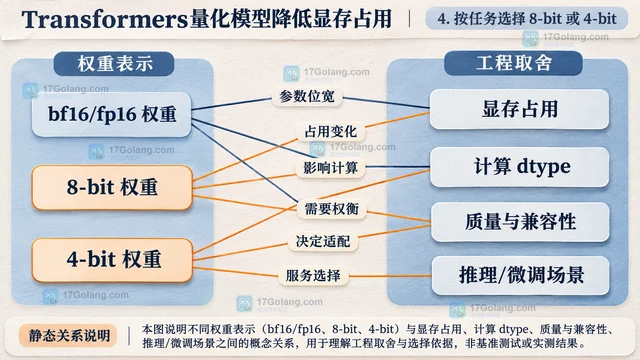
Transformers 可以在 from_pretrained 加载阶段通过 BitsAndBytesConfig 启用 8-bit 或 4-bit 量化,显著降低模型权重占用。本文从估算、依赖、加载代码、8-bit 与 4-bit 取舍以及内存统计五个环节说明怎样把量化配置落到实际推理环境。
-
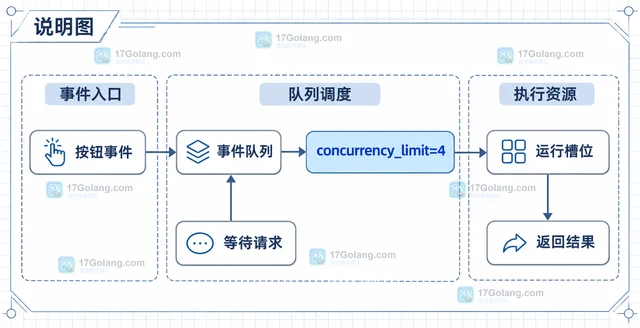
Gradio 默认会为事件监听器建立队列,concurrency_limit 决定同一事件同时运行的请求数。本文说明单事件限流、用 concurrency_id 共享 GPU 队列,以及 None、default 和 Blocks.queue 默认值的边界。
-
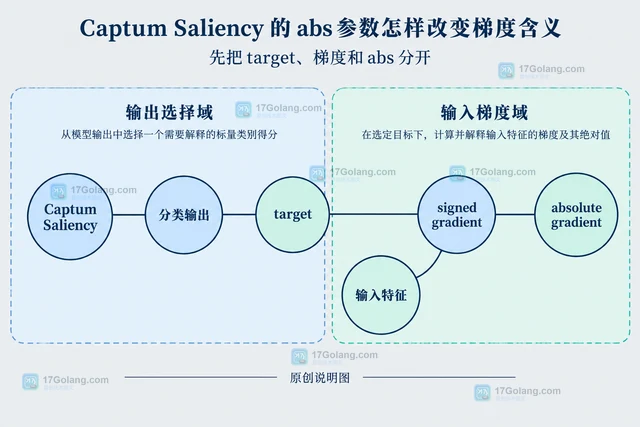
Captum Saliency 的 abs 默认会把输入梯度取绝对值。本文用固定线性分类器对比 abs=True 与 abs=False,说明方向、幅度、target 和输入形状各自代表什么,以及如何避免把梯度误当成概率或因果结论。
