-
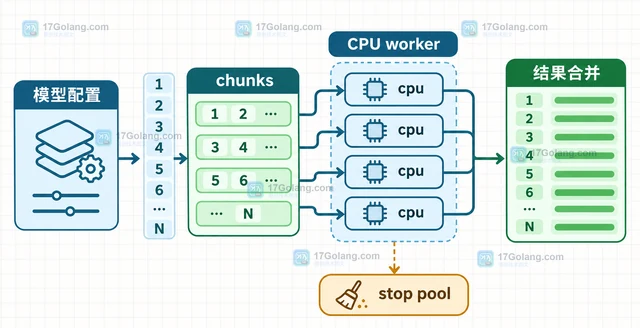
Sentence Transformers 多进程编码时,可以通过 device 列表把 CPU 或 GPU 显式映射到独立 worker,并用 chunk_size 控制任务切分。本文说明一卡一进程、CPU worker 数量、显式 pool 复用与 stop_multi_process_pool 释放的边界。
-
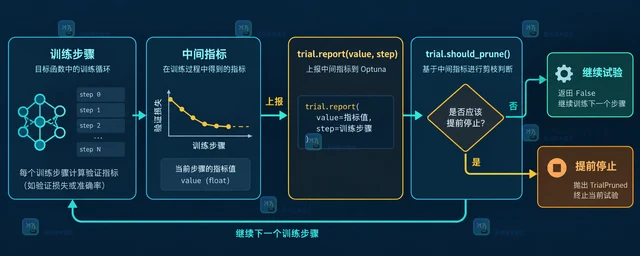
Optuna 的 MedianPruner 不会自动猜测训练进度,关键是让 objective 在每个可比较的步骤调用 report,再用 should_prune 响应剪枝判断。本文用一个单目标验证损失示例说明启动试验数、预热步骤、检查间隔和最小样本数如何配合。
-
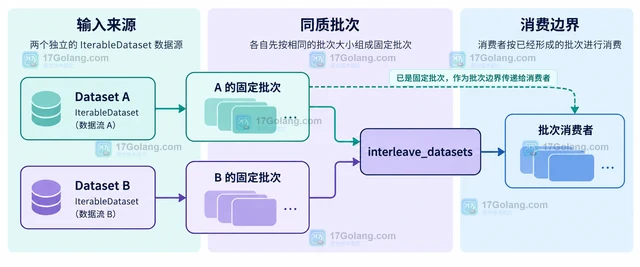
讲清 Hugging Face Datasets 流式 IterableDataset 如何用 batch_size 和 drop_last_batch 组成固定批次、处理尾批,并区分 map 与 DataLoader 的批次语义。
-
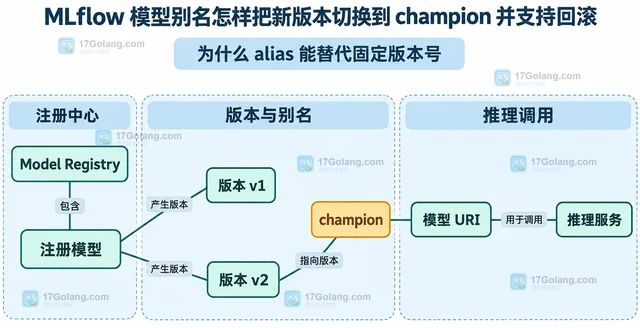
用 MLflow Model Registry 的 champion alias 解耦推理代码与模型版本:切换时指向新版本,出现问题时用同一接口回指旧版本。
-
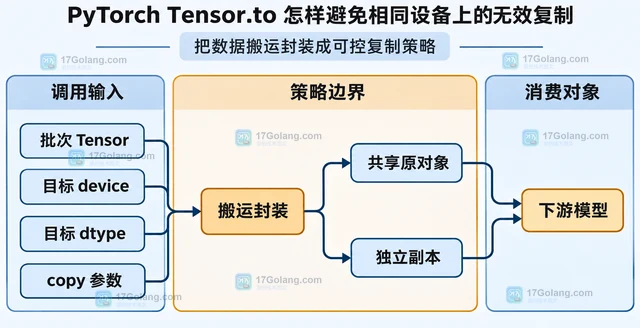
解释 PyTorch Tensor.to 在相同 dtype 和 device 下的返回语义,区分默认 no-op 与 copy=True 强制复制,并给出可复用的数据搬运封装。
-
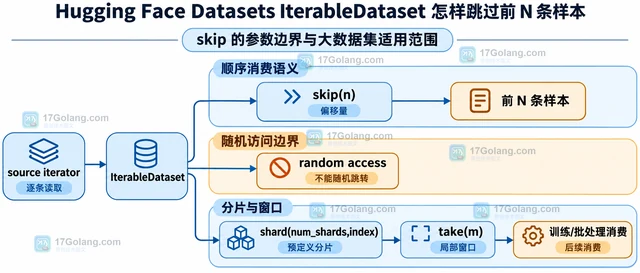
说明 Hugging Face Datasets 流式 IterableDataset 怎样用 skip(n) 跳过前 N 条样本,再用 take(m) 限制读取窗口;同时解释 shuffle 顺序、顺序消费成本、随机访问边界和 shard 分片选择。
-
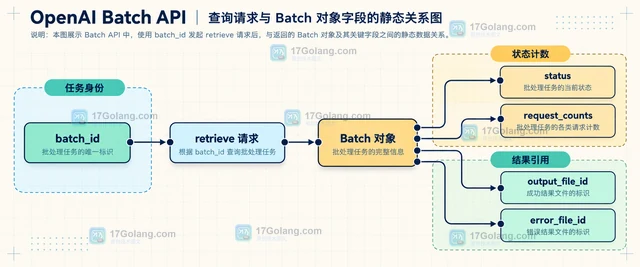
OpenAI Batch API 查询状态的关键是使用 batch_id 调用 retrieve 接口,再结合 status、request_counts 和结果文件字段判断下一步。本文给出 curl、Python 示例,并说明各个中间态、终态和失败边界。
-
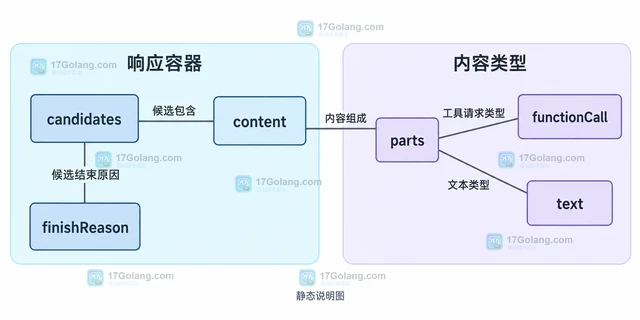
以 generateContent 非流式 REST 响应为范围,区分 functionCall、text 和 finishReason,给出只分类不执行的 Python 示例,并解释工具结果回传、原始内容保留和最终回答边界。
-
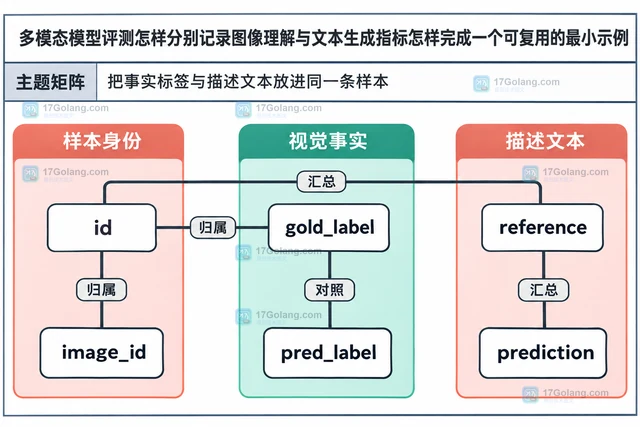
通过一份标准库离线评分示例,把视觉事实正确率与文本字符 F1 分开记录,保留逐条样本和版本信息,解释文本相似掩盖视觉错误的原因与真实评测的适用边界。
-
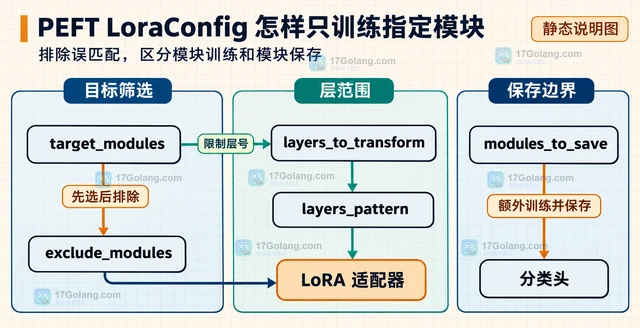
PEFT 的 LoraConfig 怎样只训练指定模块?本文围绕 target_modules 的列表后缀与字符串正则匹配,说明 exclude_modules、modules_to_save、all-linear 的边界,并给出按真实模块名收窄 LoRA 训练范围的 Python 示例。
-
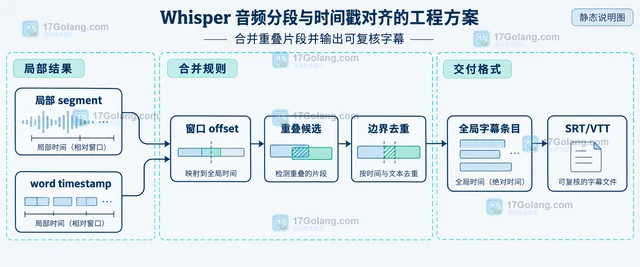
围绕 Whisper 的 30 秒上下文、重叠窗口和 segment/word 时间戳,给出长音频分段、全局时间映射、重叠去重与字幕复核的一套工程方案。
-
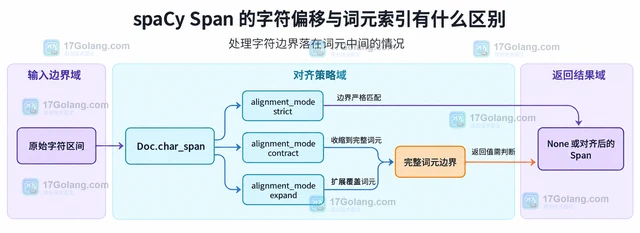
用最小例子区分 spaCy Span 的词元索引与字符偏移,说明 start/end、start_char/end_char 和 char_span 对齐模式在字符串切片与实体标注中的不同用途。
-
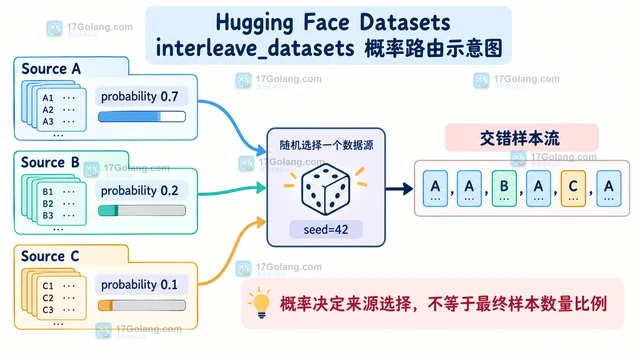
Hugging Face Datasets 的 interleave_datasets 可以按 probabilities 随机选择多个语料源,再用 seed 复现选择序列。本文用最小示例说明三种停止策略的差异,以及 streaming 场景的取舍。
-
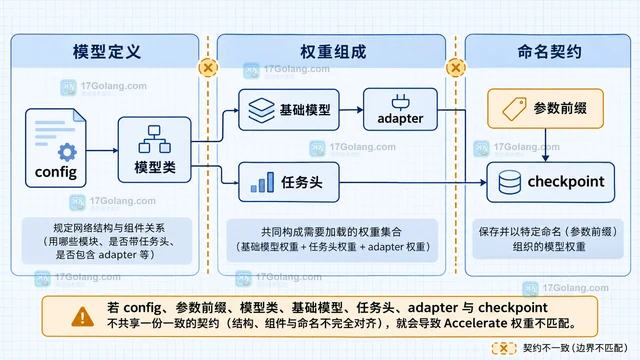
Accelerate 的 load_checkpoint_and_dispatch 遇到 missing 或 unexpected keys 时,先比较 checkpoint 与空模型的 state_dict 键集合,再排查配置、前缀、模型头和 adapter 边界,最后用 strict=True 收窄错误。
-
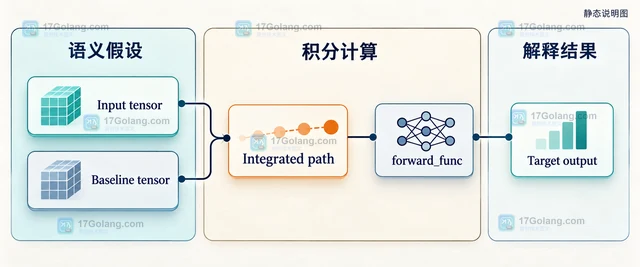
Captum IntegratedGradients 的 baseline 决定解释从哪里出发。本文按图像、表格、多输入和文本场景说明基线选择、参数对齐与 convergence delta 复盘方法。
