-
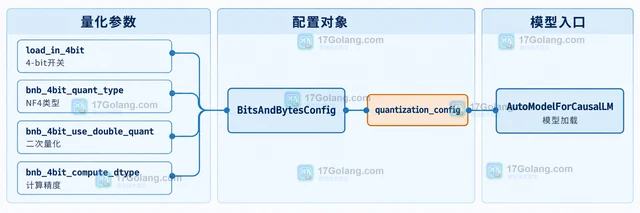
QLoRA 配置中,NF4 决定 4-bit 权重的数据类型,double quant 对量化常量再次量化,compute dtype 决定计算时使用的精度。本文用 BitsAndBytesConfig 给出一份适合 4-bit 训练的配置,并说明显存、训练和推理场景下的取舍。
-
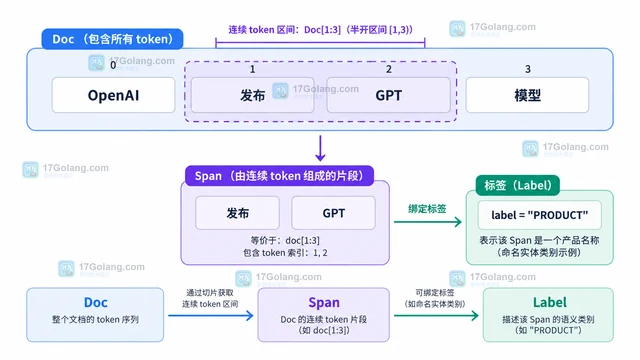
本文用 spaCy 的半开区间说明怎样从 Doc 中选择连续词元,构造带 label 的 Span,并把边界检查与 doc.spans、doc.ents 的承载选择放进一条稳定的处理链。
-
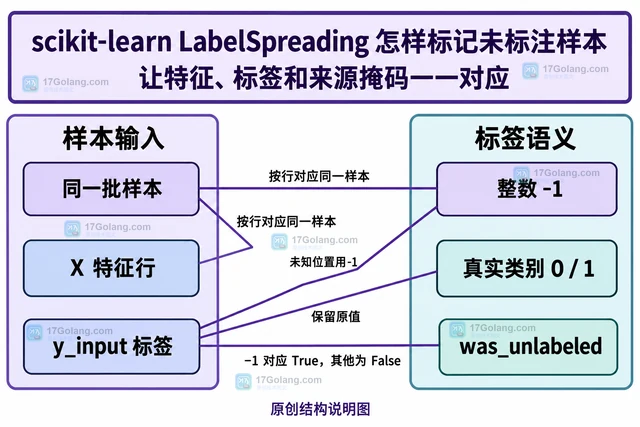
说明scikit-learn LabelSpreading用整数-1标记未标注样本,提供保留原标签与来源掩码的示例,并区分transduction_、类别分布和应用合并视图的含义。
-
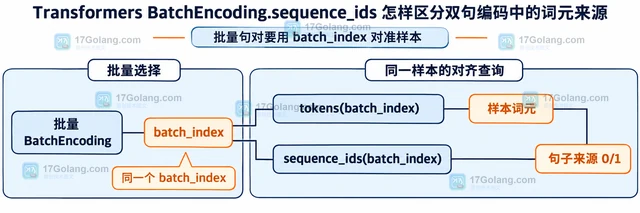
Transformers 的 BatchEncoding.sequence_ids 可以把双句编码中的词元映射回来源序列:特殊词元为 None,第一句为 0,第二句为 1。本文说明 Fast tokenizer、批量下标、padding 以及它和 token_type_ids 的边界。
-
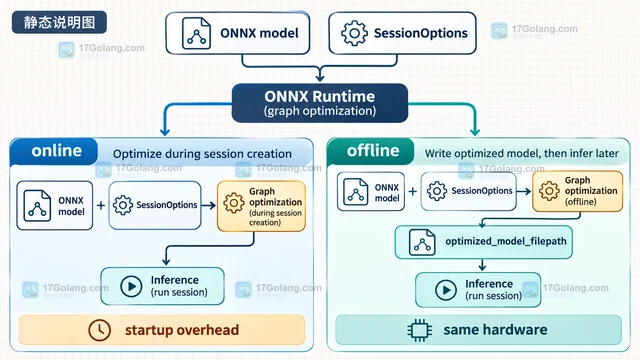
ONNX Runtime 可以在创建推理会话时对模型图做节点消除、常量折叠和算子融合。本文用 Python 说明如何显式设置 ORT_ENABLE_BASIC、ORT_ENABLE_EXTENDED 和 ORT_ENABLE_ALL,并比较在线优化与离线保存优化模型的适用边界。
-
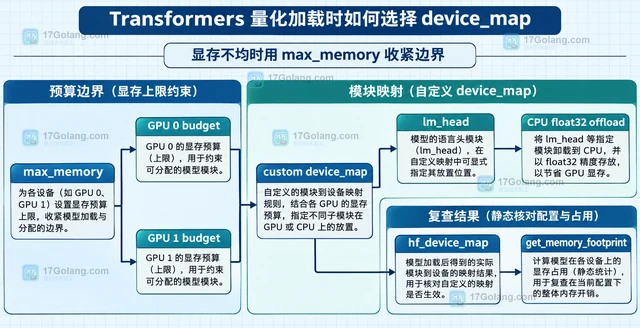
用 Transformers 和 bitsandbytes 加载量化模型时,device_map 应按推理方式、显存预算和是否需要 CPU offload 来选择。本文区分 auto、明确设备、自定义字典与 max_memory,并说明如何读取分配结果。
-
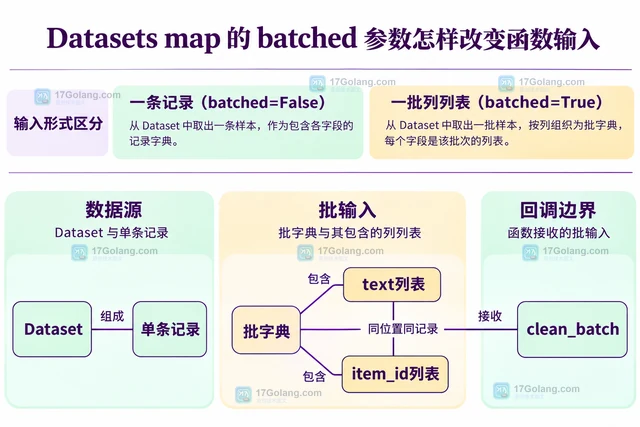
Datasets map 设置 batched=True 后,回调默认接收列列表组成的批字典。本文通过本地小数据集说明逐条与批量写法、输出列行数对齐、remove_columns 和尾批处理。
-
用 finish_reason、status 和 incomplete_details.reason 区分模型自然结束、达到输出上限、工具调用、内容过滤与流式未结束状态,避免把半截答案当成完整结果。
-
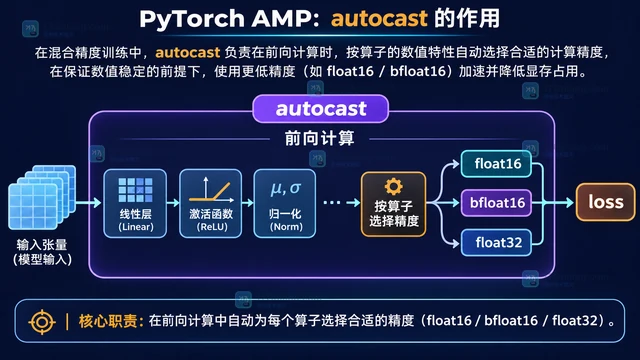
PyTorch AMP 里,autocast 负责前向算子选择合适的计算精度,GradScaler 负责放大 loss、还原梯度并在出现 inf 或 NaN 时保护优化器更新。本文按训练循环拆开两者职责,并说明梯度裁剪、float16、bfloat16、梯度累积和多优化器的放置边界。
-
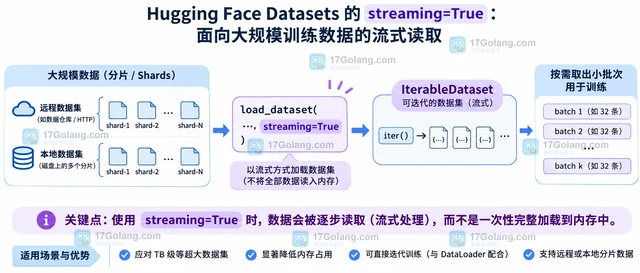
数据集无法完整下载时,可以用 Hugging Face Datasets 的 streaming=True 逐条读取,得到 IterableDataset 后再进行有限缓冲区打乱、map 预处理和按步数训练。本文给出最小写法,并说明随机访问、take/skip 和 Transformers 训练边界。
-
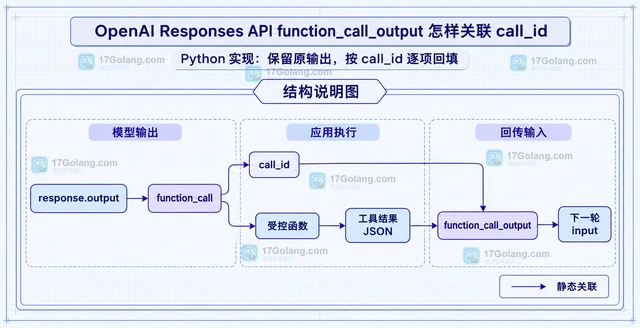
Responses API 工具调用中,function_call_output 必须使用对应 function_call 的 call_id 回传结果;本文区分 response.id 与 call_id,说明多工具调用、推理上下文和 Python 实现中的关联边界。
-
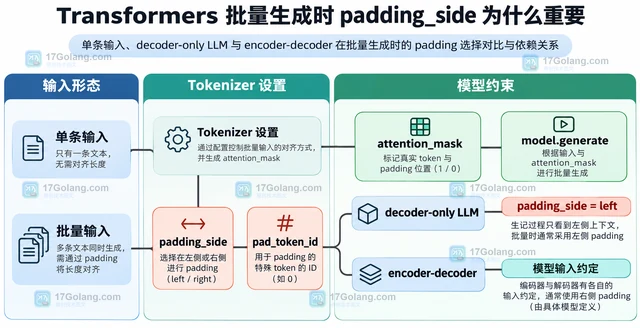
批量生成时 padding_side 会影响 decoder-only 模型读取的最后有效位置。本文比较 left、right、pad_token 与 attention_mask 的关系,并给出 Transformers 的批量配置示例。
-
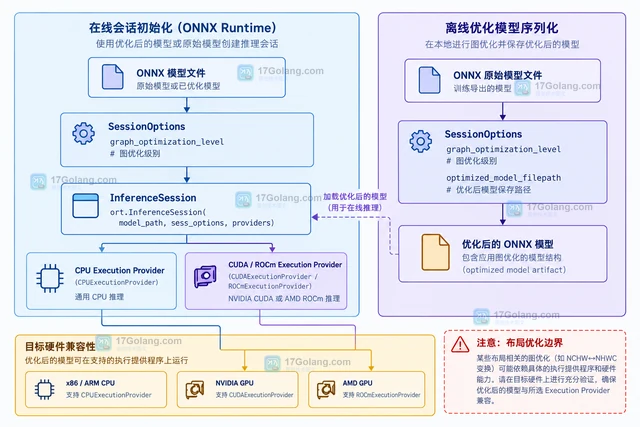
ONNX Runtime 的图优化等级绑定在 SessionOptions 上,EXTENDED 会包含 basic,ALL 还包括 layout。本文给出指定 InferenceSession 的 Python 配置、在线与离线优化的边界,以及按 Execution Provider 和目标硬件做基准、回退的实用方法。
-
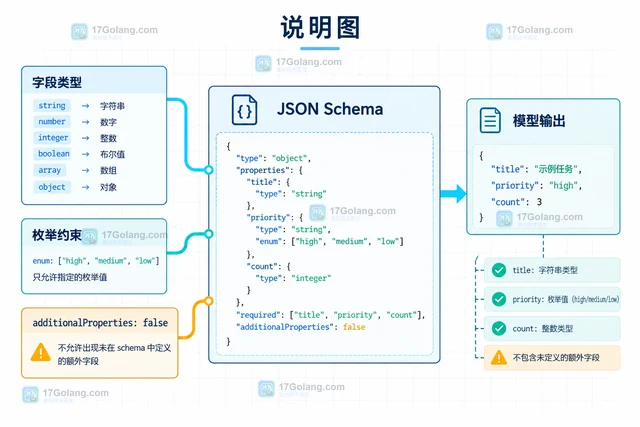
OpenAI API 需要固定输出格式时,应优先使用 Structured Outputs,在 Responses API 的 text.format 中声明 JSON Schema,并处理拒答、截断和旧版参数迁移边界。
-
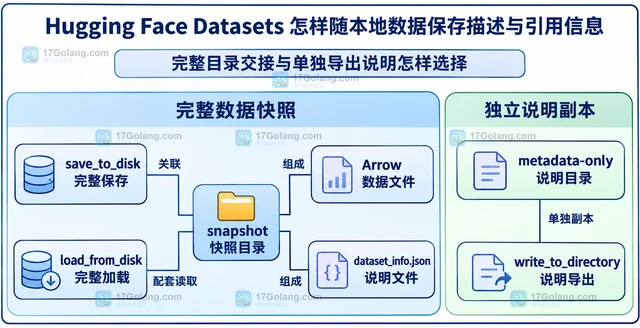
Hugging Face Datasets 可通过 DatasetInfo 绑定描述与引用,再用 save_to_disk 随本地快照保存。本文给出人工演示数据的完整写法,区分配套加载、单独导出说明及交付目录的使用边界。
