
人工智能技术文章
-
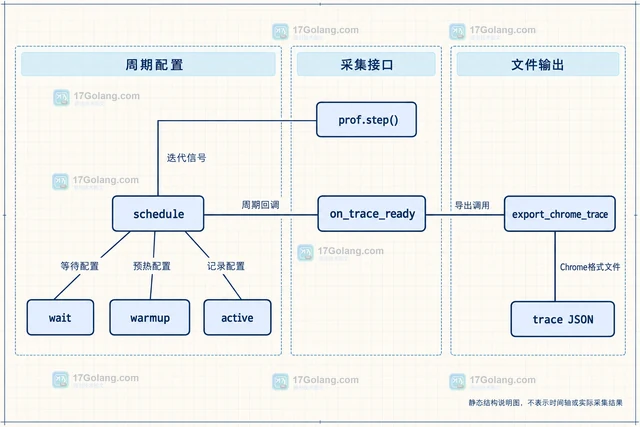 用一个最小 PyTorch 分析项目说明 torch.profiler 的采集范围、schedule 与 export_chrome_trace 的配合方式,导出可分享的 Chrome trace 文件,并区分静态示例、采集时机和结果解释边界。418 收藏
-
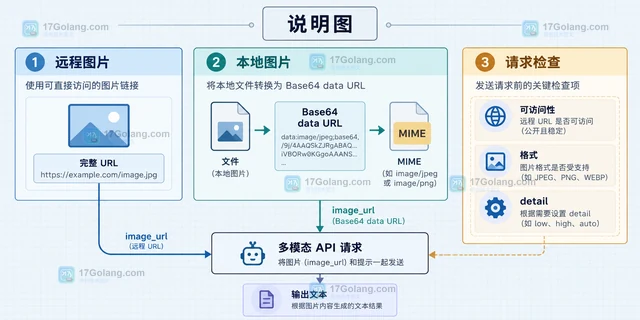 用 OpenAI Responses API 同时提交图片和文本问题,掌握 input_text、input_image、URL、Base64 data URL 与 detail 参数的写法、检查方法和边界。417 收藏
-
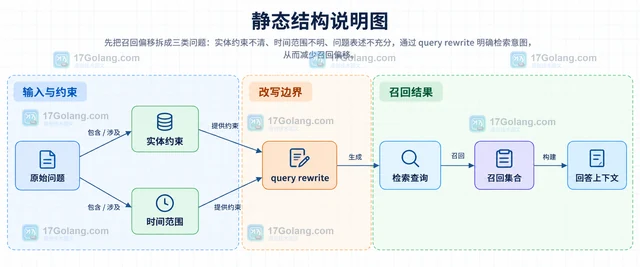 RAG 的 query rewrite 不是把问题改得更长,而是把实体、时间、范围等检索约束整理成稳定查询。本文用一个最小 Python 示例说明改写契约、召回接入和失败回退边界。416 收藏
-
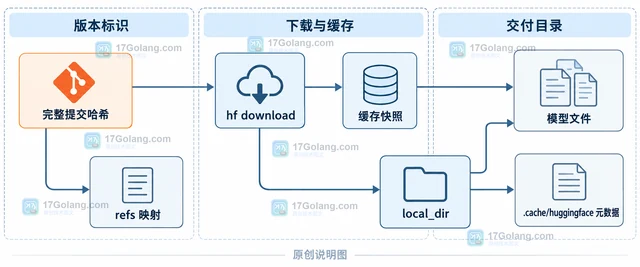 用 Hugging Face Hub 的 revision 参数固定分支、标签或完整提交哈希,分别演示 hf_hub_download、snapshot_download 和 hf download 的单文件、整仓库与 local_dir 交付边界。415 收藏
-
 用 tokenizers.normalizers.Sequence 按顺序组合 NFD、Lowercase、StripAccents 等正规化器,说明如何挂到 Tokenizer、观察结果并保留对齐信息。415 收藏
-
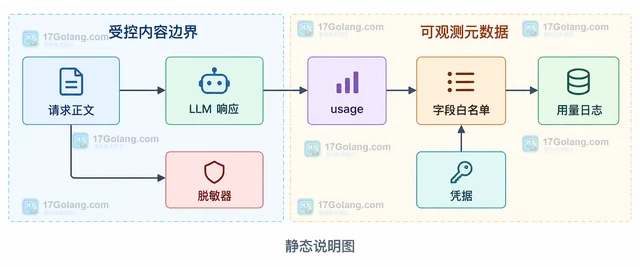 LLM 可观测性不等于把 prompt 和回答原文写进日志。本文以 OpenAI 兼容的 Chat Completion 响应为例,说明怎样记录 prompt_tokens、completion_tokens、total_tokens 等用量元数据,并在应用边界完成字段白名单、敏感信息脱敏和流式 usage 处理。413 收藏
-
 JiWER 计算语音识别误差时,参考文本与识别文本必须经过相同的正规化规则。本文用 Compose 组合清理与替换步骤,并将同一个变换对象同时传给两侧,说明 WER、CER 和自定义词替换的写法。413 收藏
-
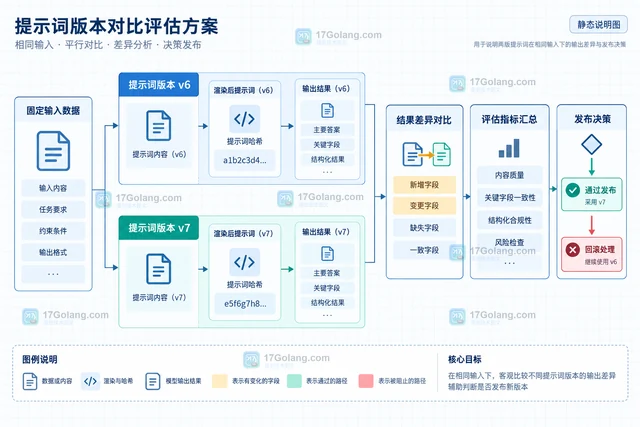 Prompt 变化不能只靠复制文本和人工回忆。本文用模板、变量、模型配置、输入集和输出指标五类记录,搭建可重放、可比较、可回滚的版本流程。412 收藏
-
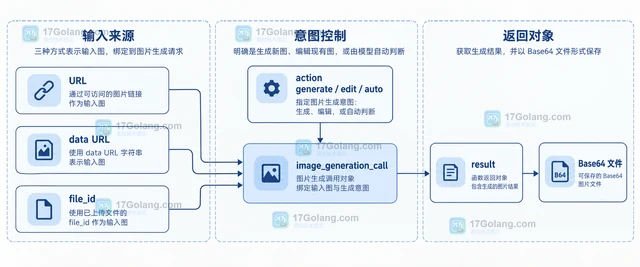 讲清 Responses API 如何用 input_image 绑定参考图,以及 URL、Base64 data URL、file_id 和 action=edit 的选择边界。412 收藏
-
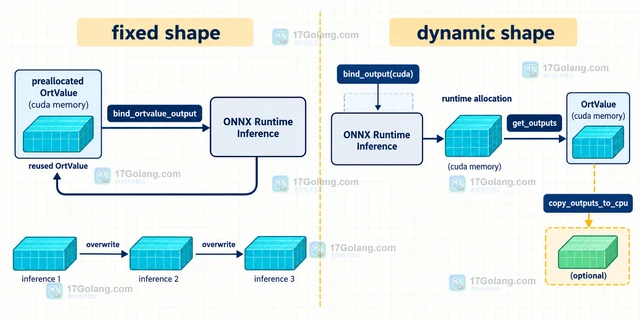 ONNX Runtime IOBinding 适合把固定形状的输入输出绑定到 CUDA 等目标设备,通过复用 OrtValue 减少 CPU-GPU 数据搬运和重复分配。本文给出 Python 绑定写法,并说明动态 shape 与 CPU 读回的边界。412 收藏
-
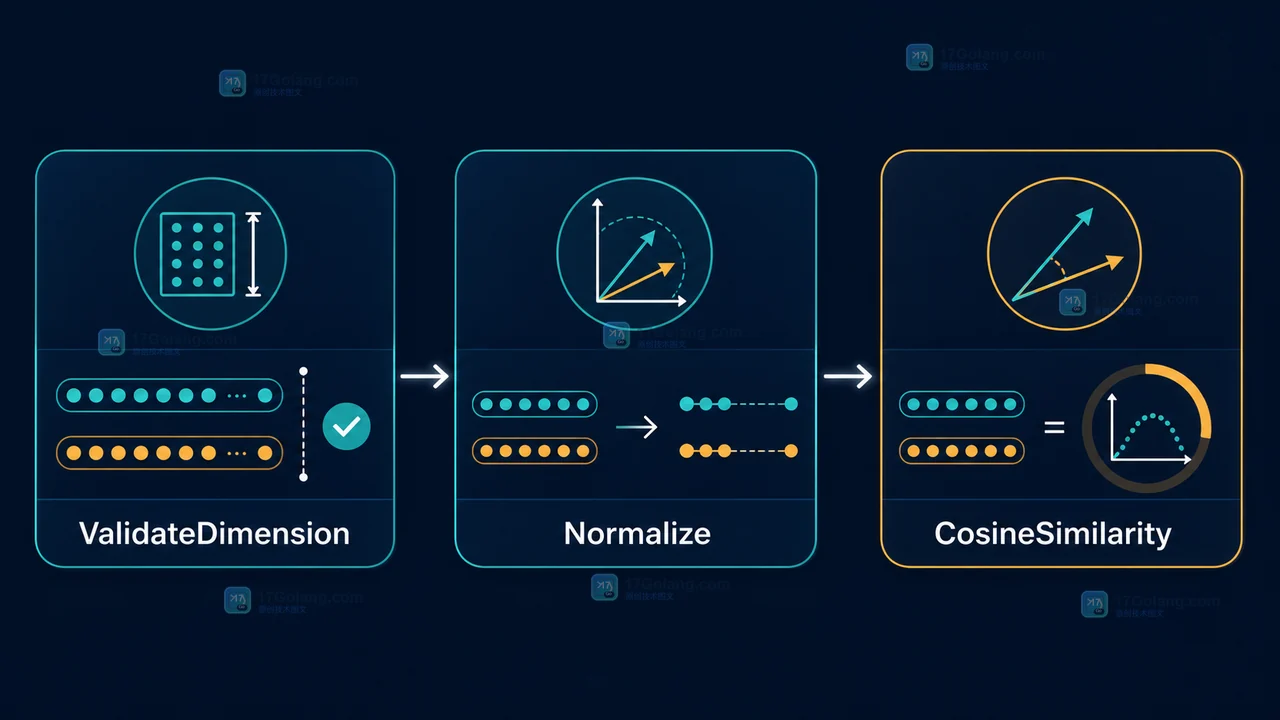 向量库里明明有数据,检索却返回空结果,常见根因不是数据库坏了,而是 embedding 维度、归一化方式和查询链路没有对齐。本文用一个最小 Go 实验把排查顺序固定下来。410 收藏
-
 向量检索通常应先执行租户、权限、状态和时间等硬过滤,再做向量或混合召回与 rerank,最后应用阈值、去重和多样性检查,本文给出可落地的判断顺序。409 收藏
-
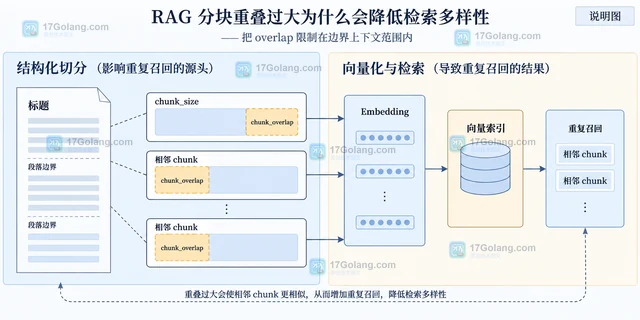 RAG 的 chunk_overlap 过大,会让相邻分块产生高度相似的向量,top-k 被同一来源的重复内容占满。本文从切分边界、候选池、去重和 MMR 重排四个方面给出可回归的调整方法。409 收藏
-
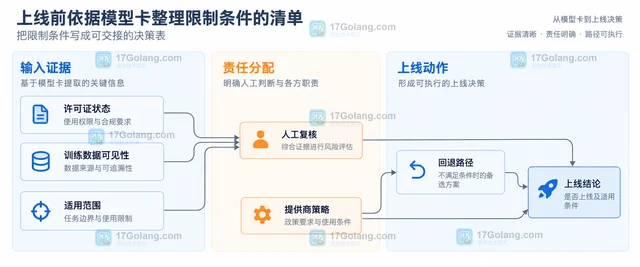 上线 AI 模型前不要只看评测分数。本文围绕模型卡中的许可证、训练数据说明和适用范围,整理一份可交接的限制条件清单,并说明如何把缺失信息、人工兜底和提供商选择写进发布决策。408 收藏
-
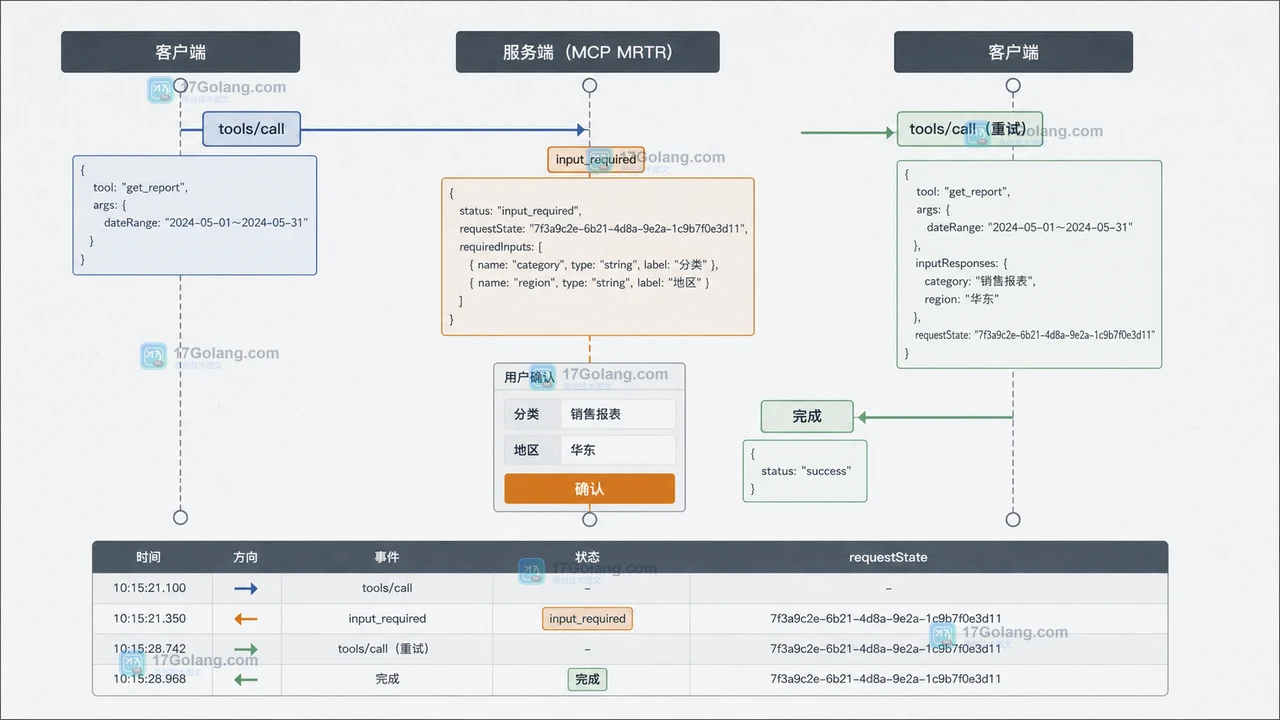 MCP 2026-07-28 将协议核心改成无会话请求,并用 MRTR 承接工具调用中的用户补充输入。本文从旧版会话依赖、请求路由、input_required 重试和灰度验收四个方面拆解迁移边界。407 收藏