
人工智能技术文章
-
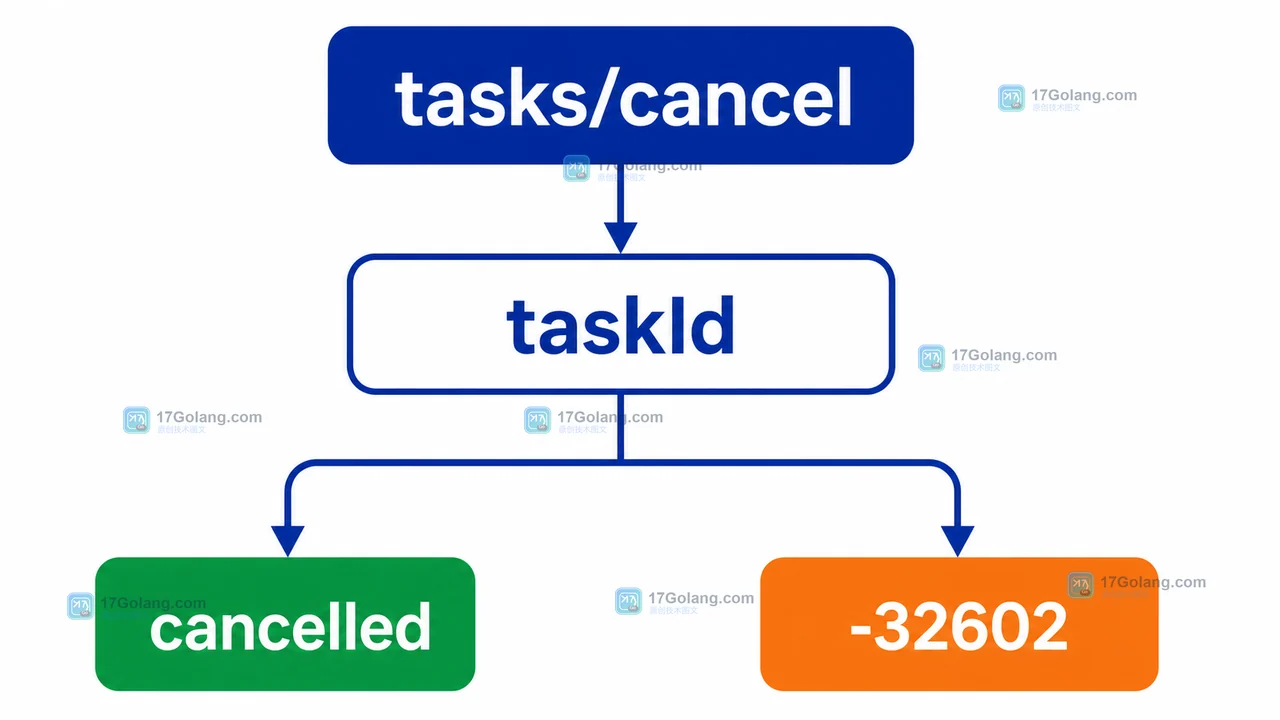 MCP Tasks 把耗时工具调用变成可查询的任务,但取消不是简单发一个通知。本文按能力协商、任务状态、tasks/cancel 请求和客户端收口拆开可取消流程,说明如何处理竞态与终态边界。426 收藏
-
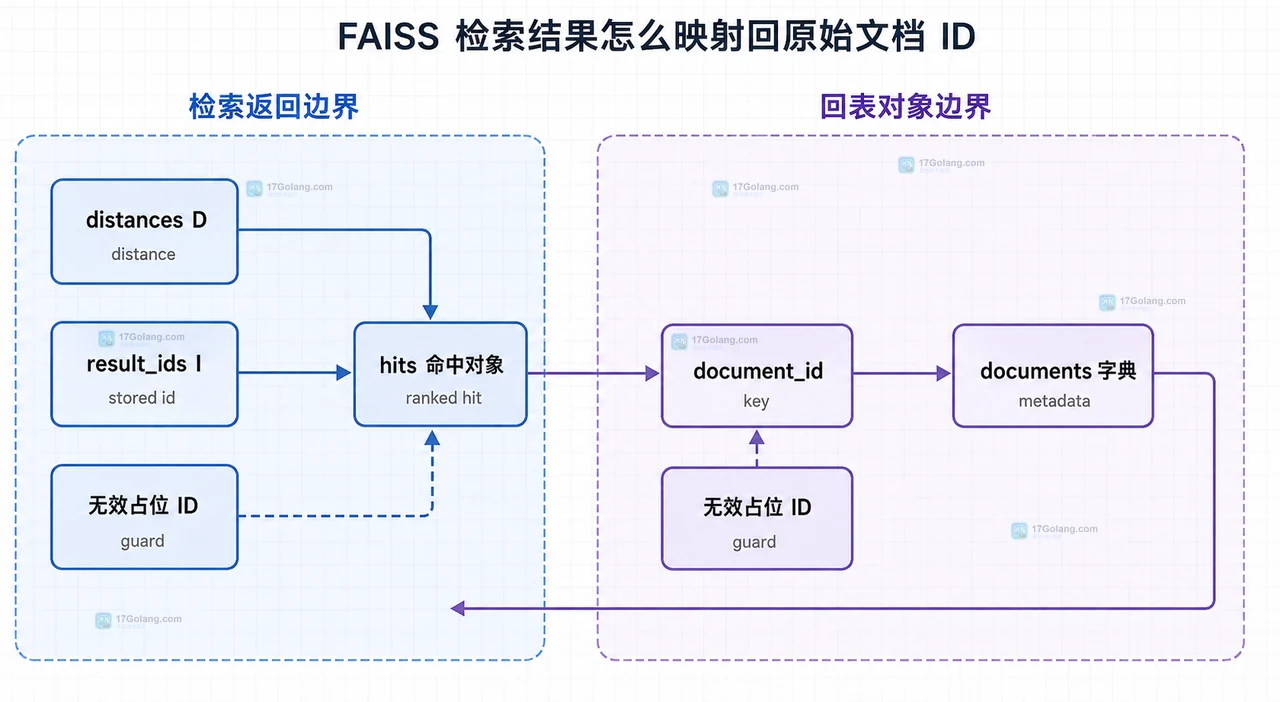 用 FAISS 做向量检索时,不要把返回位置当成文档主键。本文用 IndexIDMap 绑定 int64 业务 ID,演示 search 结果如何安全回表,并说明 IndexIVF 的选型边界。426 收藏
-
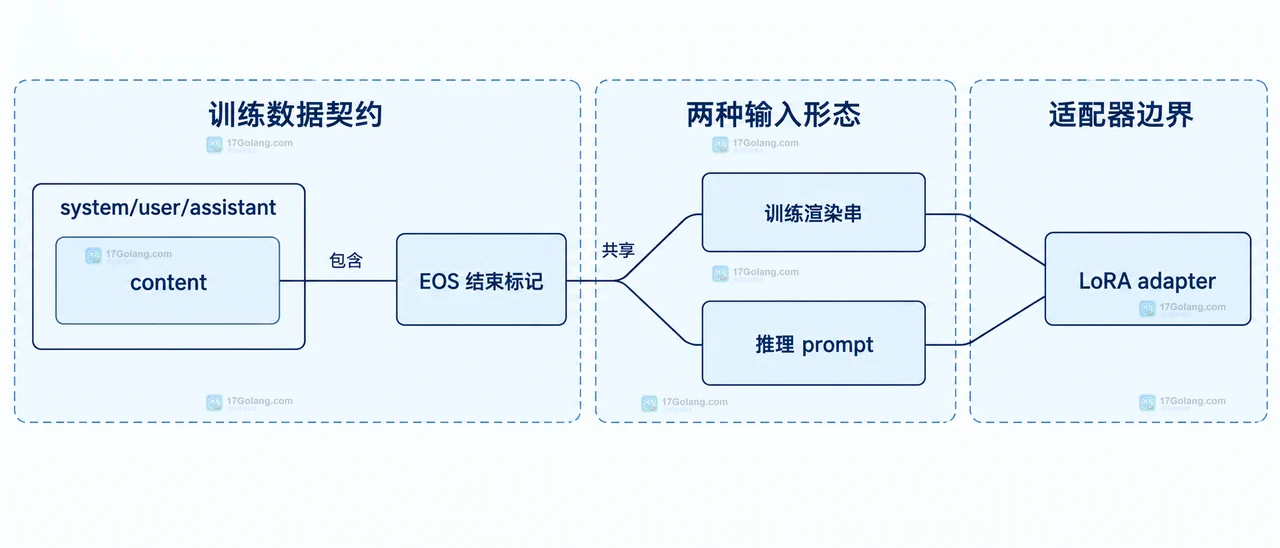 LoRA 微调效果不只取决于 rank 和学习率,训练样本的角色、模板、结束标记与推理入口也必须保持一致。本文用 messages 示例说明如何固定这份格式契约。426 收藏
-
 OpenAI File Search 可以在 vector store file 上写入 attributes,再用 file_search.filters 通过 eq、and、or、in 和数值范围条件缩小检索范围。本文用租户、语言和年份示例说明字段设计、复合过滤以及空结果排查。426 收藏
-
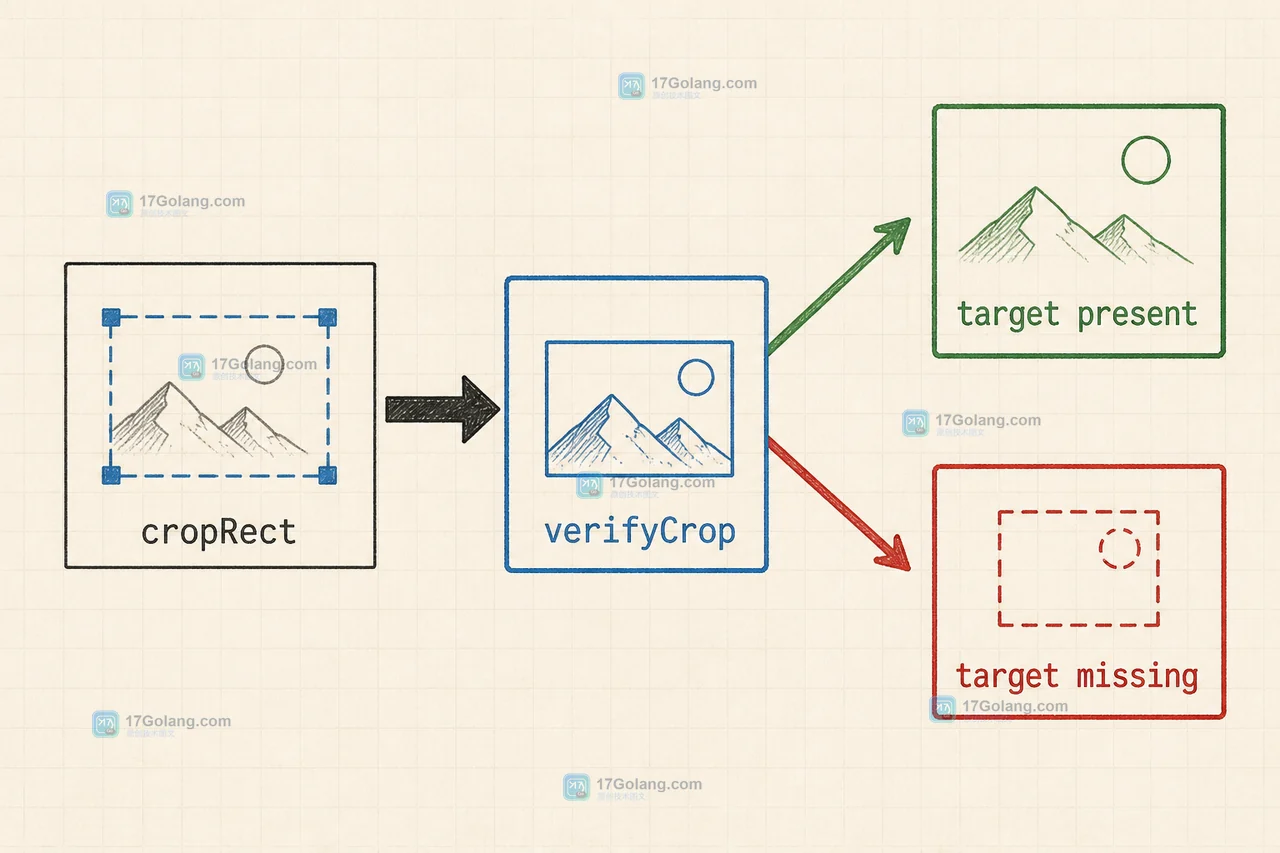 把整张长图直接交给视觉模型,常见结果是文字区域太小、成本偏高且难以复核。本文用 OCR 返回的 boundingPoly 先定位目标区域,再把归一化坐标映射为像素矩形,最后用二次识别确认裁剪没有偏移。425 收藏
-
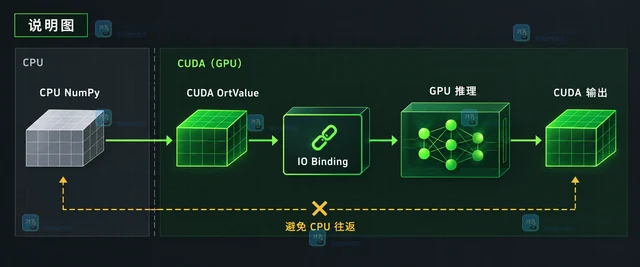 说明 ONNX Runtime Python 推理中 IO Binding 的设备驻留方式:用 CUDA OrtValue 绑定输入、在 GPU 上绑定或分配输出,并判断何时应该回传 CPU。424 收藏
-
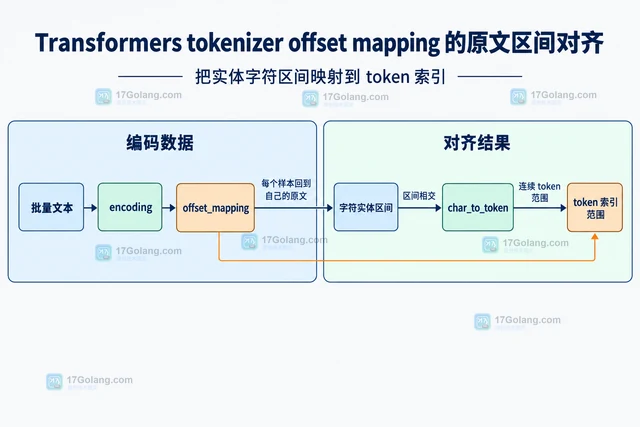 围绕 Hugging Face Transformers 的 Fast tokenizer 说明 offset_mapping 如何返回 token 对应的原文半开区间,处理特殊 token、空白、批量句对和截断,并给出实体字符区间转换为 token 范围的 Python 示例。423 收藏
-
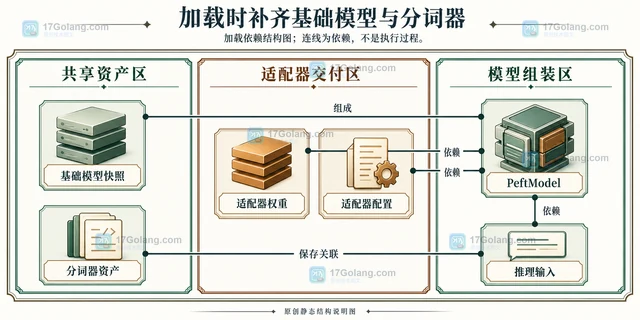 通过 PeftModel.save_pretrained 导出 LoRA 适配器,说明额外训练模块、嵌入层、基础模型依赖与训练断点的区别,并提供参数体积推算和文件统计写法。422 收藏
-
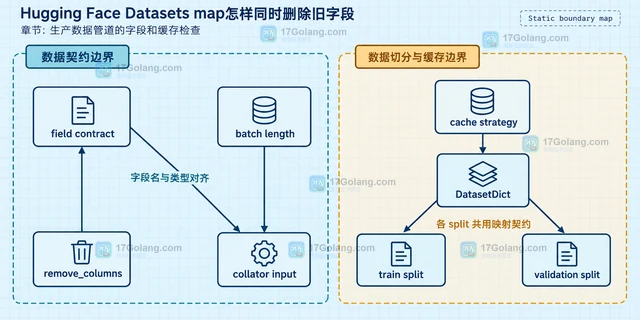 Hugging Face Datasets 用 map 转换样本时,可以通过 remove_columns 一次删除多个旧字段。本文说明单条与批量映射、同名覆盖、DatasetDict 和缓存边界。421 收藏
-
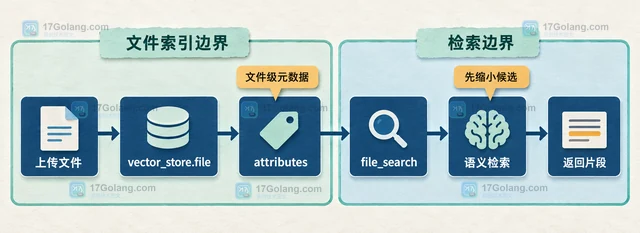 file search 的 filters 不是正文关键词过滤,而是先按 vector_store.file 的 attributes 缩小候选文件,再做语义和关键词检索。本文用 Python 示例说明 attributes、比较过滤、and/or 组合和无结果排查。420 收藏
-
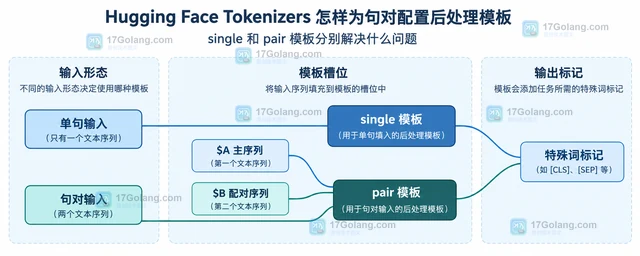 用 TemplateProcessing 为 Hugging Face Tokenizers 配置 single 与 pair 模板,说明 $A、$B、special_tokens 和 type_id 的对应关系,并整理句对长度与常见配置错误。420 收藏
-
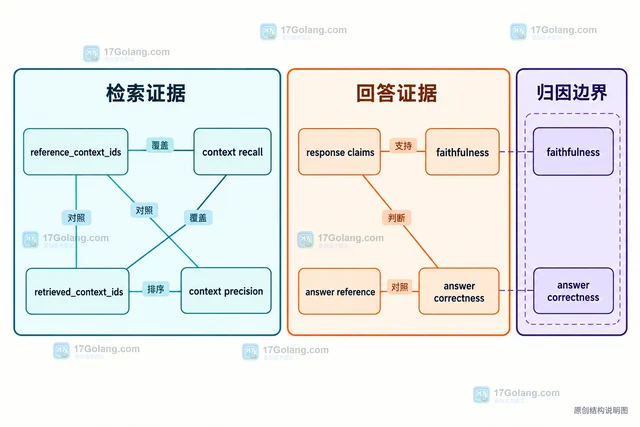 RAG 评测不要只看最终答案分数。把检索上下文、模型回答和参考信息记录在同一条样本中,再分别使用 context precision、context recall、faithfulness 与答案正确性指标,才能判断问题来自召回排序还是生成阶段。419 收藏
-
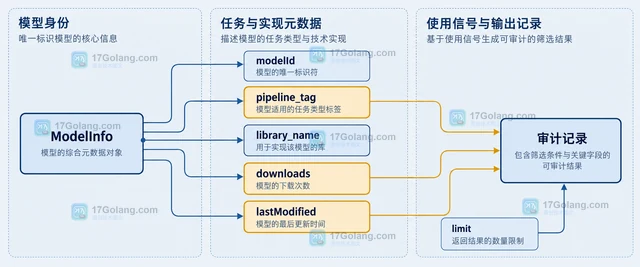 用 huggingface_hub 的 HfApi.list_models 按 pipeline_tag 筛选模型,并结合排序、数量限制和 ModelInfo 字段整理出可追踪的候选清单。419 收藏
-
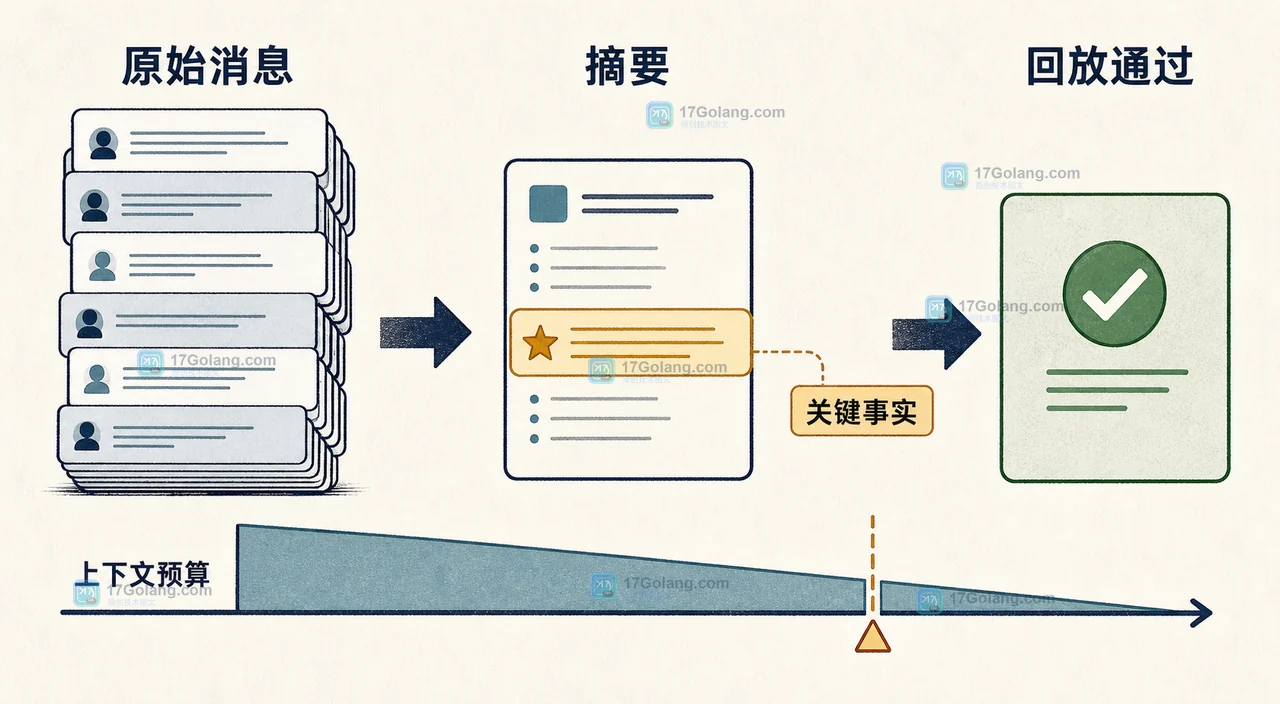 多轮对话变长后,简单截掉旧消息很容易让模型丢失用户约束。本文从上下文压缩的边界出发,拆解摘要漂移、关键事实遗漏和回放验收,用可重复的测试样例判断压缩是否真的可用。418 收藏
-
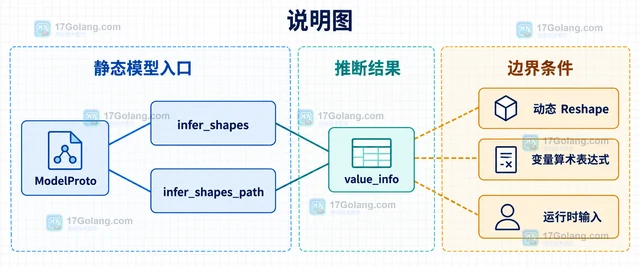 本文围绕 ONNX 动态输入的符号维度,说明 dim_param 与 dim_value 的区别、infer_shapes 的调用方式、value_info 的读取方法,以及动态 Reshape 和变量表达式带来的推断边界。418 收藏