
人工智能技术文章
-
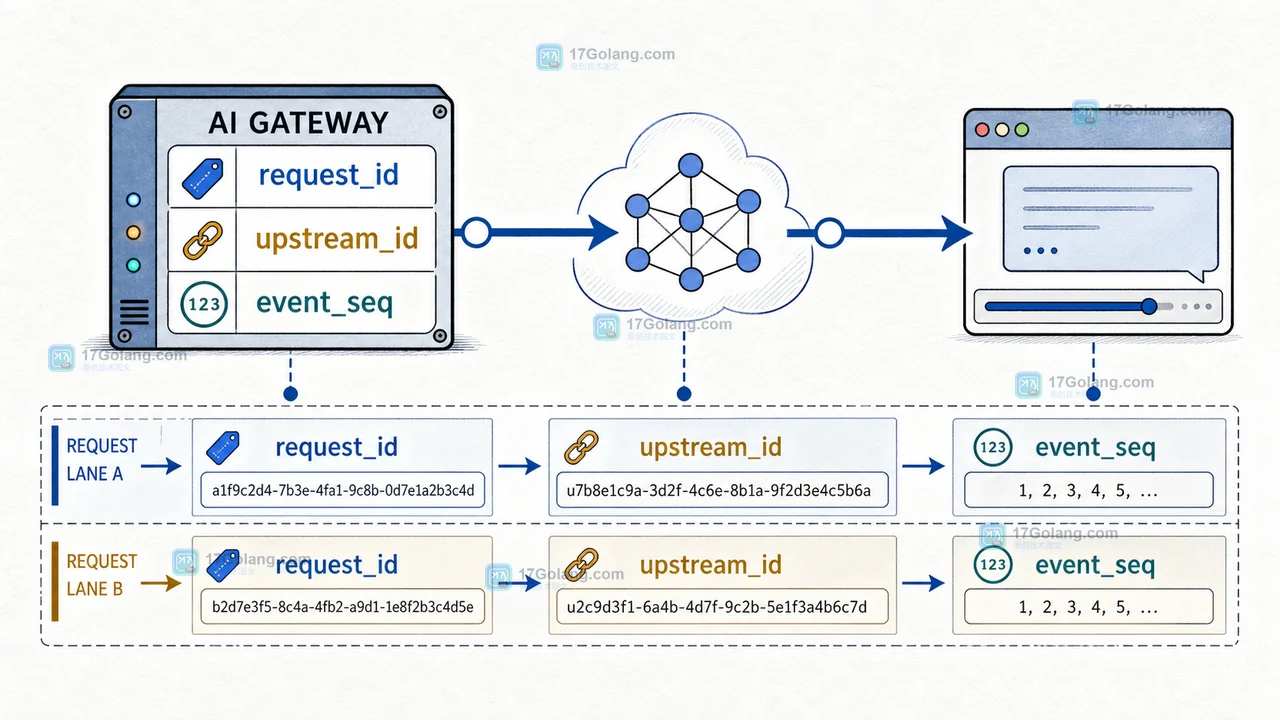 AI 网关同时承载多路流式回答时,连接复用、异步回调和日志采集很容易把不同请求的片段混到一起。本文用 request_id 贯穿入口、上游连接、事件转发和落盘日志,再配合状态机与断言,把串线问题变成可以复现、定位和验收的工程流程。407 收藏
-
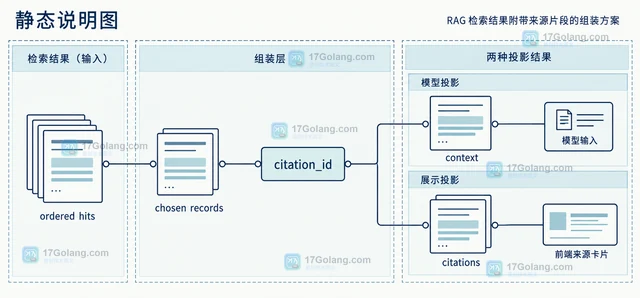 RAG 不要只把命中的文本拼成一段 prompt。本文用统一的切片记录保存来源标识、定位信息和分数,再分别投影为模型上下文与前端引用,处理去重、排序、截断和元数据缺失。407 收藏
-
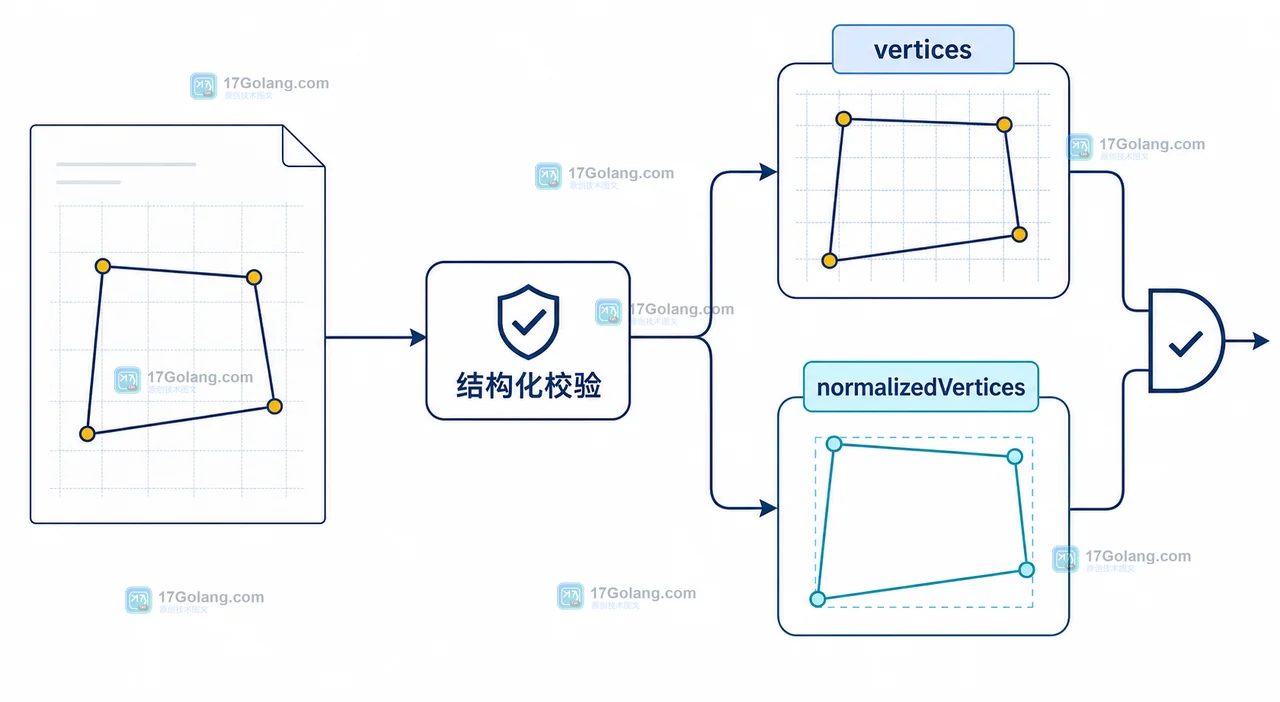 视觉语言模型接入 OCR 时,结果漂移往往不是模型突然失忆,而是裁切坐标、原图尺寸和结构化字段没有对齐。本文用一条可复核的数据路径拆开问题,并给出校验与回退做法。406 收藏
-
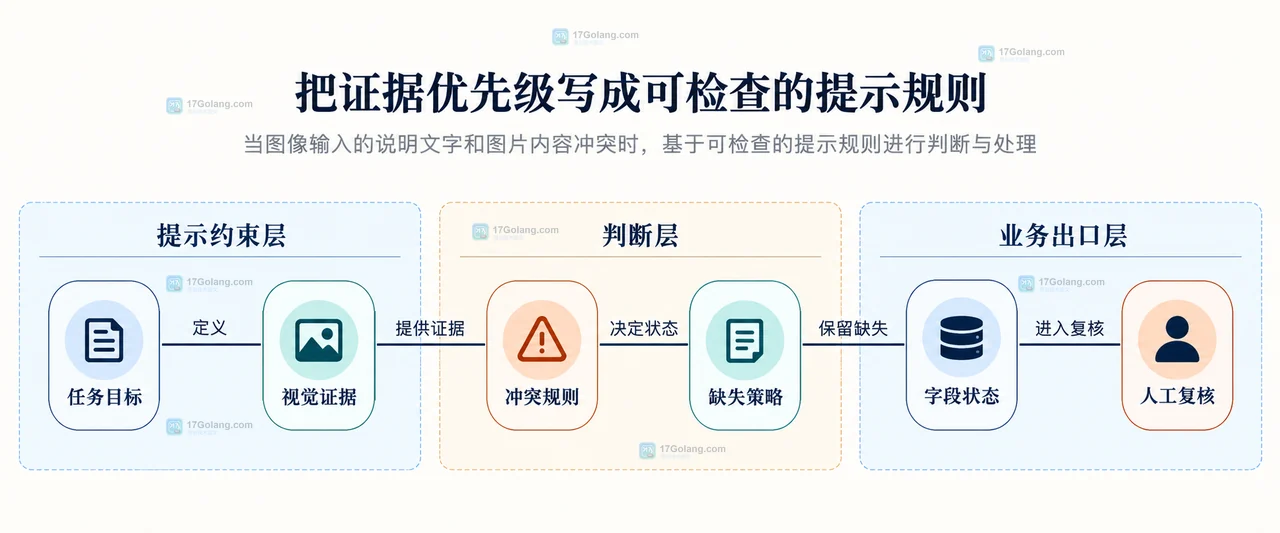 图像问答不稳定,常常不是模型不会看,而是说明文字和视觉证据没有分层。本文给出冲突分类、证据优先级、结构化输入和人工复核的实用提示设计。404 收藏
-
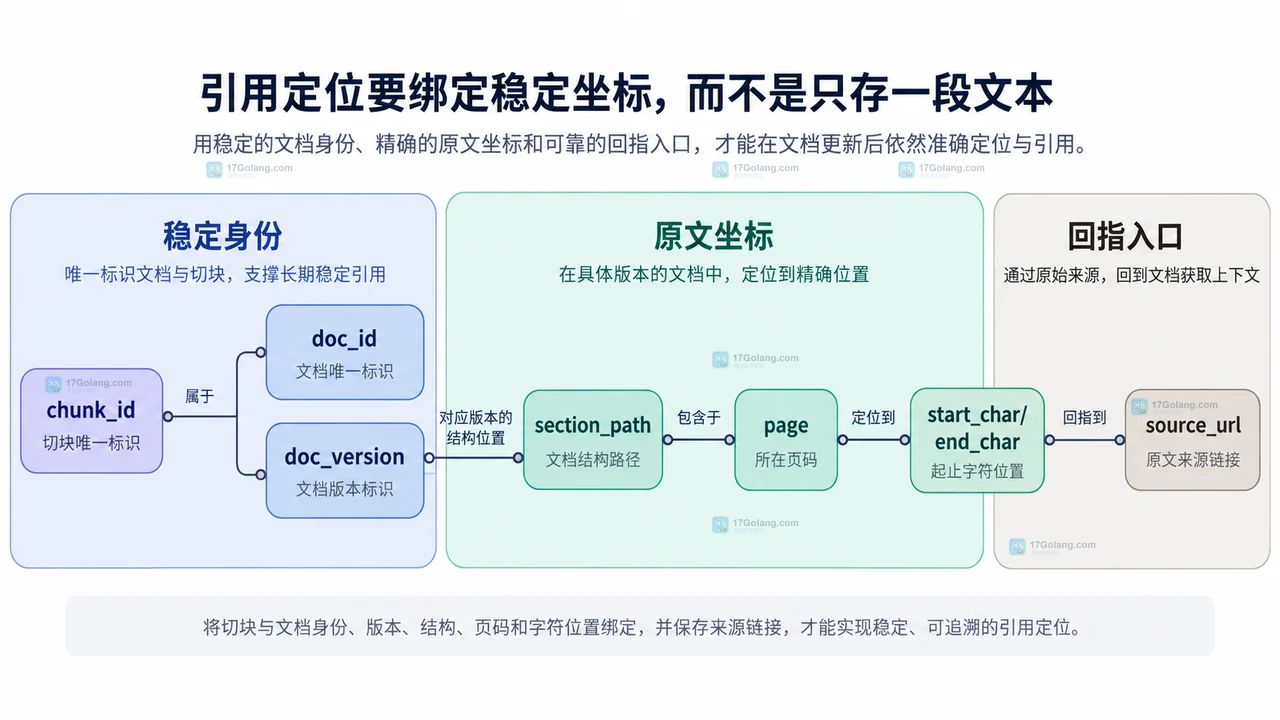 从文档结构、token预算、重叠窗口和稳定元数据四个方面,说明RAG切块与引用定位的配置方法、排查顺序和常见误区。404 收藏
-
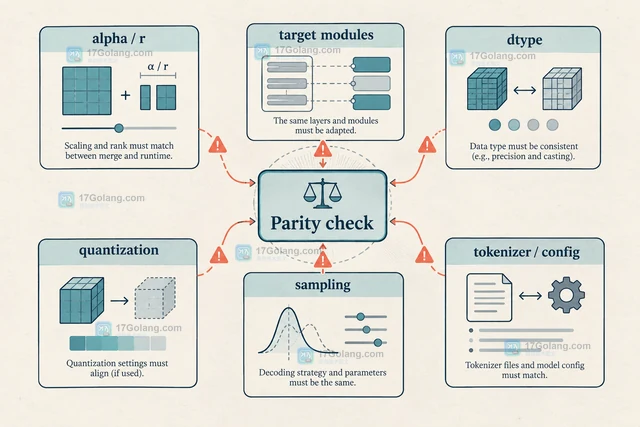 LoRA 合并后输出变化很大,先不要盲目重训。本文从基础模型、适配器缩放、量化与 dtype、推理随机性和 tokenizer 五层排查,并给出确定性对照代码与回归清单。404 收藏
-
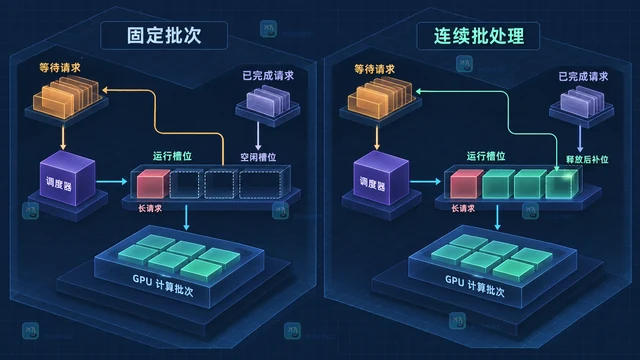 连续批处理会在每轮推理后移出已完成请求并补入新请求,减少批次槽位浪费;调优还需同时约束 Token 预算、KV Cache 与延迟。404 收藏
-
 用 Ollama Modelfile 固化 SYSTEM 系统提示和 num_ctx 上下文长度,说明 ollama create、ollama show、ollama ps 的配合方式,以及服务环境和客户端覆盖配置的排查思路。403 收藏
-
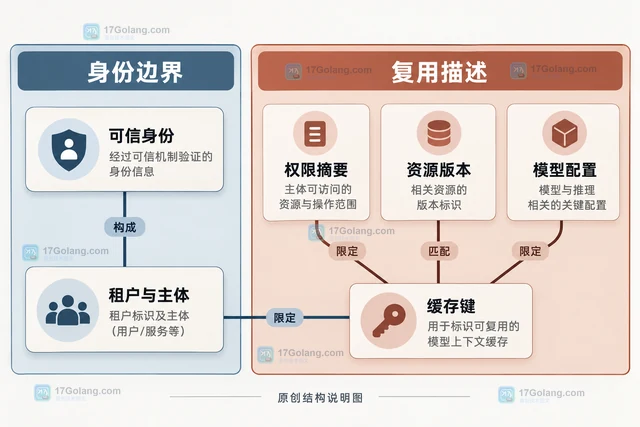 多租户模型服务复用上下文时,应把可信租户、主体、有效权限及资源版本纳入缓存描述,并保留命中授权与失效处理,避免仅凭相同问题共享私有材料。400 收藏
-
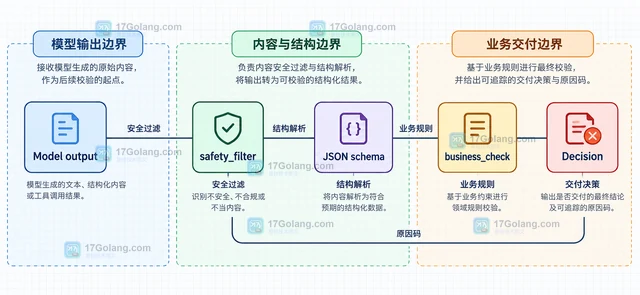 AI 输出过滤只负责内容风险,业务规则负责领域正确性。本文用三层状态和最小 Python 示例说明如何区分安全拒绝、结构重试、业务冲突与人工复核,避免把所有失败都记成一个 blocked。400 收藏
-
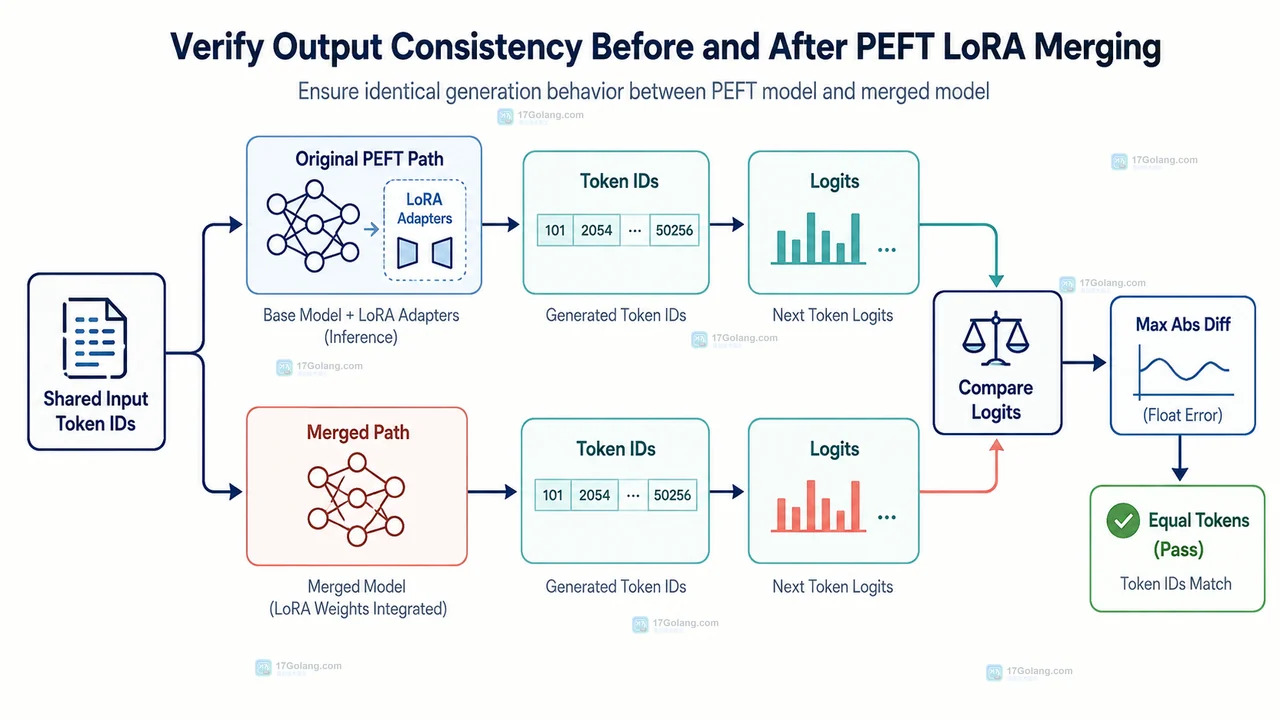 用 PEFT 的 merge_and_unload 合并 LoRA adapter,固定 tokenizer、输入和生成参数,再通过 token 与 logits 对比判断合并前后是否一致。399 收藏
-
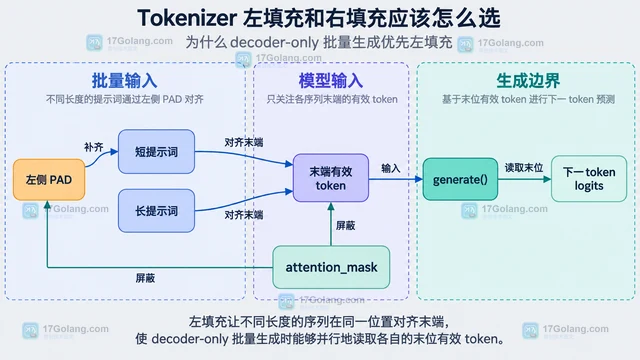 按 decoder-only 生成、训练、encoder-only 和 encoder-decoder 任务拆解 Tokenizer 左右填充选择,并说明 attention_mask、pad_token 与标签屏蔽。399 收藏
-
 Captum IntegratedGradients 返回的 convergence delta 是完整性差值的逐样本近似误差信号。本文说明它比较什么、如何读取,以及怎样结合 n_steps 和 method 做有边界的判断。399 收藏
-
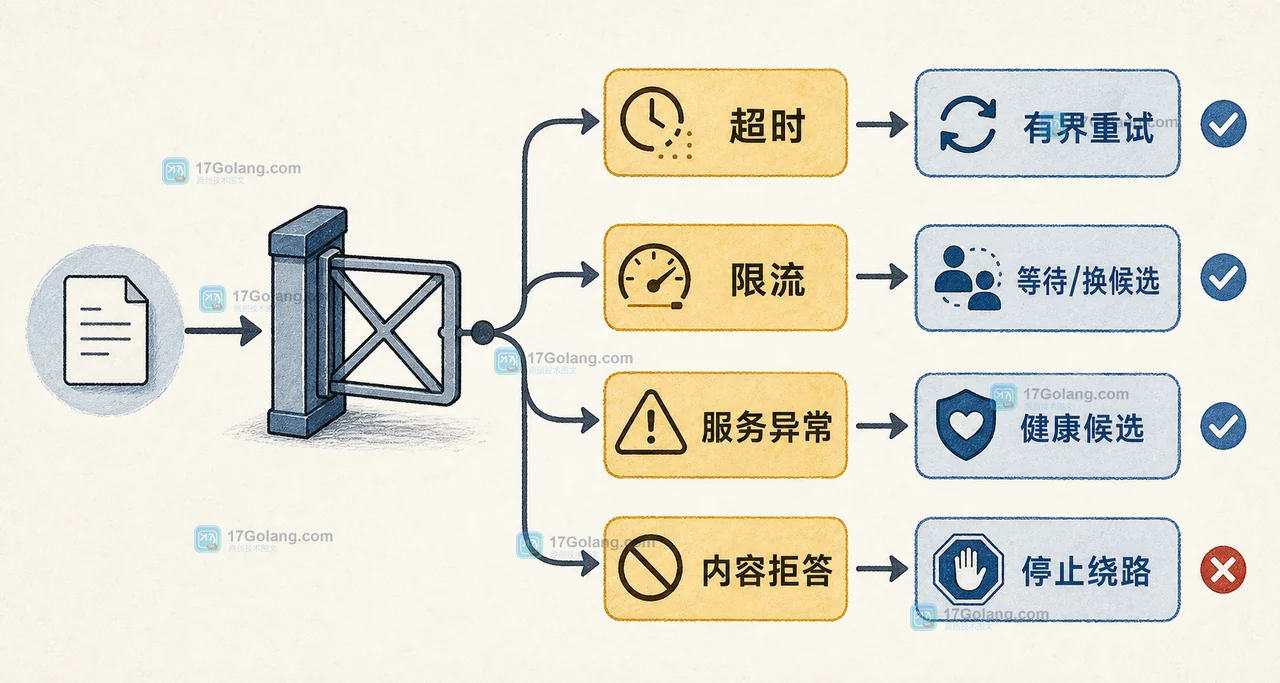 同一个模型请求失败,并不代表应该立刻换到下一个模型。本文按超时、限流、服务异常和内容拒答拆开处理,给出路由状态、重试边界、降级策略与可验收的实现路径。398 收藏
-
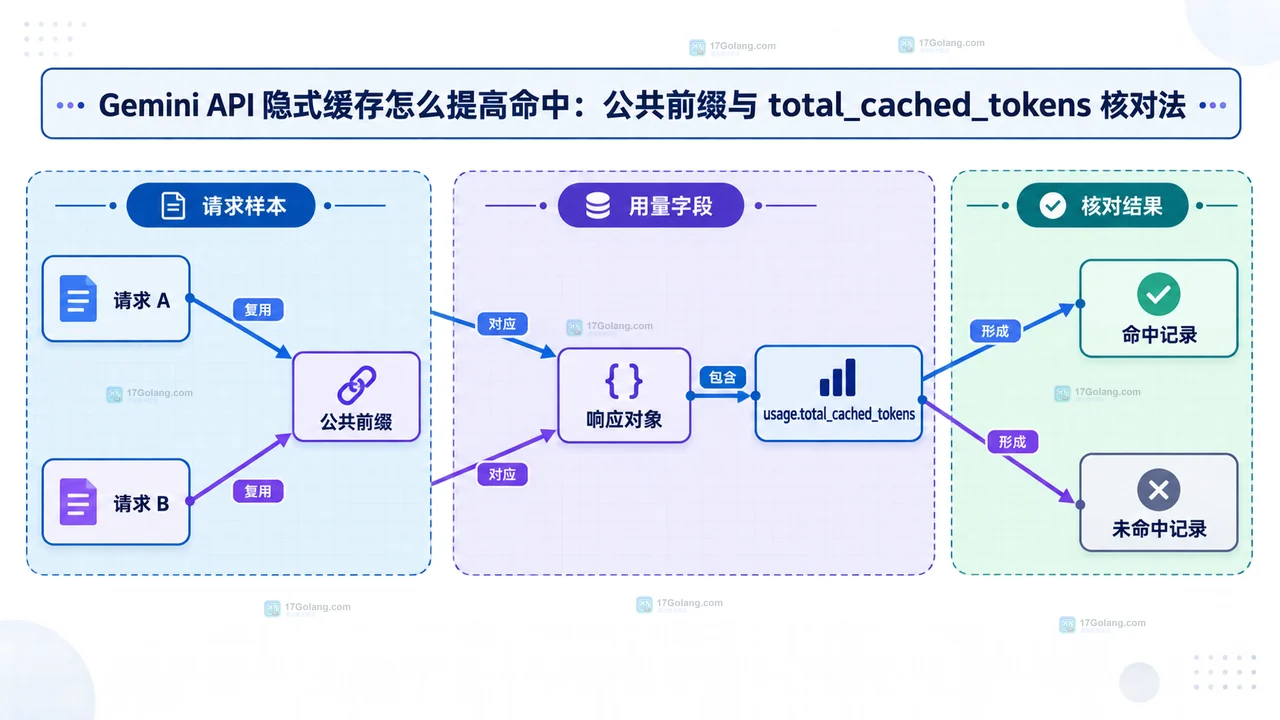 说明 Gemini API 隐式缓存的启用范围、最低输入 token 门槛、公共前缀组织方式,以及如何用 usage.total_cached_tokens 核对命中。398 收藏