
人工智能技术文章
-
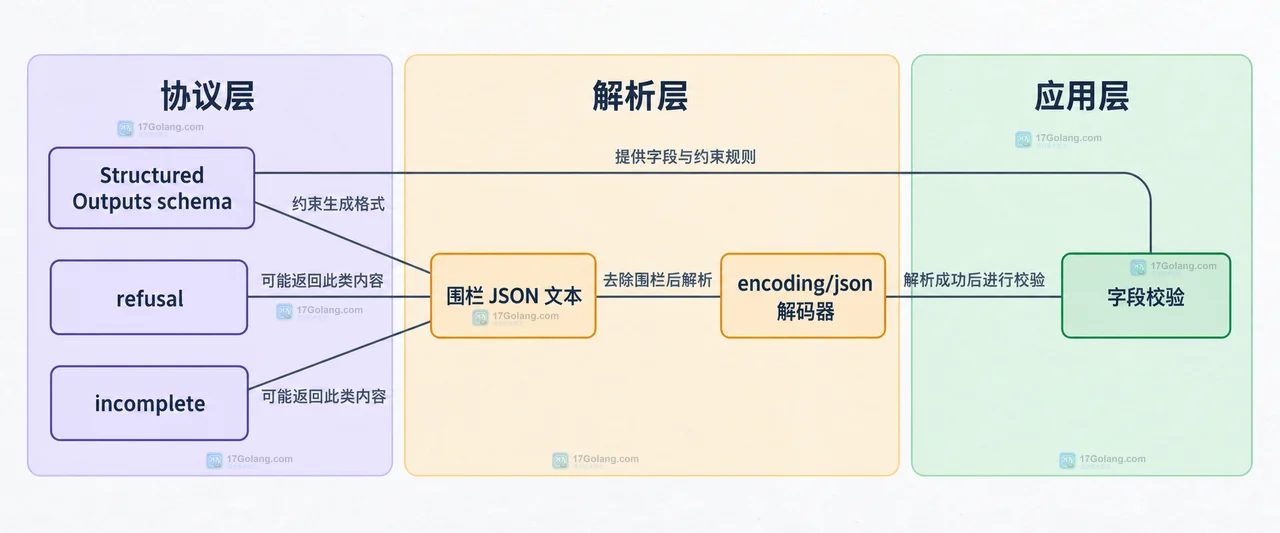 模型输出 JSON 偶尔带有 Markdown 围栏时,先判断拒答和截断状态,再只清理首尾围栏,最后用 encoding/json 解码并执行字段级业务校验。398 收藏
-
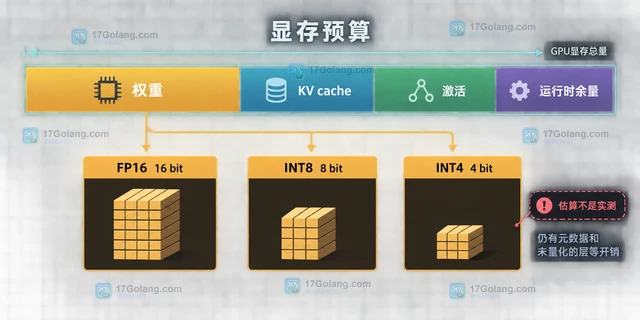 量化推理选精度不能只看模型参数量,还要扣除 KV cache、激活、运行时余量和量化元数据。本文用显存预算、位宽估算和 Transformers BitsAndBytesConfig,说明何时选择 FP16/BF16、INT8 或 INT4,并给出吞吐与质量的验证边界。398 收藏
-
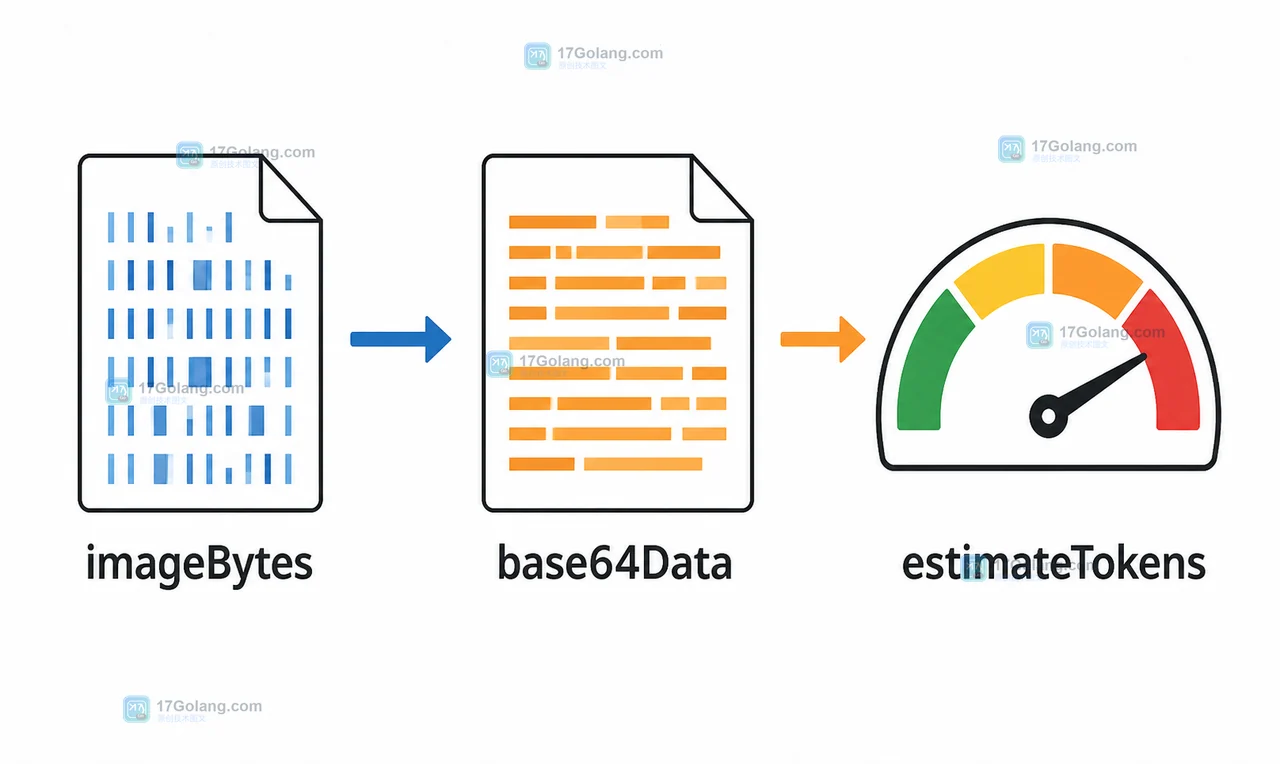 多模态接口接入后,小图片能成功,大图片却报请求过大或上下文超限。本文从原始字节、base64 膨胀和 token 预算三层定位问题,再给出压缩、尺寸校验与请求组装的可复现处理顺序。397 收藏
-
科技周边 · 人工智能 | 1个月前 | 人工智能 · 性能排查 · 提示词工程 · 提示词缓存动态字段 DynamicCache KV缓存 Transformers缓存 past_key_values use_cache StaticCache
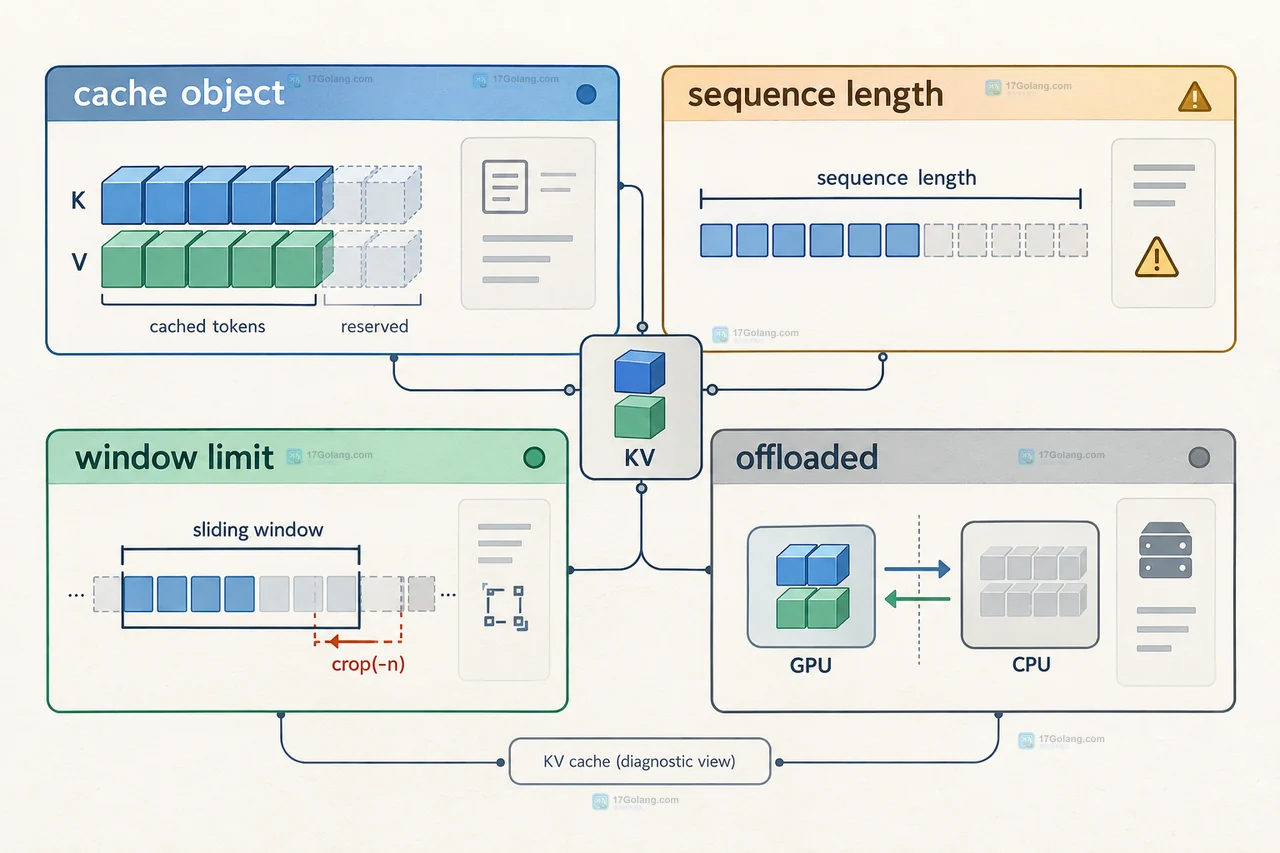 本文以 Hugging Face Transformers 的 DynamicCache 为例,说明提示词缓存动态字段的配置边界,覆盖 use_cache、past_key_values、迭代对话、窗口上限、回滚、显存排查以及切换 StaticCache 的判断方法。397 收藏
-
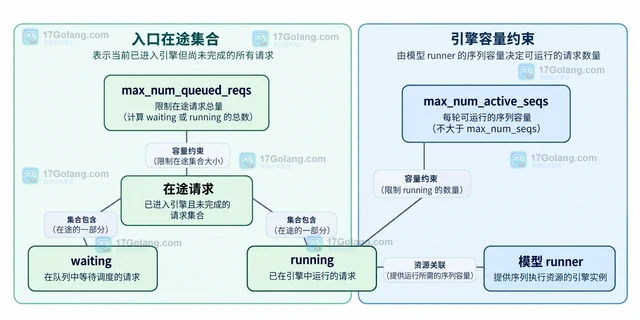 区分 vLLM 连续批处理的序列容量、token 预算、活跃请求和入口在途限制,给出配置示例、版本条件以及排队和多副本的适用边界。397 收藏
-
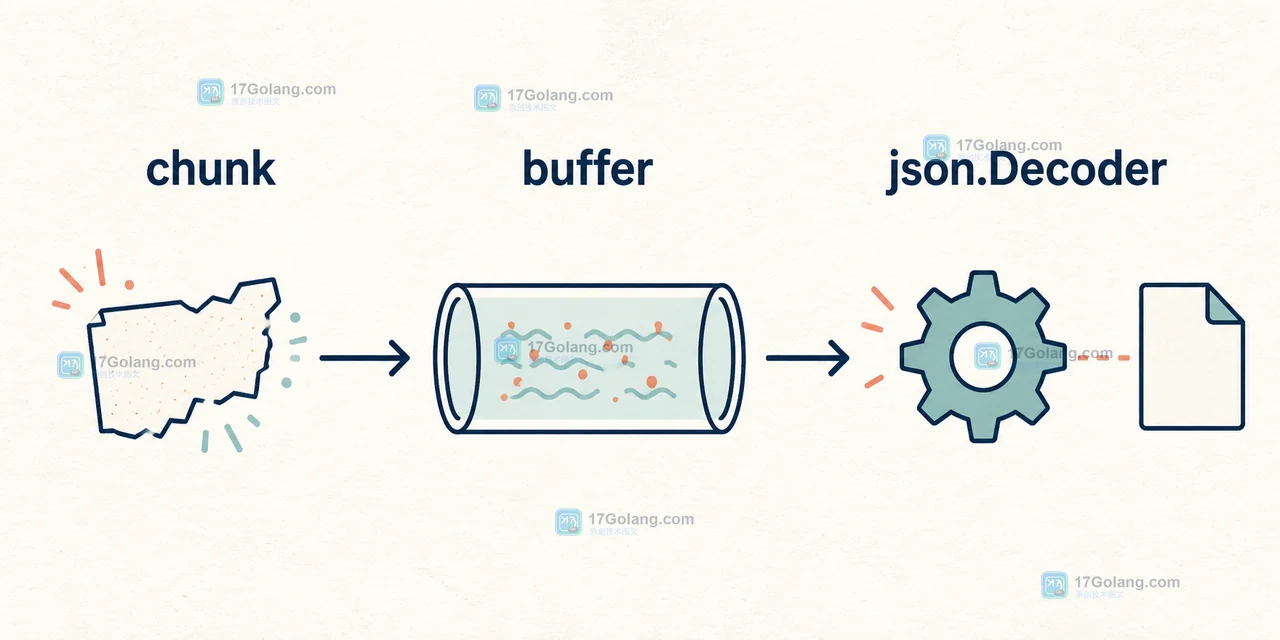 AI 接口采用流式输出后,JSON 可能被拆在多个数据块里,直接逐块反序列化会遇到半截对象和重复消费。本文用 Go 的缓冲区、边界扫描和字段完整性检查,构造一条可复现的流式解析链路。395 收藏
-
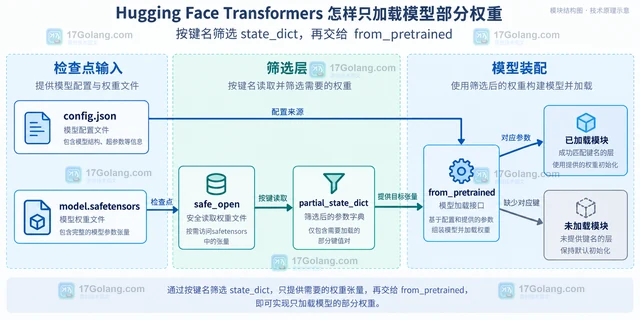 用 Transformers 按键名筛选 state_dict 只加载目标模块,并区分部分权重加载与 device_map 显存分配,避免把随机初始化层误当成预训练权重。395 收藏
-
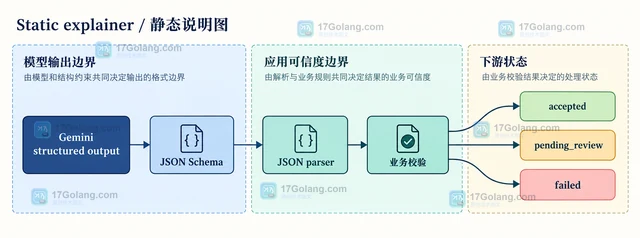 AI 结构化输出并不等于业务数据已经可信。本文用 Gemini API 演示如何区分接口失败、JSON 解析失败和语义校验失败,并把不可用结果安全降级到待审核流程。395 收藏
-
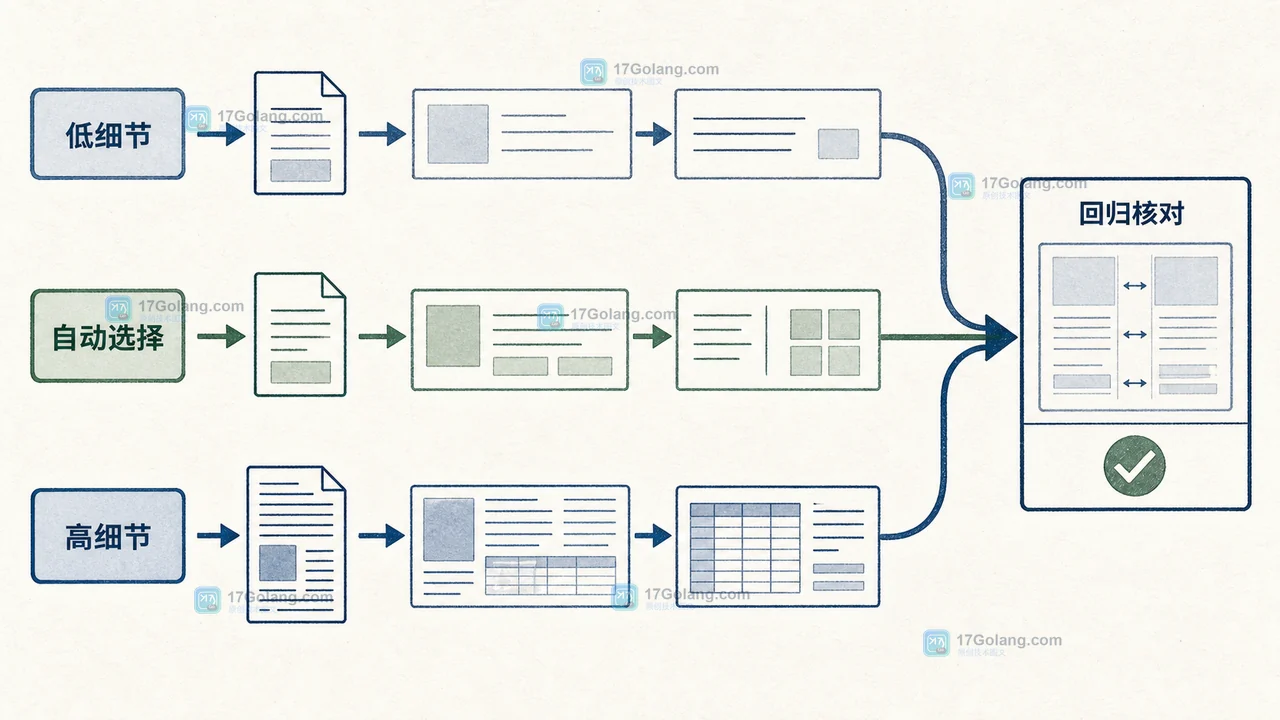 多模态知识库接入图片后,成本和延迟往往不是由文件大小单独决定。本文从图片任务、detail 级别、裁剪策略和上下文预算四个维度,给出可执行的输入分层与验收方法。394 收藏
-
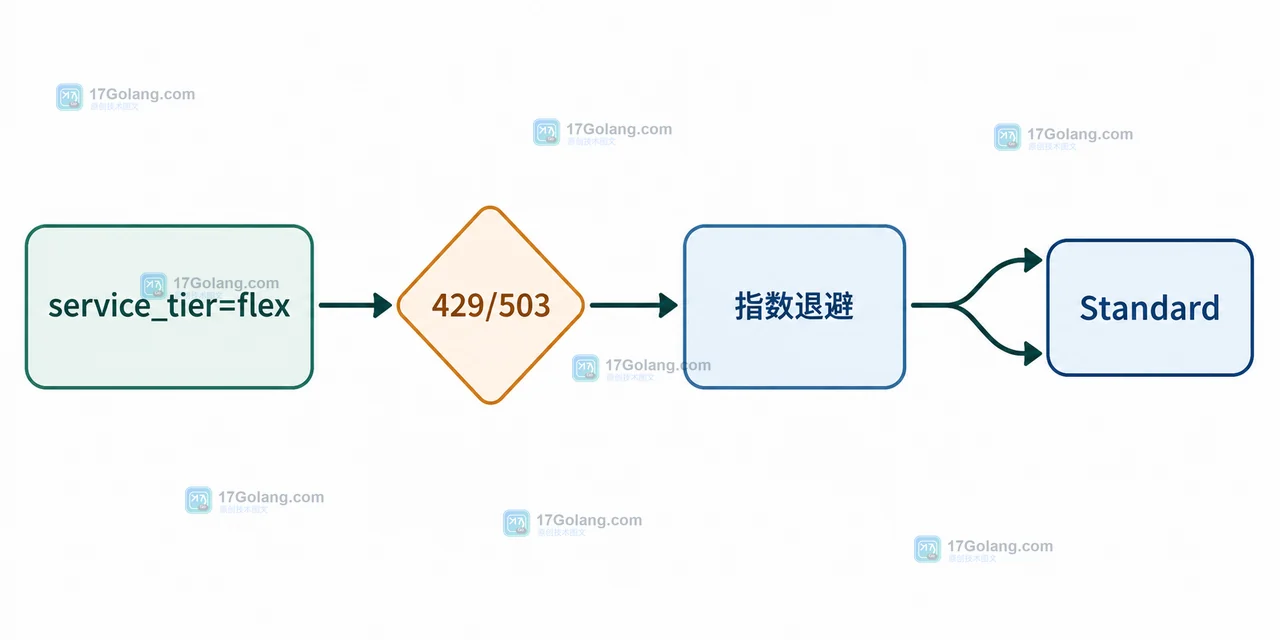 Gemini Flex inference 用标准价格的一半换取可让渡容量,适合不赶实时结果的评测、数据丰富和后台链路。本文用 service_tier=flex 的请求示例拆开 429、503、超时、重试和 Batch 的边界,避免把低价请求误接到用户关键路径。394 收藏
-
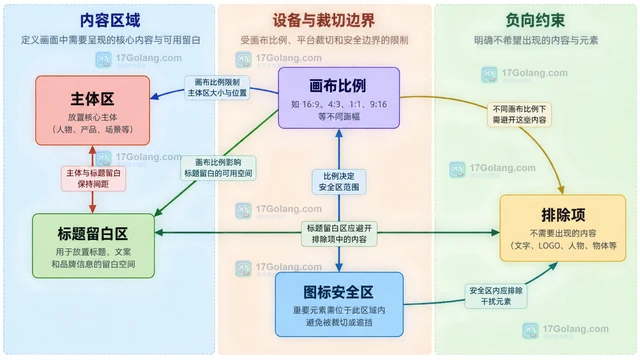 图像生成提示词不要只堆风格词。本文把任务目标、主体、位置、留白、画幅和排除项拆成可复用结构,说明如何让生成结果更贴近文章配图、海报或手机画布的版式要求。394 收藏
-
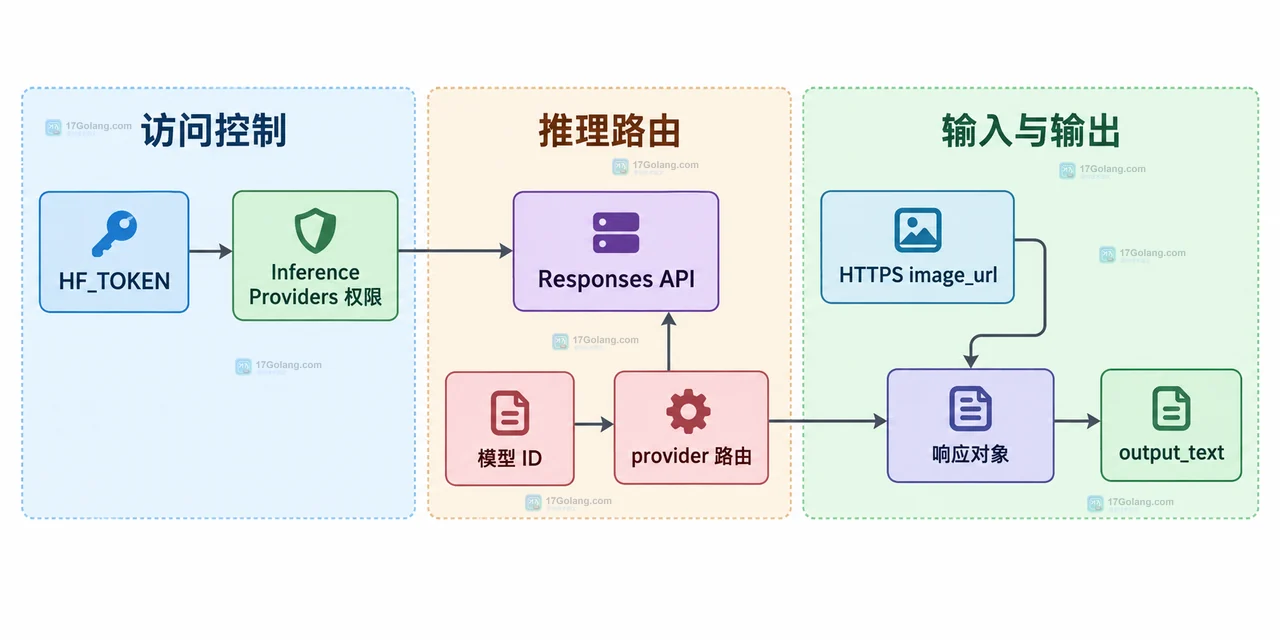 Hugging Face Responses API 可以在同一个 input 数组中组合 input_text 与 input_image。本文用 Python 和 OpenAI SDK 说明请求结构,并按令牌权限、模型路由、图片 URL 和输出字段拆解常见失败原因。392 收藏
-
 JiWER 不只返回 WER 数字,还能通过 process_words 得到逐句的 AlignmentChunk 对齐对象。本文说明 WordOutput.alignments 的结构、四类词位操作、四个索引字段,以及如何用 visualize_alignment 输出可读的对齐文本。392 收藏
-
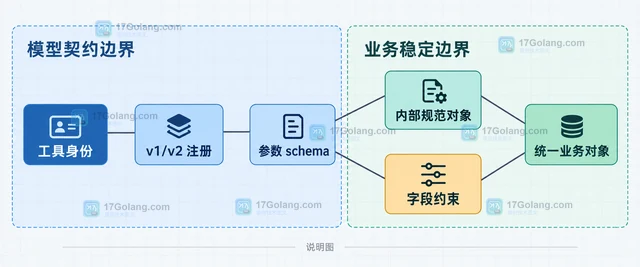 AI 工具的函数参数 schema 不应靠改描述文本维持兼容。本文用 strict schema 的可空字段、v1/v2 工具身份和服务端适配器,说明如何处理新增参数、字段改名、类型变化与调用方迁移,并给出可观察的下线指标。391 收藏
-
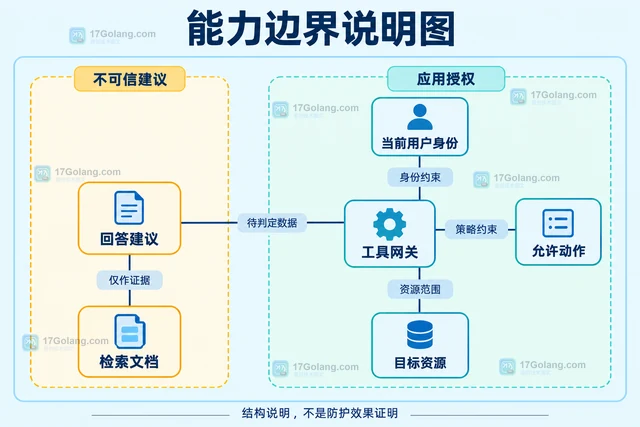 RAG检索片段应保持为不可信证据,而不是新的控制指令。本文讨论上下文分区、只读抽取和应用侧权限判定的取舍,说明提示词与摘要的局限,以及正常引用、过度拒绝和越权风险应分开观察。390 收藏