
人工智能技术文章
-
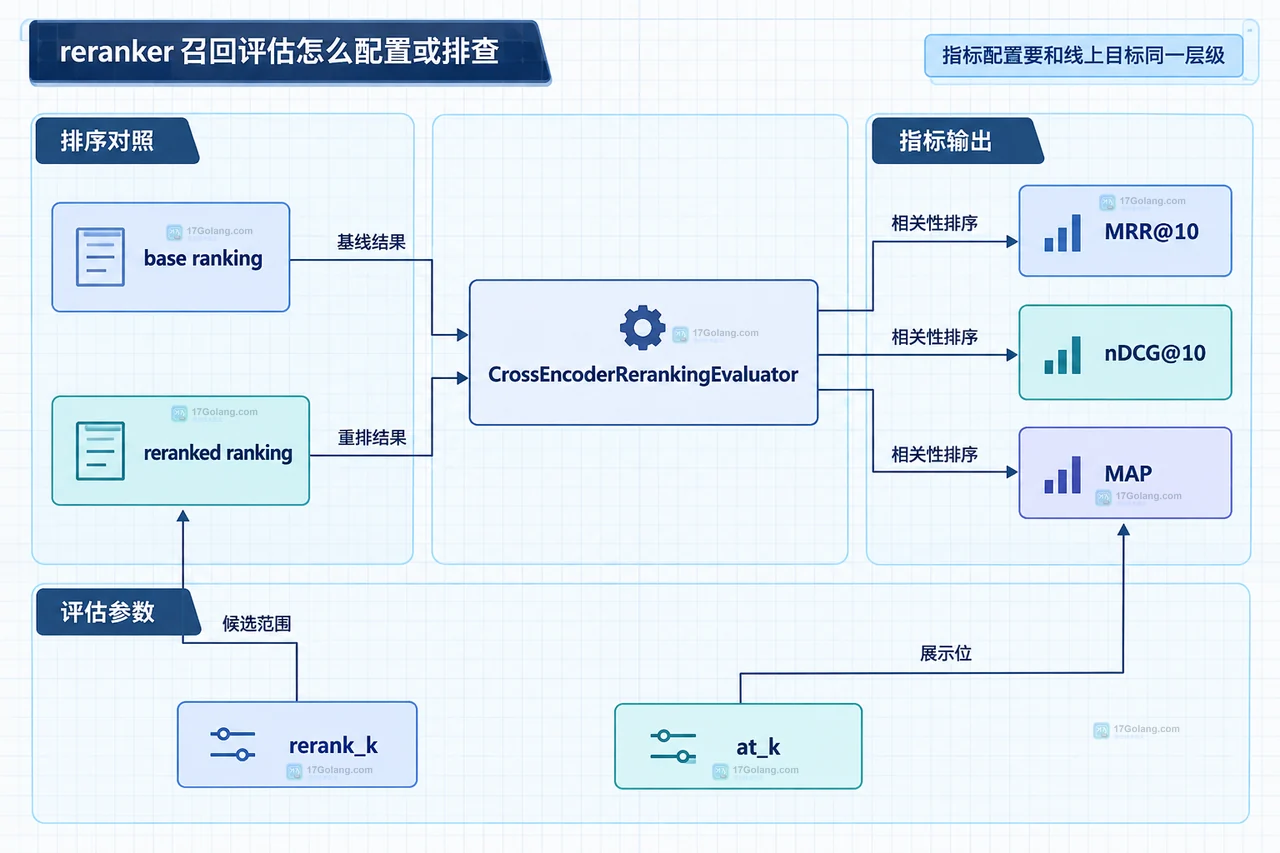 围绕真实初筛候选集配置 reranker 评估,说明 positive、negative、documents、candidate_k、rerank_k 的边界,并用 MRR@10、nDCG@10、MAP 对比基线与重排结果,定位召回、截断和分数解释问题。388 收藏
-
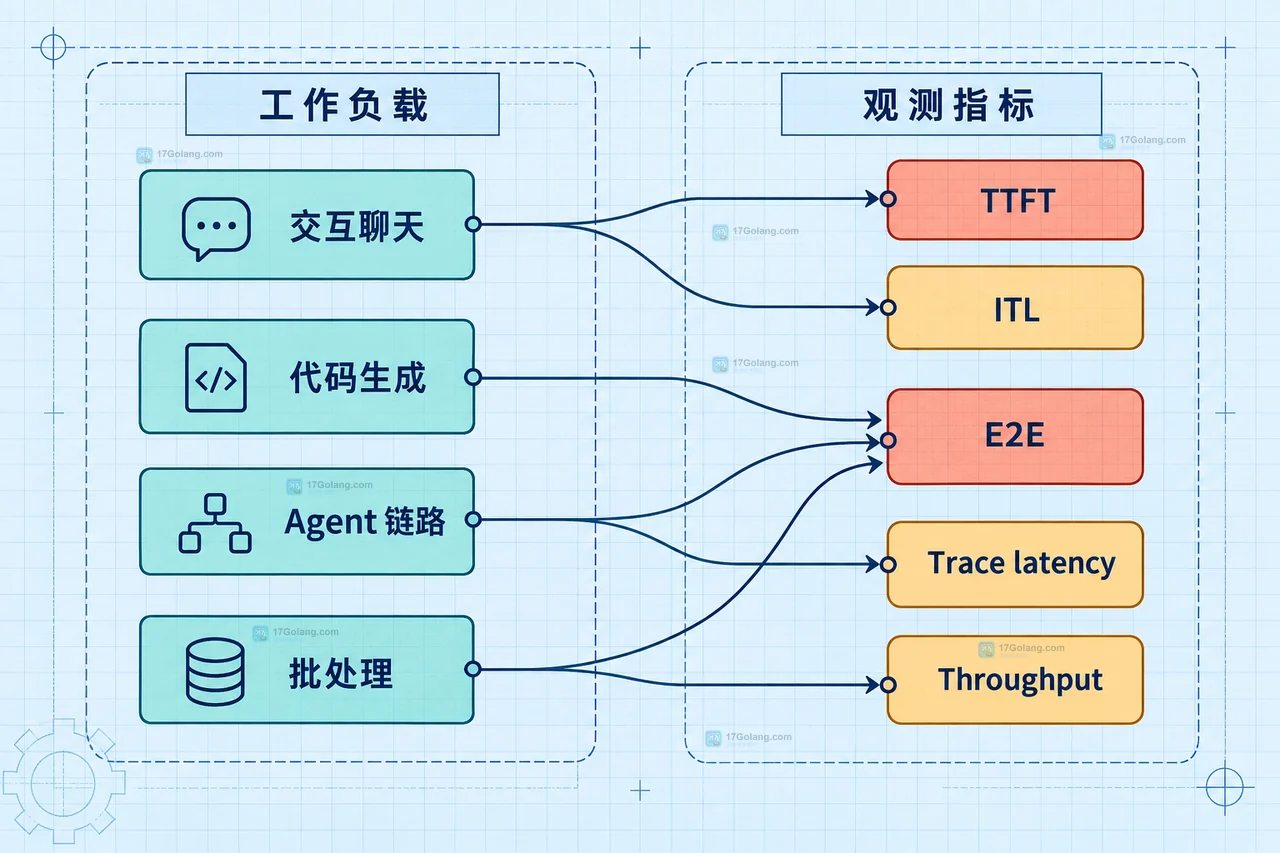 AI 推理延迟不能只看一个平均数:本文用 TTFT、TPOT/ITL 和端到端耗时拆开聊天、Agent、代码生成与批处理的观测口径,并给出排队、检索、prefill、decode 的定位方法。387 收藏
-
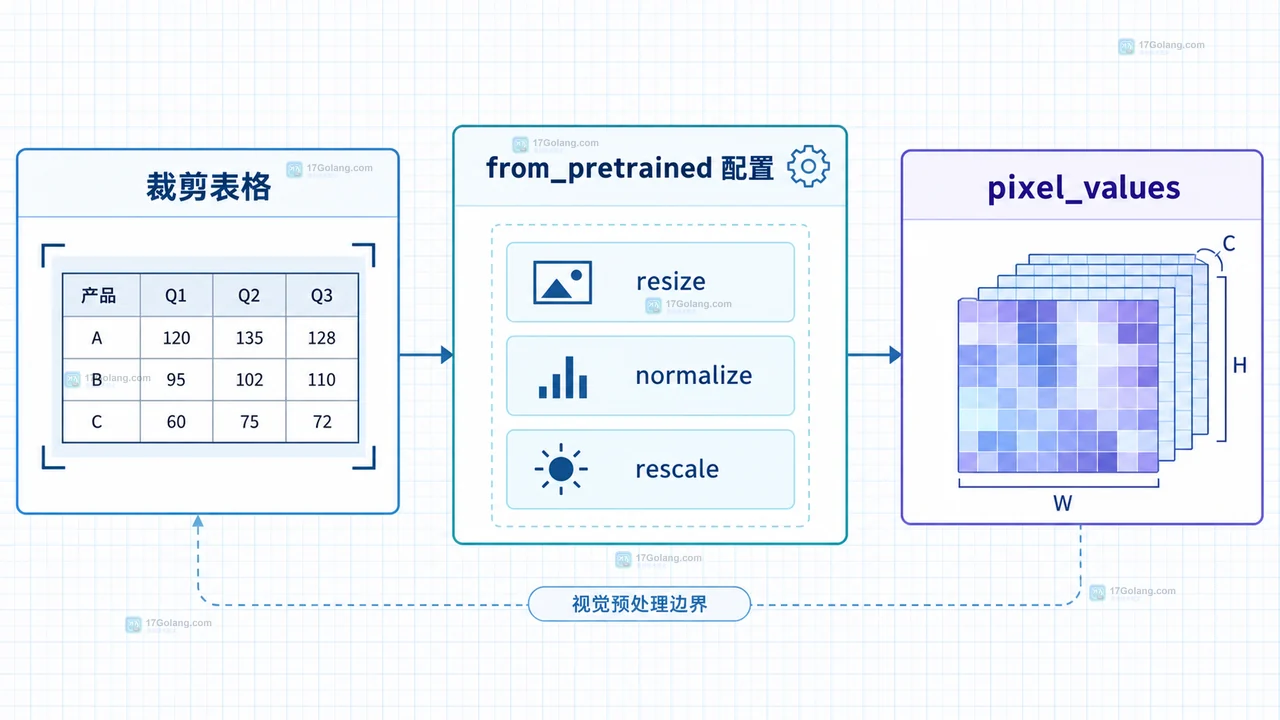 视觉表格识别前,先统一 xyxy 坐标、比例扩边和边界裁剪,再交给 Hugging Face image processor 做 resize、归一化等预处理。本文给出可复用代码和排查清单。387 收藏
-
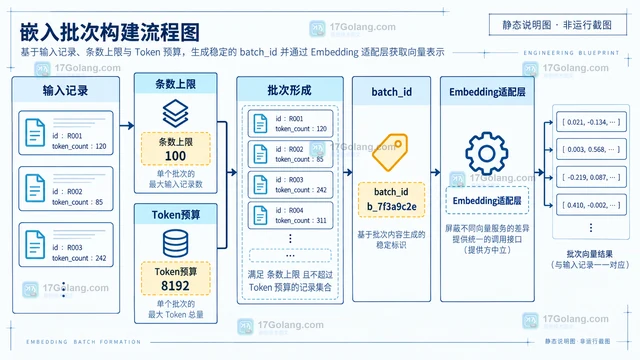 从批次边界、吞吐控制、错误分流和幂等写入四个层面,说明 Embedding 批量生成如何稳定处理长文本、429、超时和进程重启。387 收藏
-
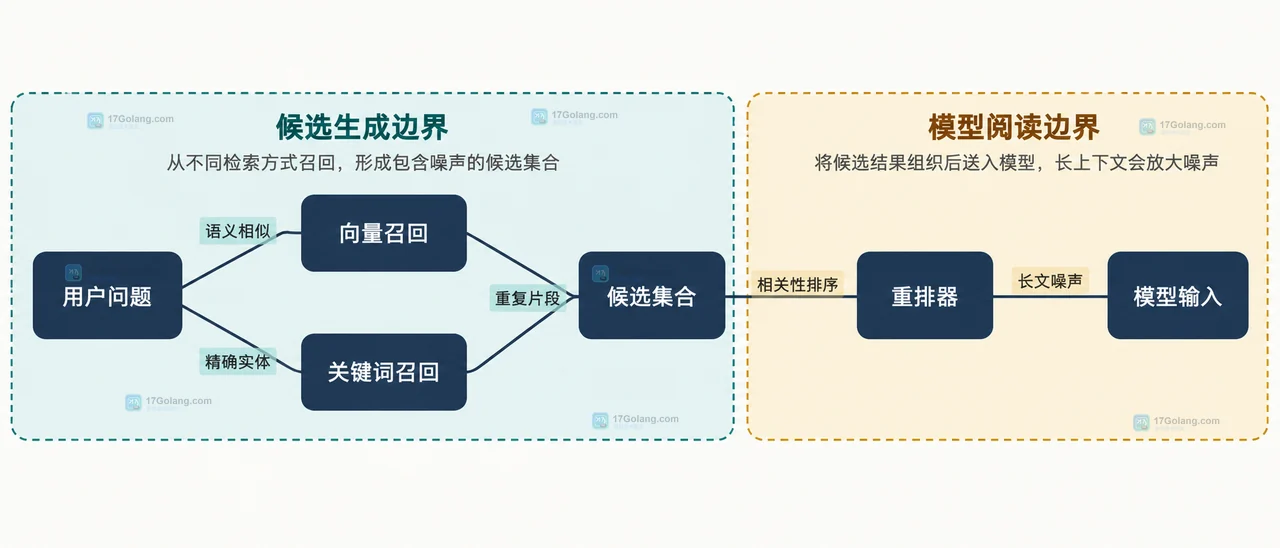 模型能接收更长输入,不代表它会更稳定地使用检索结果。本文从位置效应、候选重复和长文噪声解释原因,并给出混合召回、重排、去重与 token 预算的收敛做法。386 收藏
-
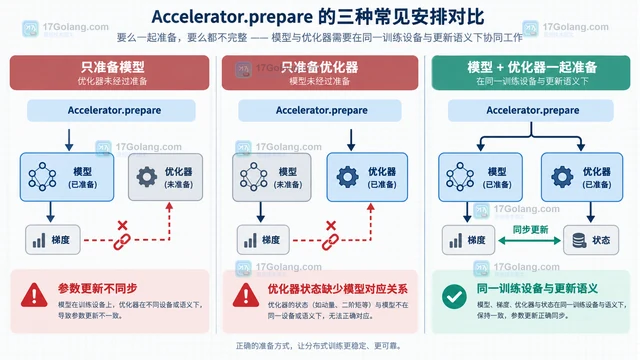 Accelerator.prepare 不只是把模型搬到设备上;训练时模型包装、参数位置、优化器参数组和状态必须保持一致,所以通常要把模型与优化器一起交给 Accelerate 准备。本文用最小训练骨架说明对象顺序、调度器和推理场景的边界。386 收藏
-
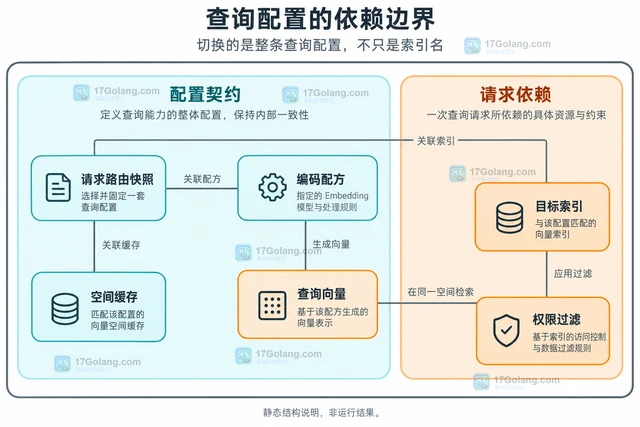 Embedding 模型更换后应隔离新旧向量空间,从原始文本重算文档向量,并成套切换查询配置。本文说明版本化双写、删除同步、缓存隔离和失败回退条件。386 收藏
-
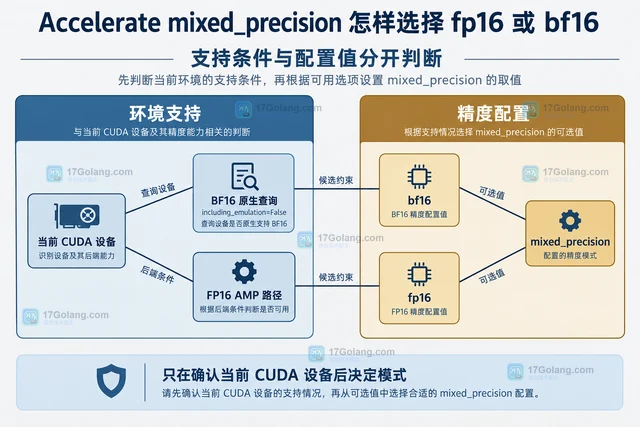 Accelerate 的 fp16 与 bf16 应按当前设备支持和模型数值行为选择。本文限定普通单卡 CUDA 场景,说明保守 BF16 查询、完整参数接入、梯度缩放与 no 模式对照,不以启动成功代替训练稳定性判断。386 收藏
-
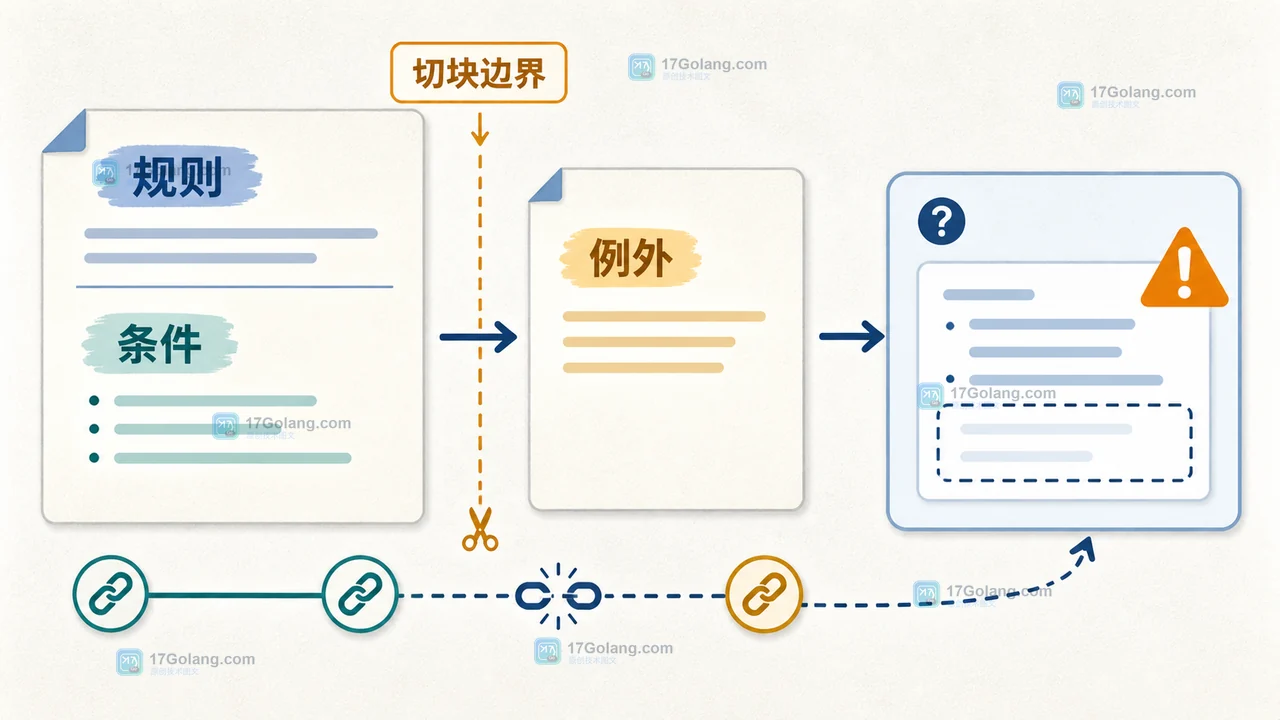 RAG 检索命中并不等于答案可靠。本文从文档切块边界、条件与例外的证据链、引用片段校验三个角度,说明如何定位答案被带偏的原因并建立可复查的回归检查。385 收藏
-
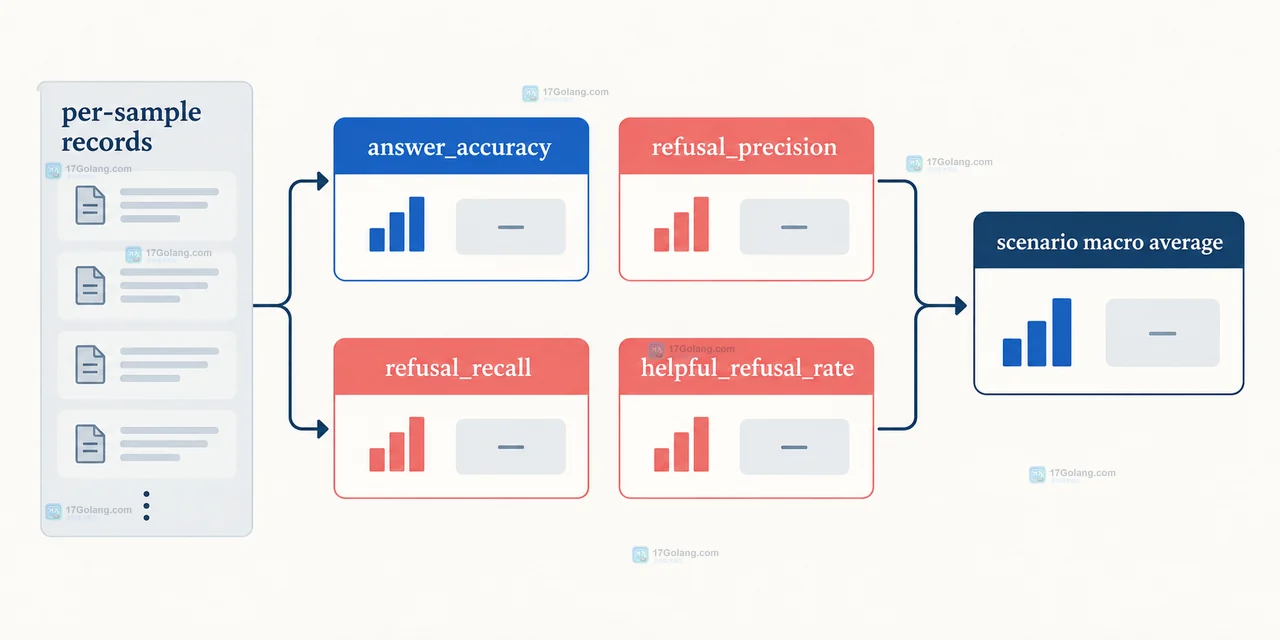 AI 评测集不要只放标准答案。把应答、应拒答和边界样本分开,记录 expected_action、拒答理由、人工标注和安全替代建议,再分别计算准确率、漏拒答率与拒答帮助度。385 收藏
-
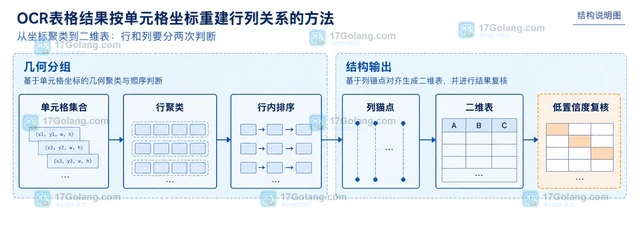 OCR 通常先返回文本、坐标和置信度,不会直接给出可用的二维表。通过统一坐标、按垂直重叠聚类行、按横坐标排序并推断列锚点,可以重建表格关系,同时保留低置信度单元格供复核。385 收藏
-
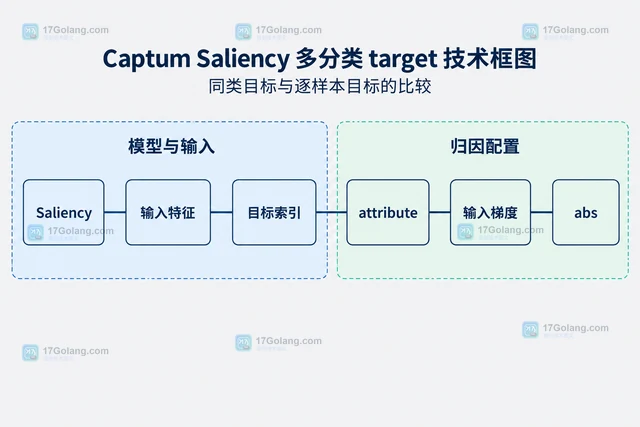 Captum Saliency 对多分类输出需指定归因目标。本文用线性三分类模型演示统一类别与逐样本 target,说明梯度形状、abs 参数及真实模型接入条件。385 收藏
-
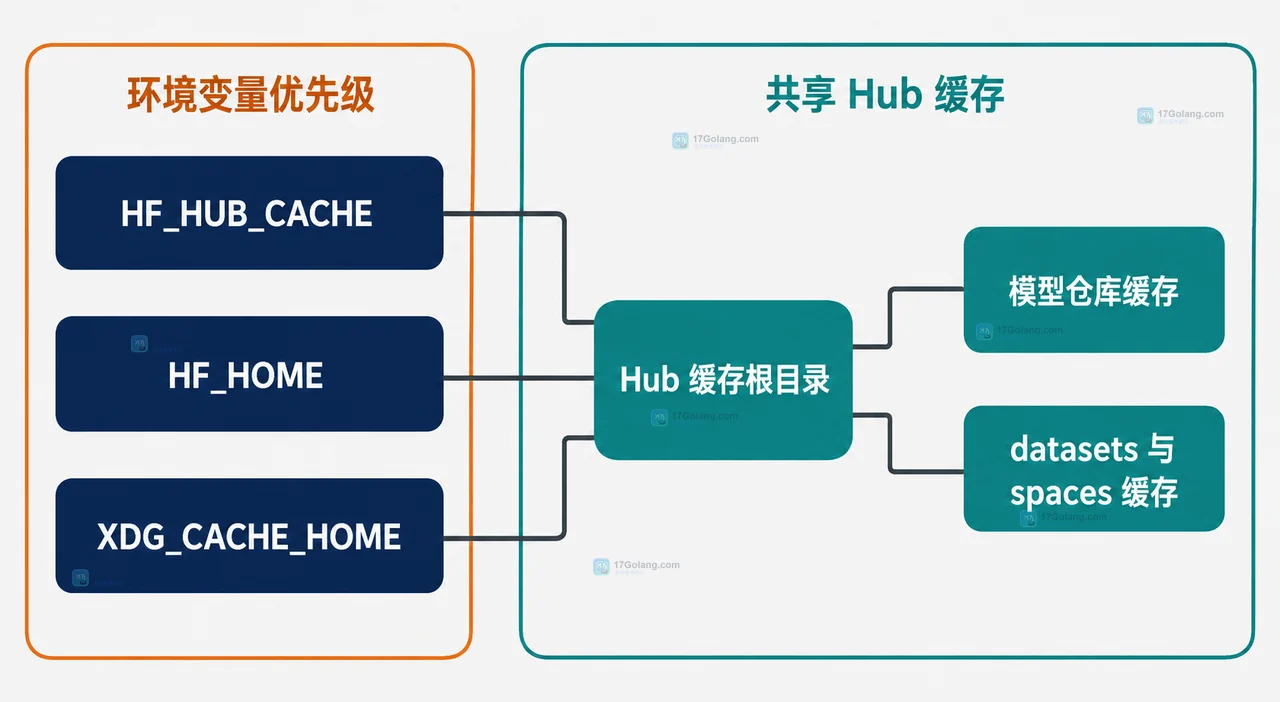 用 HF_HUB_CACHE 或 HF_HOME 把 Hugging Face 模型缓存放到指定磁盘,再用 snapshot_download 提前准备文件,结合 HF_HUB_OFFLINE=1 与 local_files_only=True 完成无网加载。384 收藏
-
 余弦相似度异常,先别急着改阈值。本文用一段最小 Python 配方检查 Embedding 的维度、L2 范数、归一化、点积和向量库距离配置,帮助定位分数漂移的真正环节。383 收藏
-
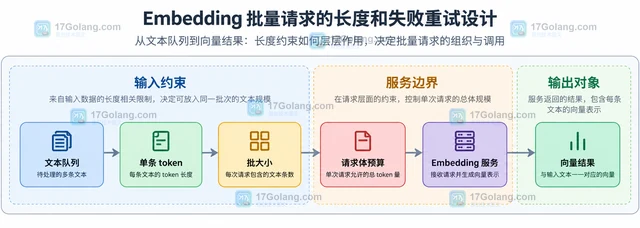 从批大小、单条长度和整批预算三个维度拆分 Embedding 请求,并用有限指数退避处理超时、限流等可恢复失败,避免部分成功后的结果错位。383 收藏