-
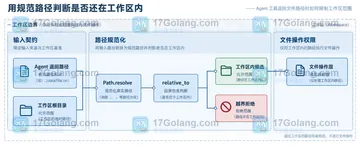
Agent 工具返回的文件路径不能直接信任。本文用工作区根目录、Path.resolve 和 relative_to 组成边界检查,处理绝对路径、目录穿越、符号链接与读写权限分离。
-
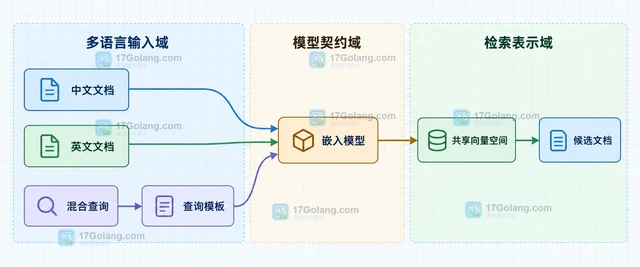
多语言文档混合检索的关键不是盲目更换模型,而是让文档和查询进入同一向量空间,并统一查询模板、输入长度、归一化与相似度计算。本文结合 BGE-M3 和 multilingual-e5-large-instruct 的官方规则,给出跨语言召回与排序漂移的排查清单。
-
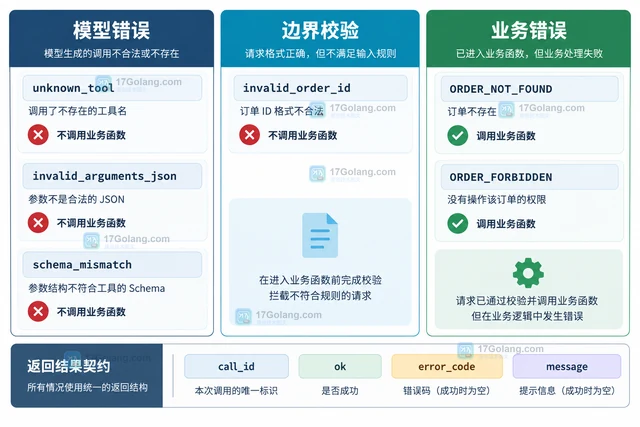
Tool calling 接入业务工具时,先用 JSON Schema 和应用层校验拦截模型参数问题,再把订单不存在、无权限等领域失败转换为稳定的工具结果。本文给出错误分层、Python 示例和重试边界。
-
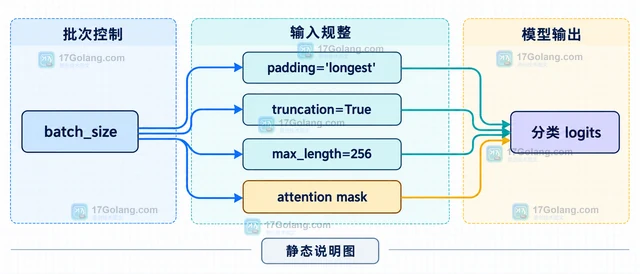
用 Transformers 文本分类 Pipeline 处理批量文本时,分别说明列表、数据集和生成器的入口,padding、truncation、max_length 与 batch_size 的边界,并给出带稳定 ID 的 Python 示例。
-
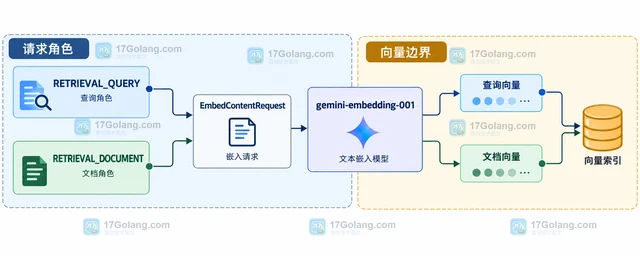
Gemini embeddings 的对称与非对称任务不能混用。本文结合 gemini-embedding-2 的文本任务前缀和 gemini-embedding-001 的 TaskType,说明搜索、语义相似度与向量索引迁移时如何保持查询和文档角色一致。
-
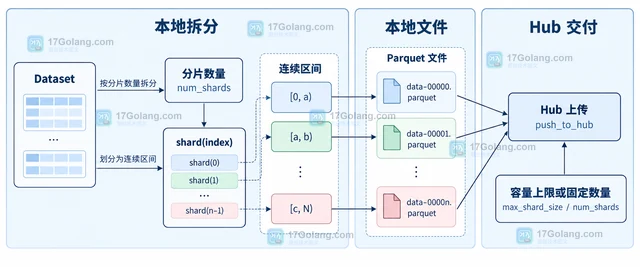
Hugging Face Datasets 里,to_parquet 的 batch_size 主要控制写入批次与内存,不等于输出文件数量;本地固定文件数要用 Dataset.shard,上传 Hub 则可用 max_shard_size 或 num_shards。
-
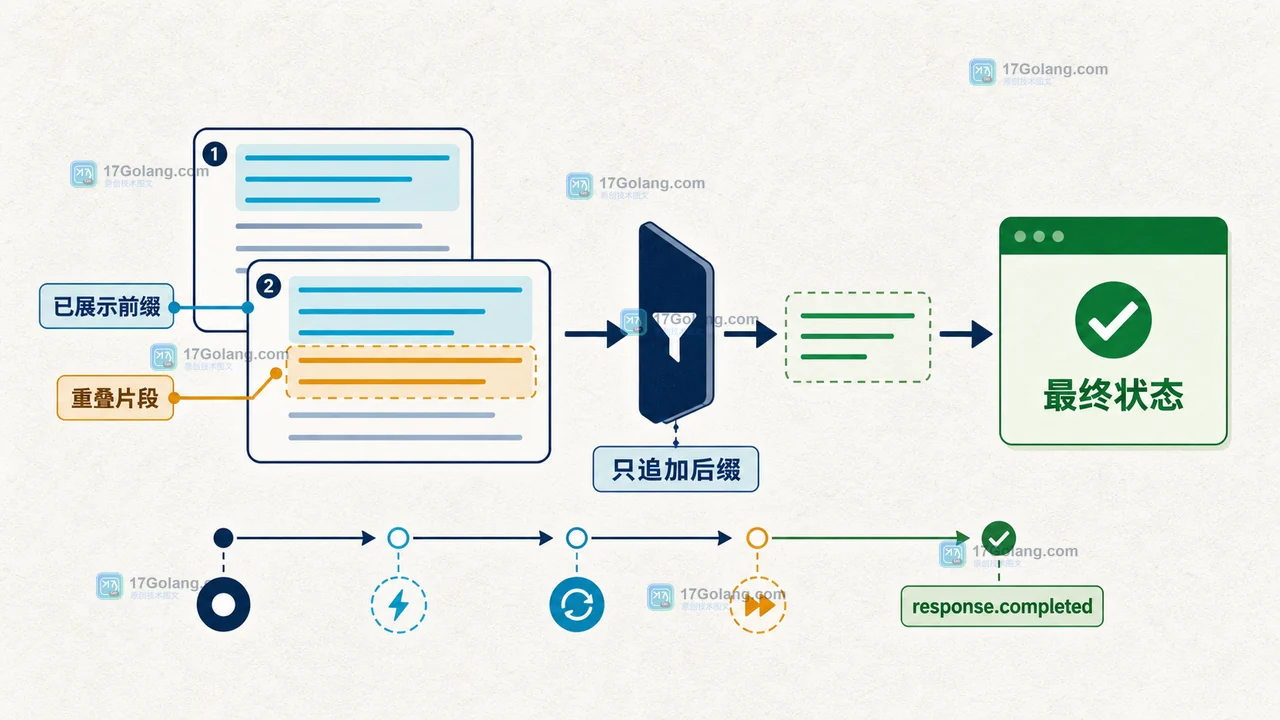
AI 流式输出断线后不要直接重发请求。本文以 OpenAI Responses API 的 SSE 事件为例,说明如何保存 response_id、sequence_number 和已展示片段,重连后消除重复内容,并用最终状态完成一次可审计的收尾。
-
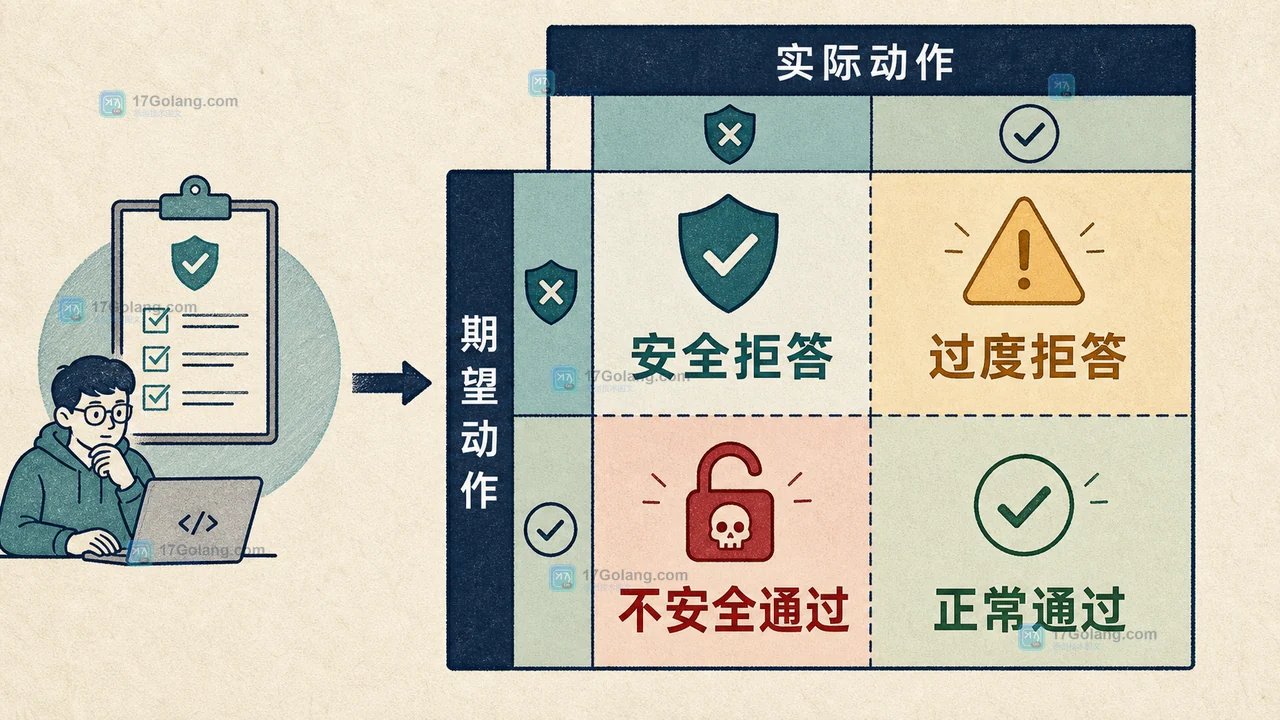
一个 AI 应用把危险请求挡住是安全表现,把正常请求误判为风险则是业务失败。本文用一组可回放的测试样本拆分安全拒答、过度拒答、正常通过和非安全业务错误,说明如何设计标签、计算指标并在上线前复核。
-
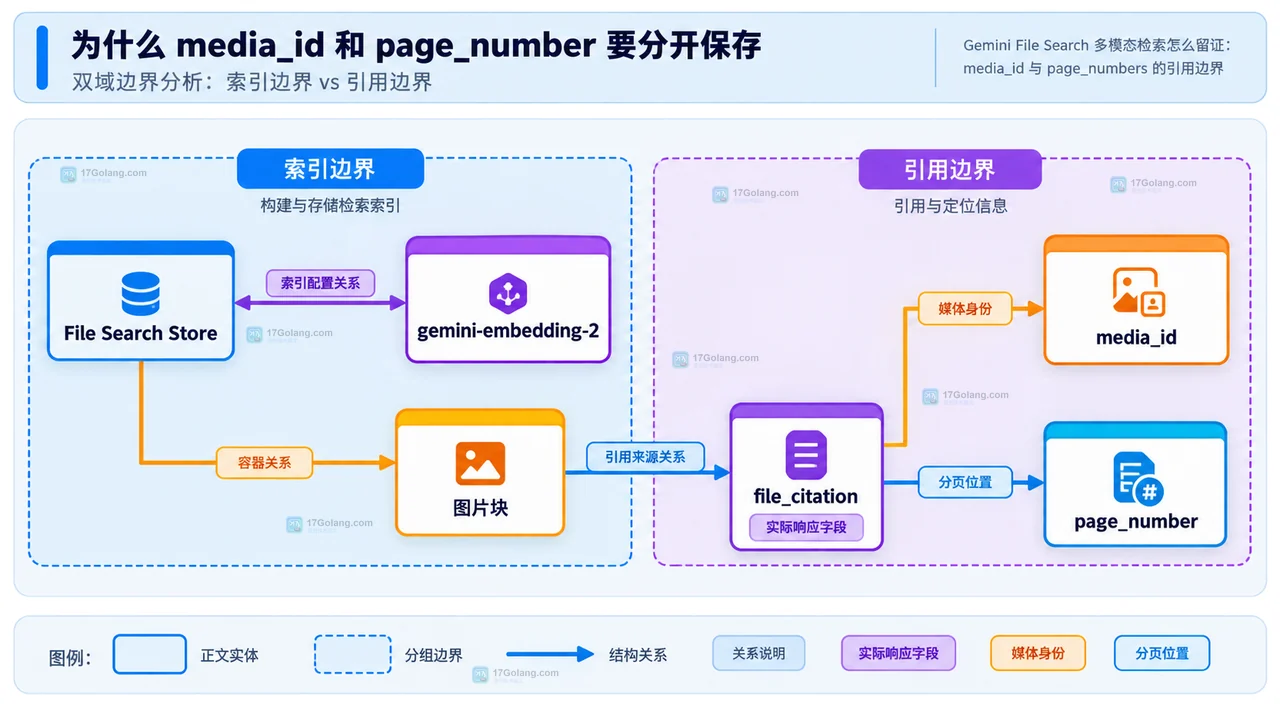
Gemini File Search 支持图片检索后,引用记录不能只保存回答文本。本文拆开 media_id、page_number 与 file_citation 的职责,给出一套可复查的多模态引用记录方法。
-
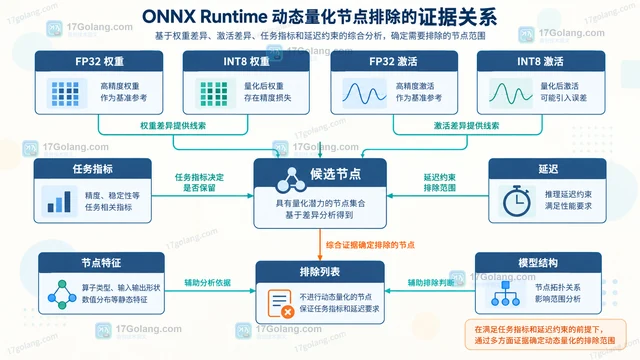
ONNX Runtime 动态量化中的 nodes_to_exclude 应按节点名称精确控制。本文给出节点清单、全量量化基线、差异定位、逐组复测和配置冻结的方法。
-
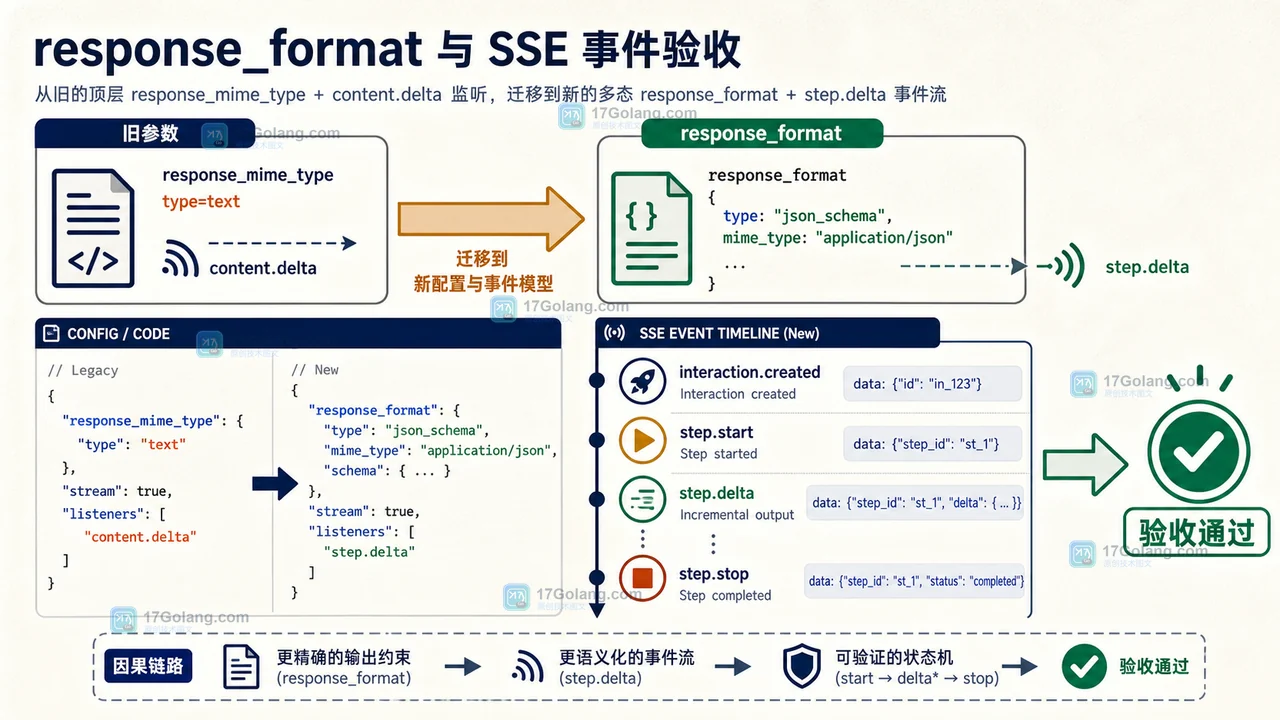
Gemini Interactions API 迁移真正容易漏的是验收:steps 顺序、函数调用、服务端工具、无状态历史、response_format 和 SSE 事件都要分别断言。本文给出 REST 与 SDK 迁移后的 6 类检查。
-
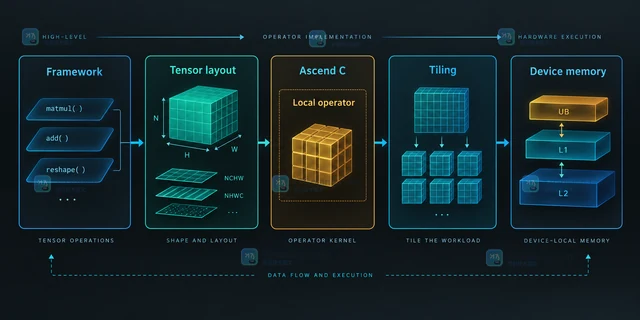
在 DeepSeek 相关 Ascend NPU 项目中,算子负责单卡计算,HCCL/HCOMM 负责跨卡通信,框架后端负责编排。本文按职责边界拆解 Ascend C、通信原语、MoE dispatch/combine 与多卡排查顺序。
-
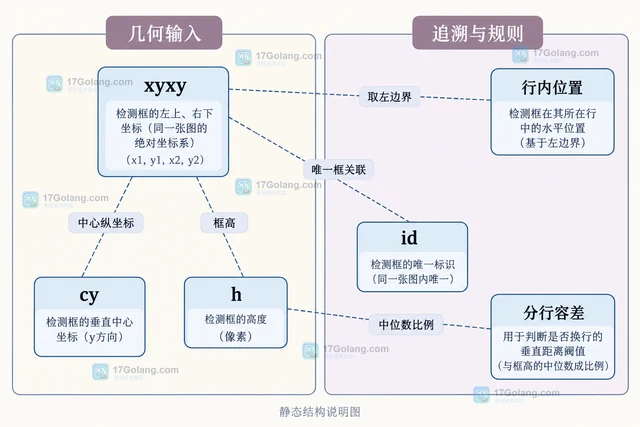
面向单栏横排文本,统一检测框坐标,以固定行锚点分行并在行内按横坐标排序。提供 Python 示例,说明坐标抖动、稳定 ID、多栏与复杂版面的适用边界。
-
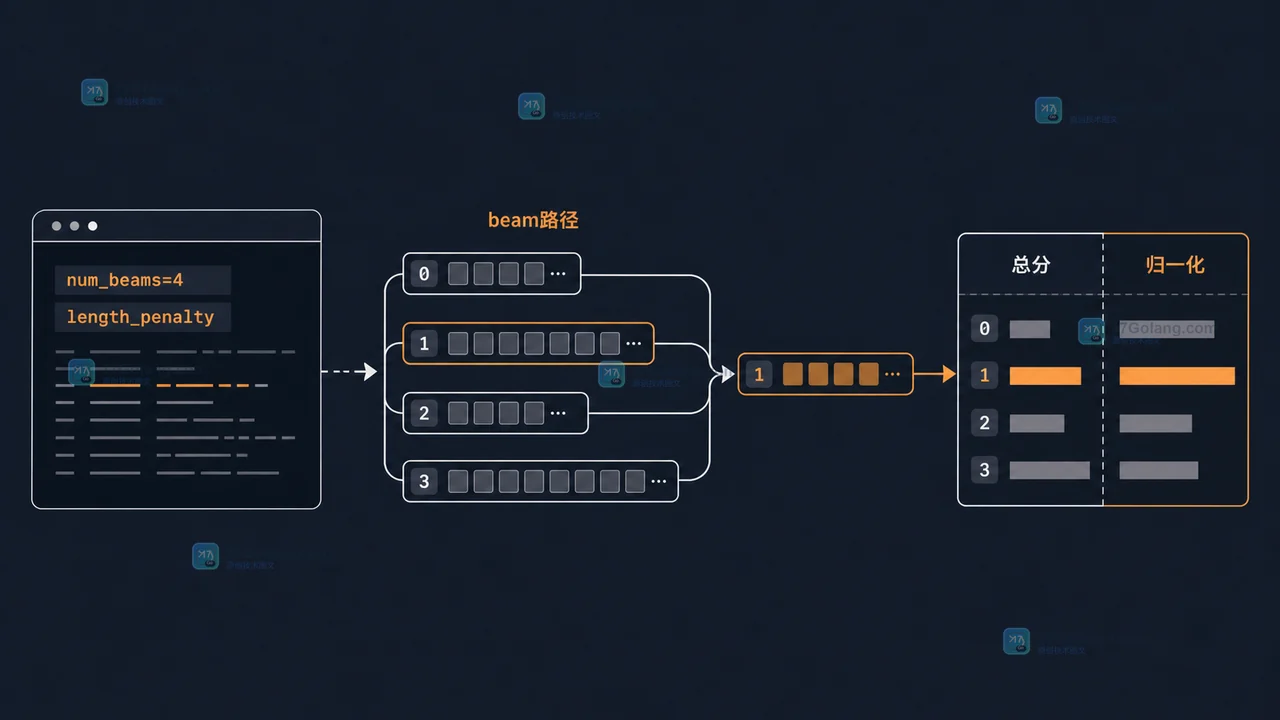
Transformers 的 generate 默认只返回生成序列,不会直接给出每个 token 的分数。本文用 return_dict_in_generate、output_scores 和 compute_transition_scores 还原逐 token 对数概率,并说明 decoder-only 输入长度、beam search 和 length_penalty 的验收边界。
-
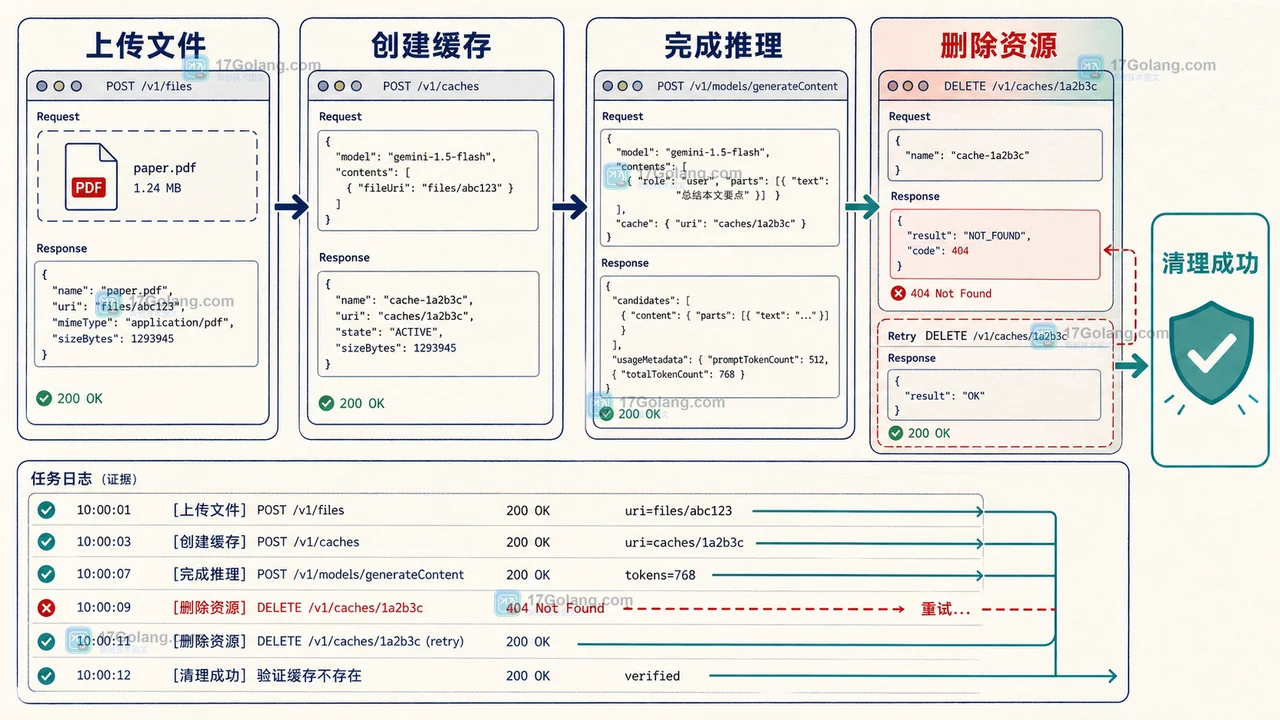
Gemini Developer API 的零数据留存不是只设置一个 store=false:Interactions、File API、显式缓存、隐式缓存和 Live API 的保留边界不同。本文用一张核对表和最小请求示例说明如何逐项关闭或清理状态。
