
人工智能技术文章
-
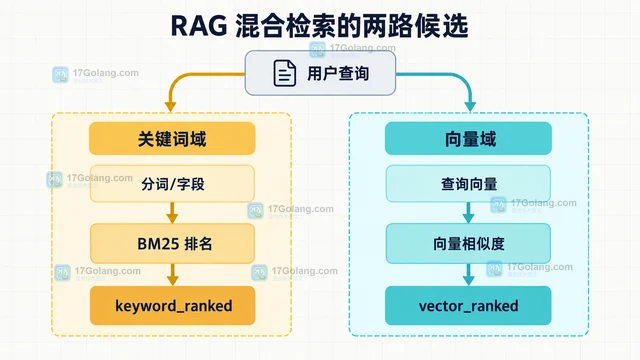 从零实现一个 RRF 混合检索融合器,把关键词与向量排名统一去重、计分,并输出可直接交给 RAG 的候选文档。373 收藏
-
科技周边 · 人工智能 | 1星期前 | python · 数据处理 · 人工智能 · AI Hugging Face Datasets select_columns remove_columns DatasetDict 数据集字段
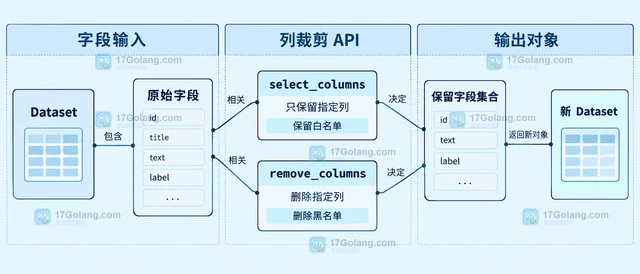 Hugging Face Datasets 按列处理时,先区分 select_columns 与 remove_columns,再确认 Dataset 和 DatasetDict 的作用范围,并说明 map 转换、缺列检查和新对象赋值的常见误区。373 收藏
-
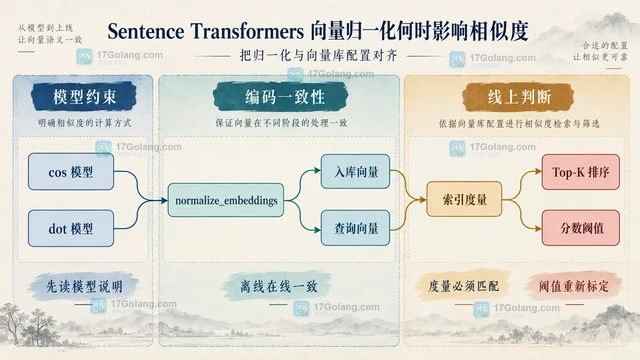 Sentence Transformers 的 L2 归一化不会改变余弦方向,但会改变原始点积和部分距离。本文用对照实验说明何时开启 normalize_embeddings。372 收藏
-
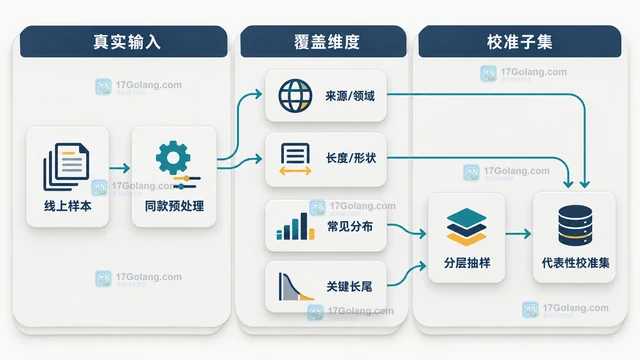 静态量化的校准集不能只随机抽训练样本。本文从线上预处理、来源领域、长度形状、常见分布和关键长尾建立覆盖矩阵,并说明如何用独立评估与漂移监控判断校准是否可靠。372 收藏
-
 ONNX Runtime 通过 SessionOptions 的图优化级别和 optimized_model_filepath 在创建推理会话时保存优化后的模型。本文说明 Python 写法、ONNX 与 ORT 格式边界,以及文件未生成时的排查方向。372 收藏
-
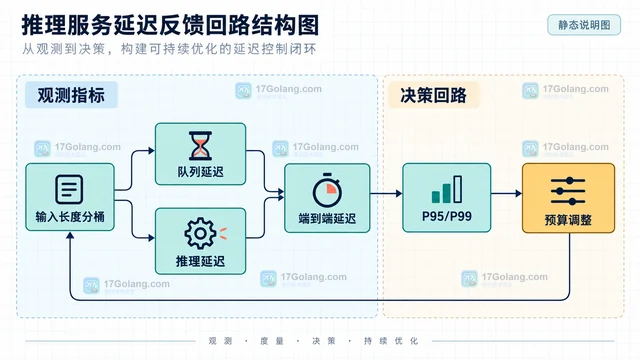 把推理请求的输入 token、输出上限、排队等待和生成吞吐拆开计算,再配合 TGI 的 token 与并发参数设置可解释的超时预算。371 收藏
-
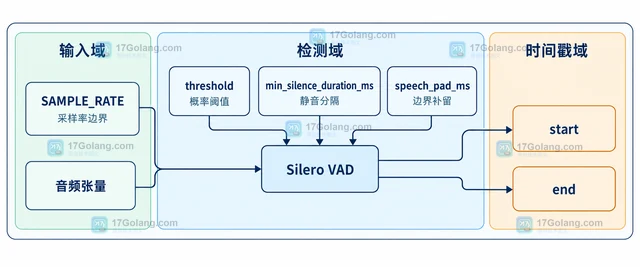 介绍语音转写前用 VAD 检测语音区间的方法,说明采样率、阈值、静音时长、边界 padding 和原始时间偏移如何配合,避免切掉词头词尾或让字幕时间轴失真。371 收藏
-
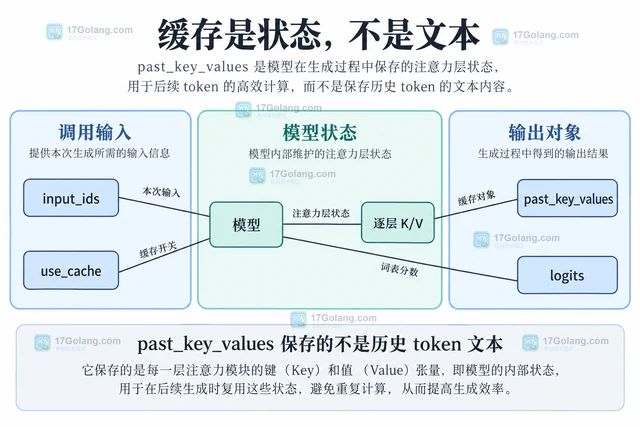 Transformers 的 past_key_values 保存已处理上下文的逐层 K/V,use_cache 控制缓存输出。本文用 GPT-2 原创示例解释新增 token、完整掩码与缓存长度的配合,并说明对象复用和内存边界。370 收藏
-
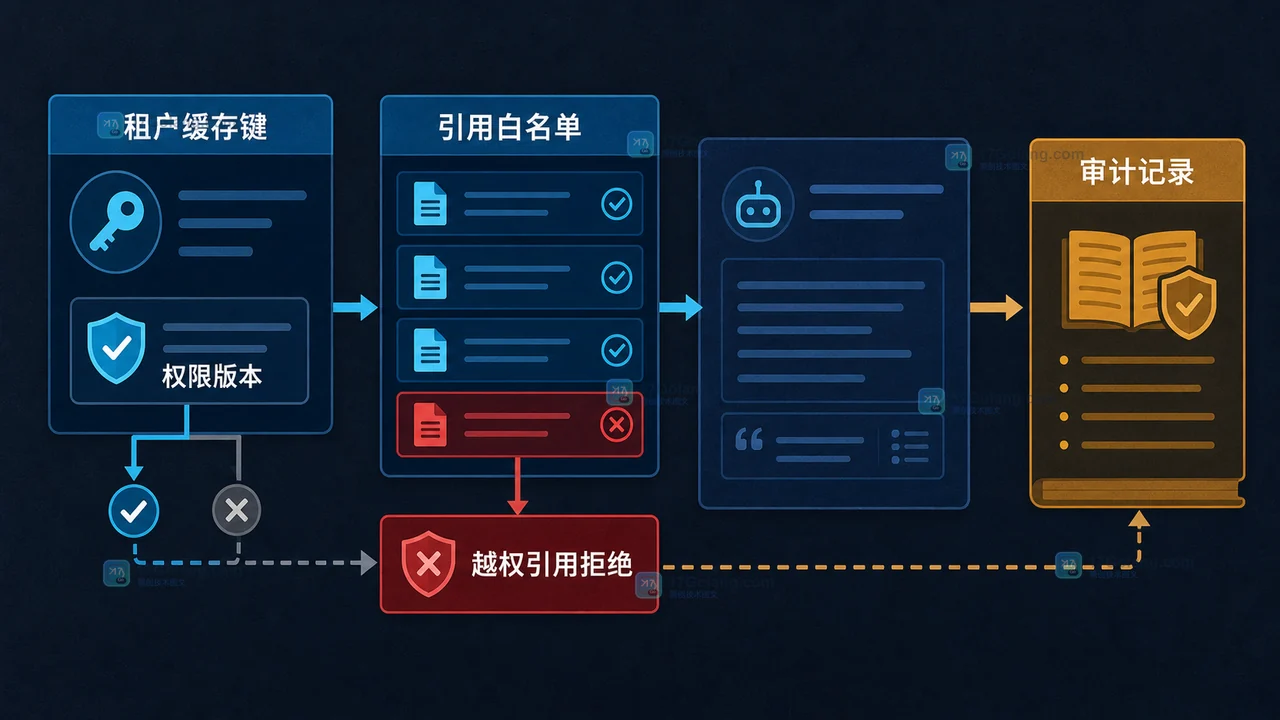 多租户 AI 知识库最危险的故障不是检索变慢,而是把 A 租户的片段、缓存或引用带给 B 租户。本文从检索权限、缓存键、引用回显和审计证据四条线,拆解一套可验证的隔离方案。369 收藏
-
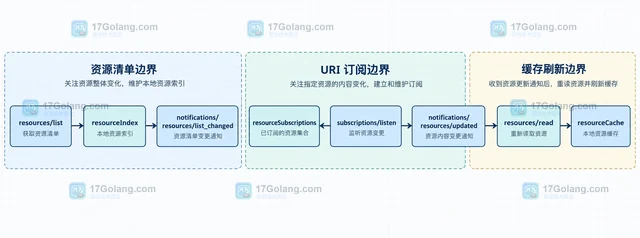 讲清 MCP 资源清单变更与单资源更新通知的区别,演示当前 subscriptions/listen 的 URI 订阅、旧协议兼容、缓存刷新和断线边界。369 收藏
-
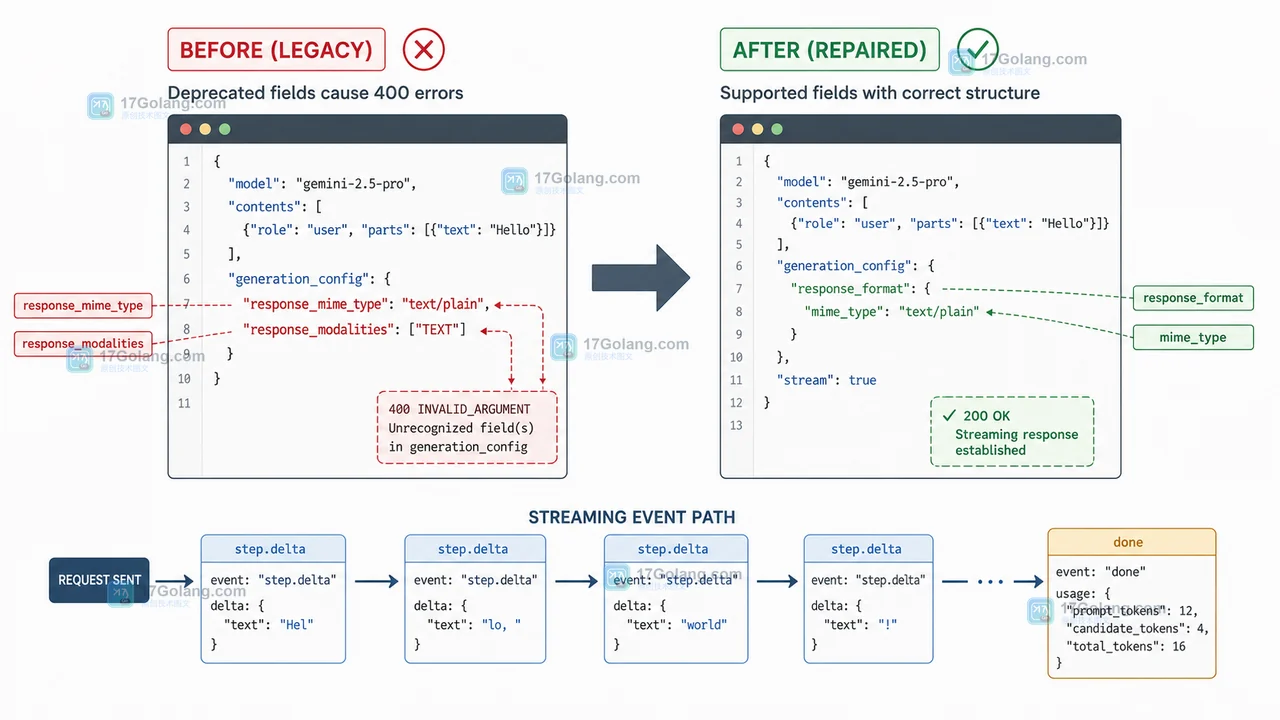 Gemini Interactions API 的 2026 schema 迁移不只是把 outputs 改成 steps,还涉及 response_format、函数调用、工具事件、无状态历史和 SSE 监听。本文按 REST 与 SDK 两条路径给出兼容改法和验收清单。367 收藏
-
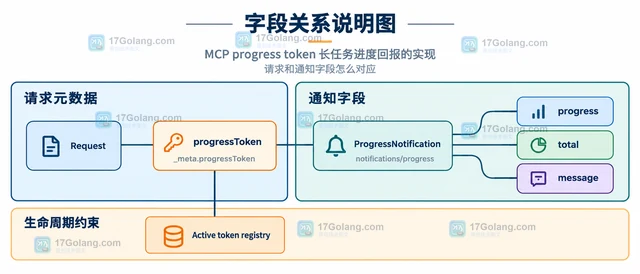 MCP 长任务进度回报依赖请求中的 progressToken 与 notifications/progress 通知。本文用 TypeScript 示例说明 token 关联、progress 递增、total 缺失、最终结果分离和取消资源边界。367 收藏
-
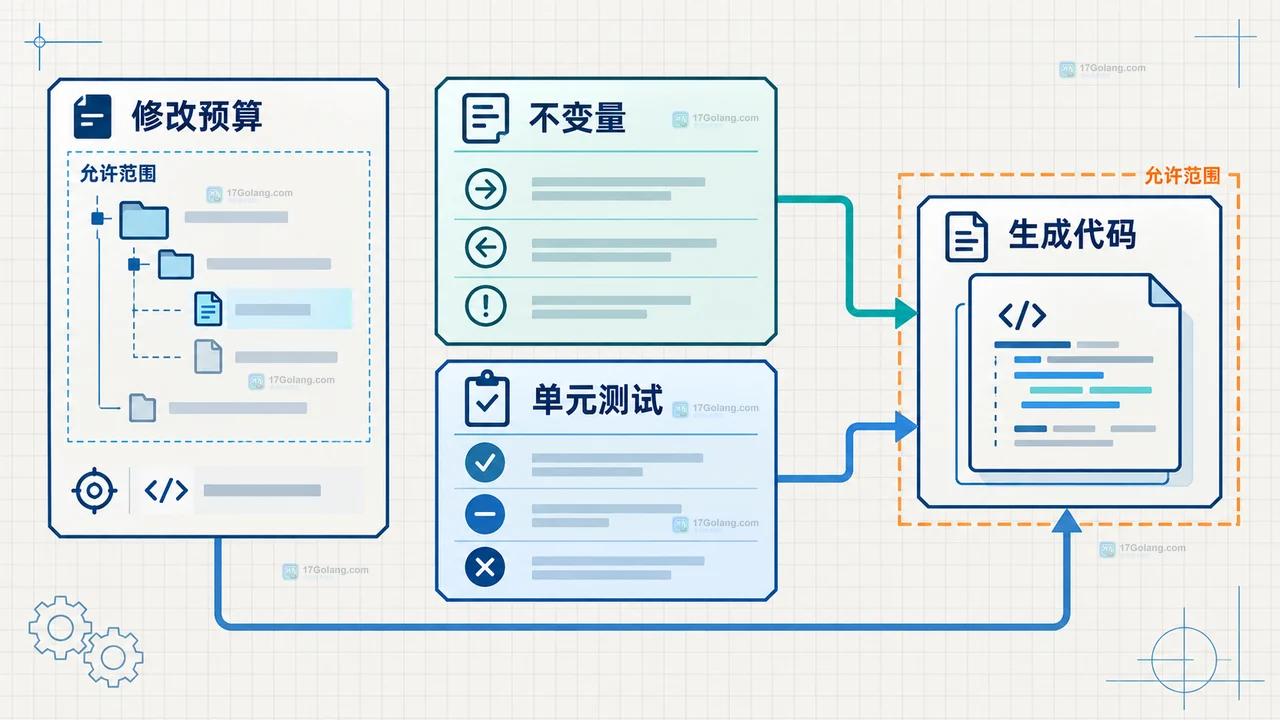 AI 生成代码最容易失控的地方不是语法,而是修改范围。本文用单元测试、修改预算和 git diff 双重门禁,拆解如何让一次生成式改动保持可验收、可回退。366 收藏
-
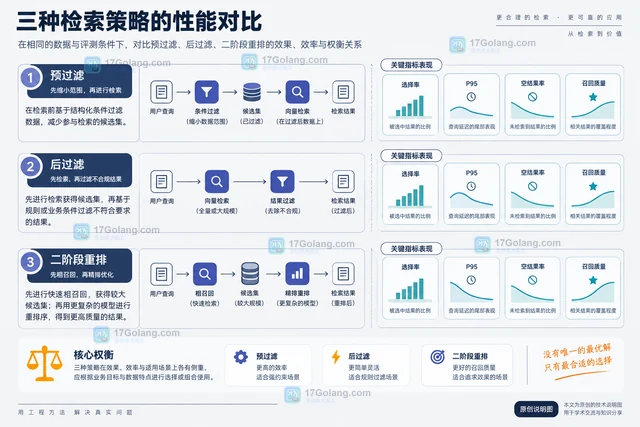 向量检索不要先取全局 top_k 再丢弃不合格结果。本文以 Redis Search 为例,把 tenant、状态和时间等元数据作为预过滤条件放到 KNN 前,并用选择率、P95 延迟和召回质量确定参数边界。365 收藏
-
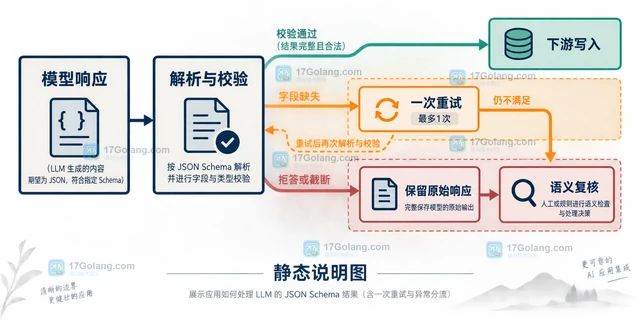 LLM输出能解析不代表字段完整。本文从JSON Schema最小契约、响应状态归一化、字段缺失有限重试和上线观测四个方面,给出结构化输出的处理方案。364 收藏