
人工智能技术文章
-
 用 Claude Prompt Caching 降低长上下文请求的延迟和成本时,要把静态前缀、动态尾部、TTL 与 usage 里的 cache read/write 分开验收。363 收藏
-
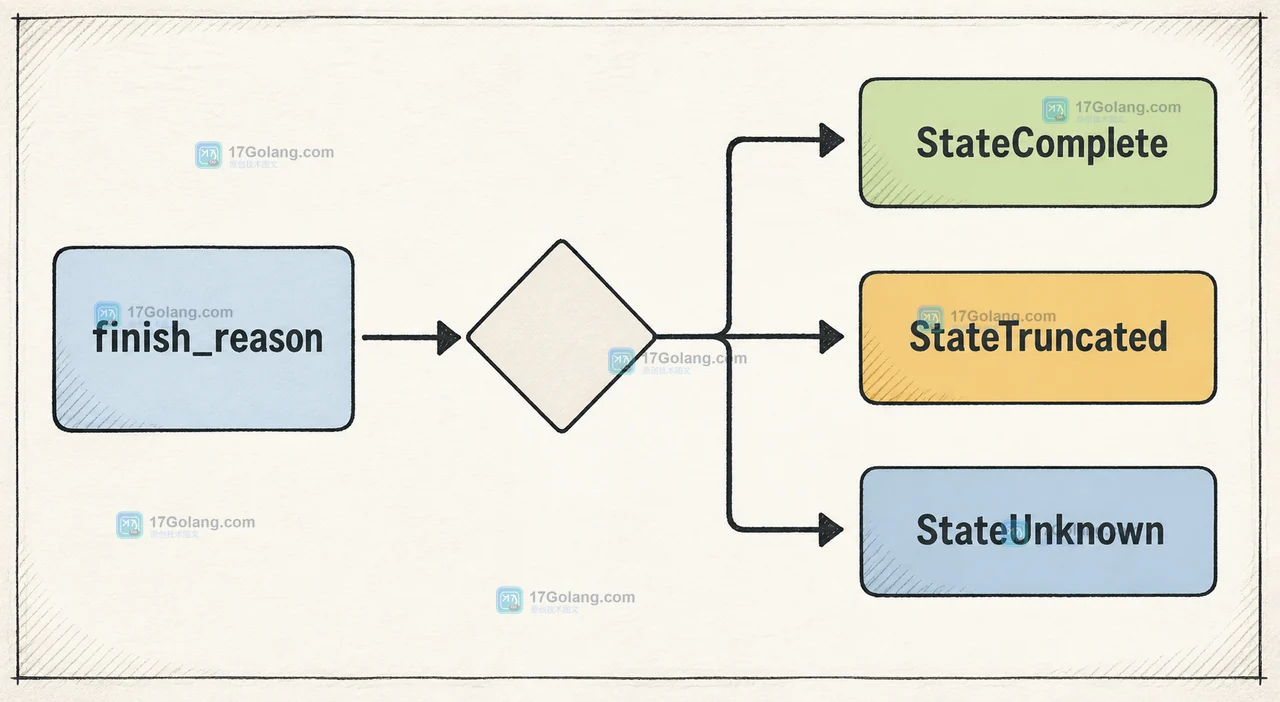 AI 接口返回结构化结果时,空对象不一定代表没有数据。本文用 finish_reason、拒答字段和 JSON Schema 校验拆开拒答、截断、合法空结果三种状态,并给出可落地的用户提示策略。363 收藏
-
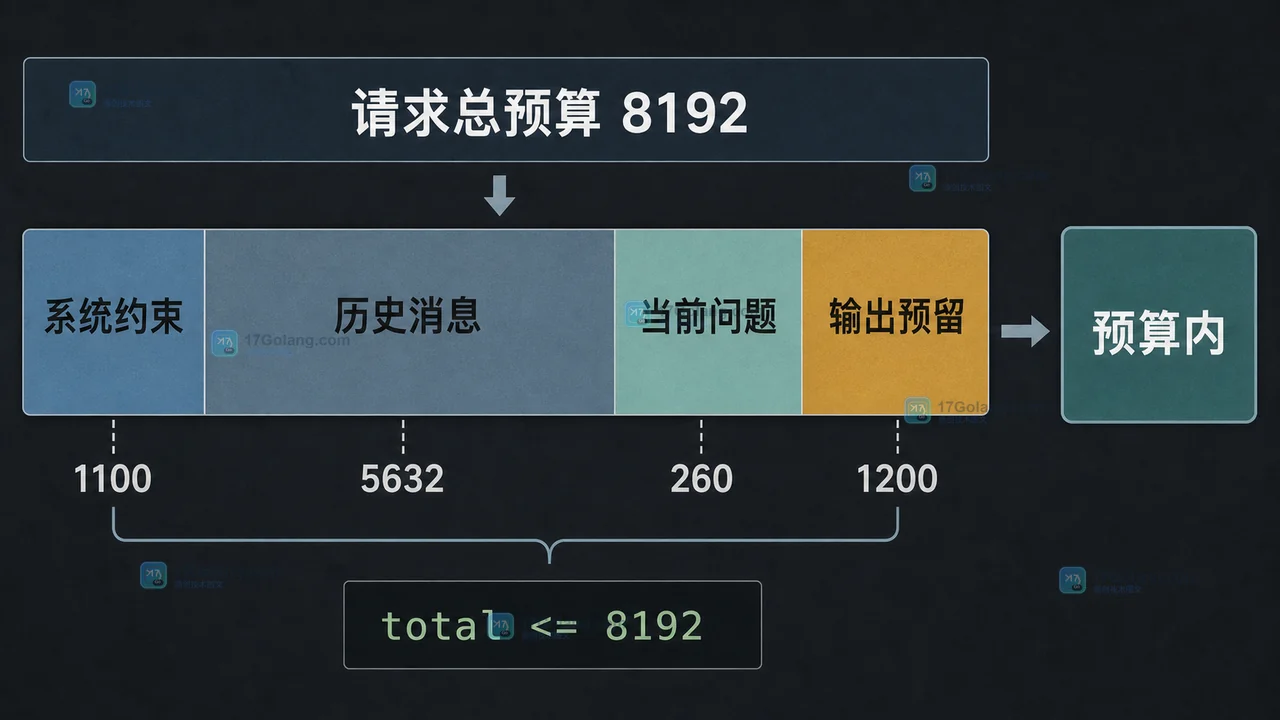 多轮对话一旦超过模型上下文窗口,常见表现不是单纯报错,还包括旧约束丢失、工具参数变长和响应质量波动。本文用一个可复现的 token 预算实验,拆解消息裁剪、摘要保留与最近轮次保护的组合策略。361 收藏
-
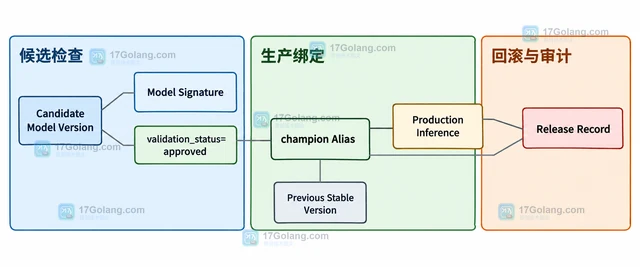 MLflow Model Alias 可以把生产代码从固定模型版本号解耦出来。本文用 champion 别名串起模型注册、加载、发布切换和回滚边界,说明 Alias URI 的写法以及不能忽略的版本验证与审计记录。360 收藏
-
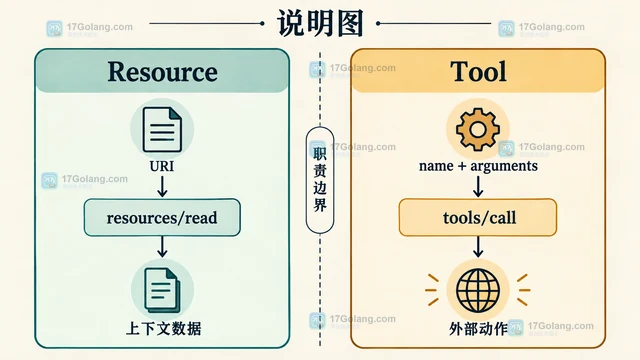 MCP 中 Resource 负责按 URI 提供可读取的上下文,Tool 负责按名称和参数执行能力。本文从发现消息、调用边界、权限审计和错误分层说明两者的实现方法。359 收藏
-
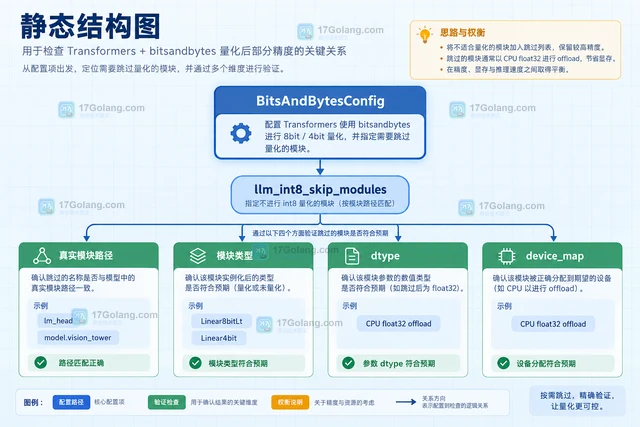 讲清 Transformers 使用 bitsandbytes 进行 8-bit/4-bit 量化时,如何用 llm_int8_skip_modules 保留指定模块,并区分跳过量化、dtype 与 CPU float32 offload。359 收藏
-
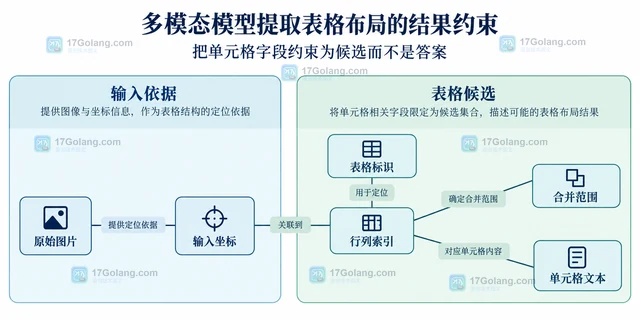 多模态模型提取表格布局需固定行列索引、合并范围与坐标含义,通过字段约束暴露结构冲突,并保留不确定内容与人工复核记录,避免把格式正确当成识别正确。359 收藏
-
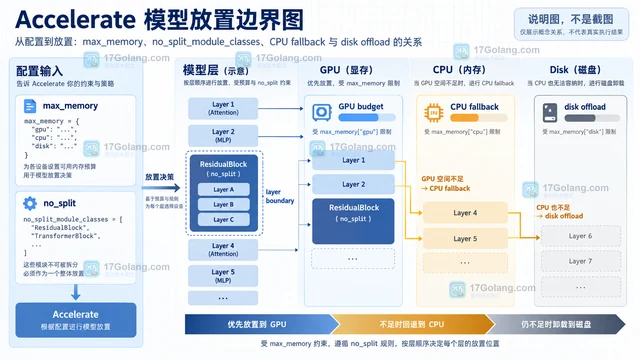 本文说明 Accelerate 如何用 device_map=auto 将大模型按显存分配到多块 GPU,并讲清 max_memory、不可拆分层、CPU 与磁盘回退以及多卡推理的性能边界。358 收藏
-
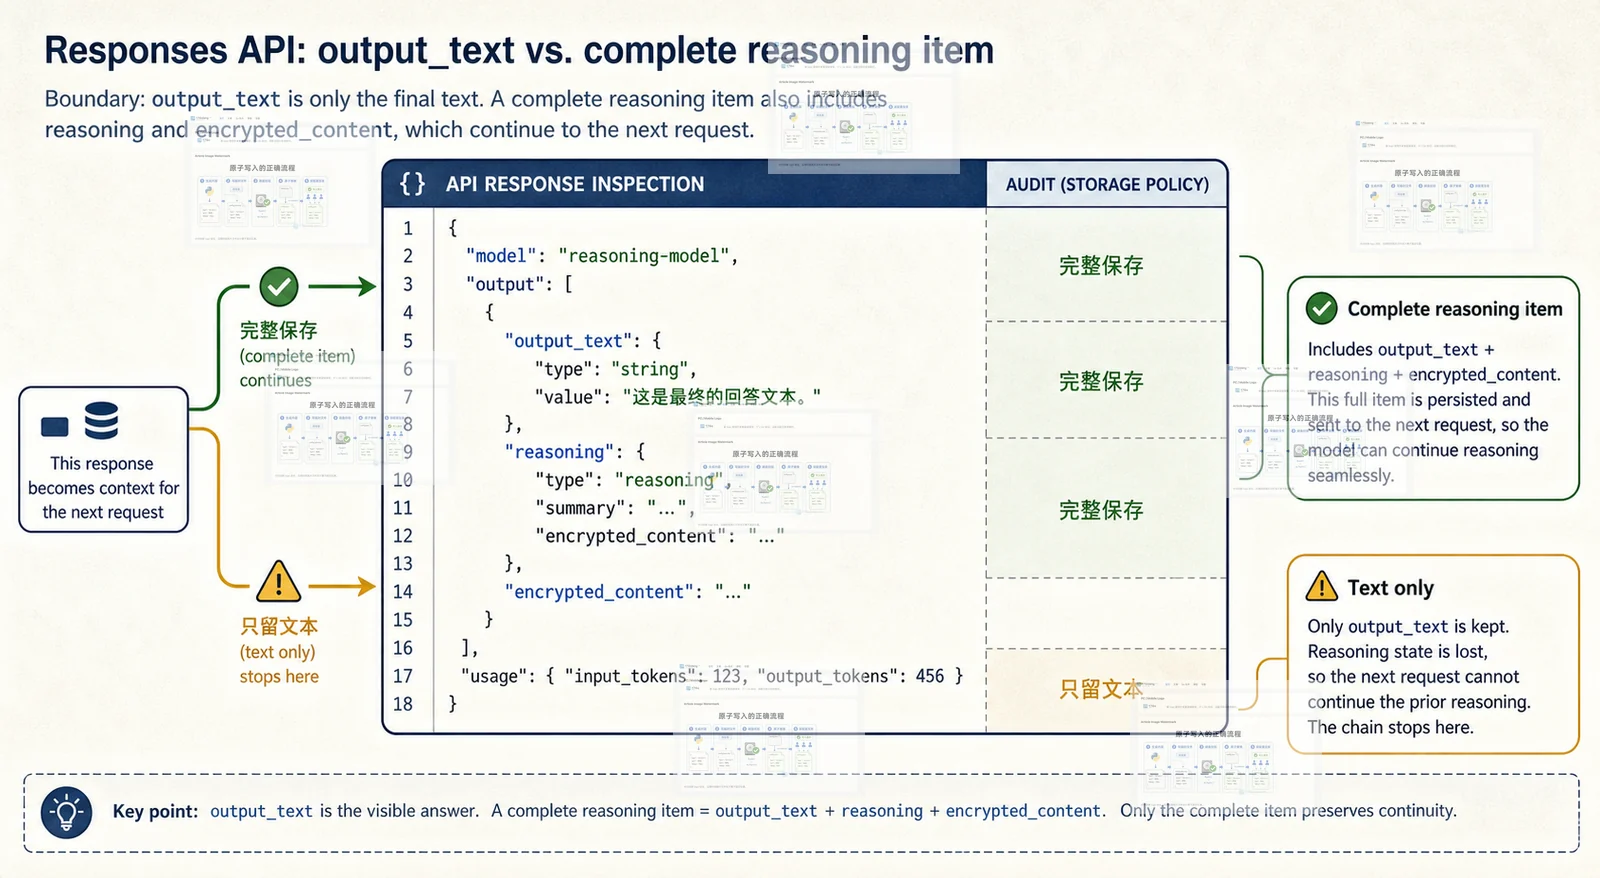 OpenAI Responses API 的推理项不是普通文本,手动管理多轮上下文时要保留完整 reasoning item。本文拆解 reasoning.encrypted_content、include 参数和函数调用续接的验收边界,避免第二轮请求丢上下文。357 收藏
-
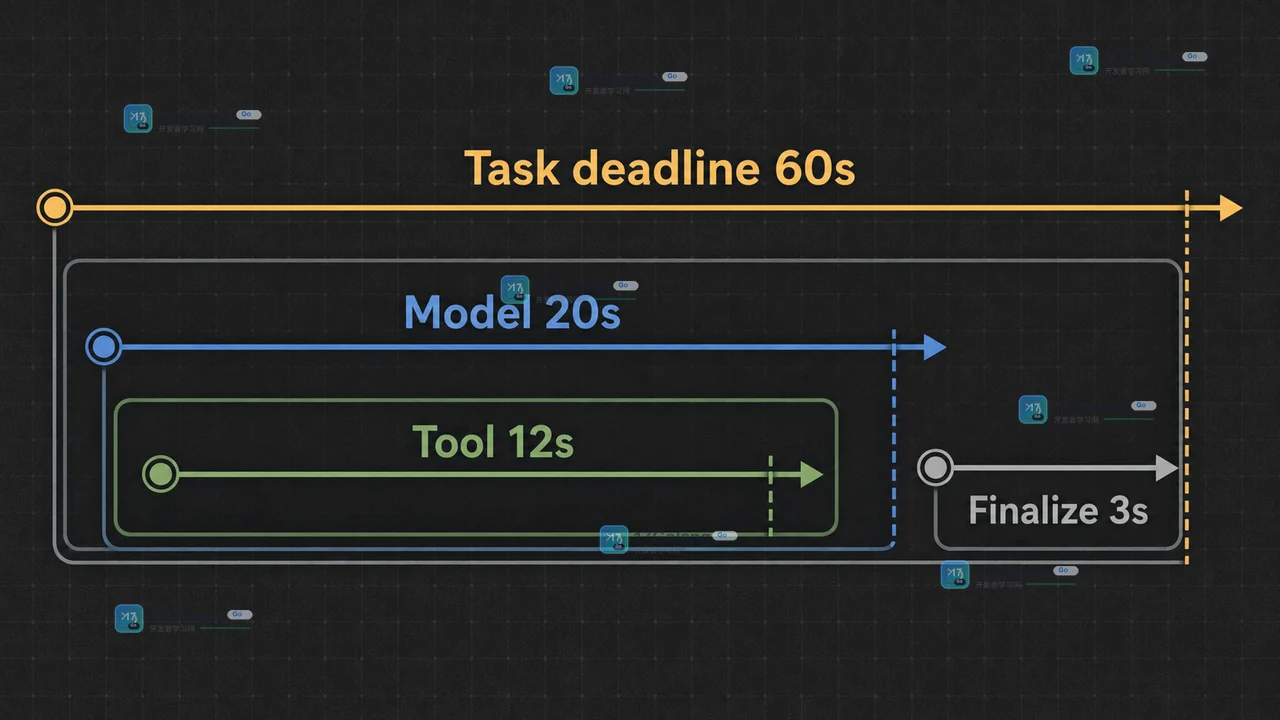 AI Agent 的超时不能只设一个总秒数。把模型等待、工具调用和整条任务预算分开,才能区分慢在哪里、及时停止无效工作,并在重试与回退时保留可核对的状态。357 收藏
-
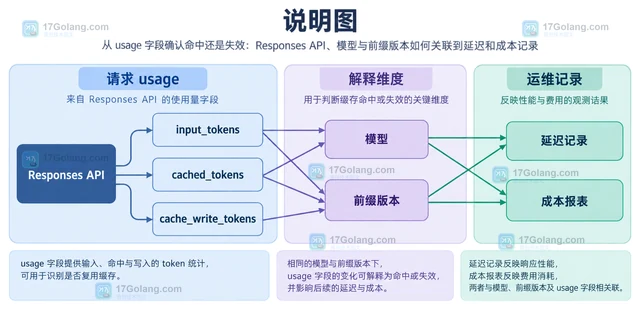 围绕 AI 提示词缓存的稳定前缀组织请求,说明固定指令、工具 schema 与动态问题的排列方法,并用 cached_tokens、cache_write_tokens 和版本化回滚定位缓存失效。357 收藏
-
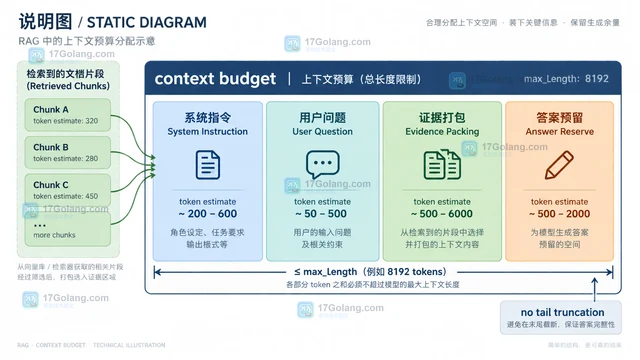 RAG 检索结果不要直接按 top_k 全量送入模型。本文用文档身份、规范化文本和语义多样性三层策略去重,再按系统指令、问题、证据与回答余量分配上下文预算,给出可迁移的 Python 实现与参数调优指标。357 收藏
-
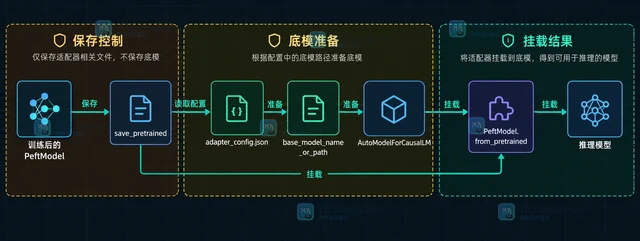 用 Hugging Face PEFT 训练 LoRA 后,怎样只保存 adapter_model.safetensors 与 adapter_config.json,而不把底模权重打进交付包?本文按资产、风险路径、保存加载代码和文件审计说明适配器交付边界。357 收藏
-
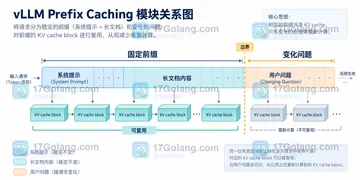 vLLM Prefix Caching 适合重复长前缀、长文档和多轮会话,但收益集中在 prefill。本文从前缀稳定性、开启配置、测量方法、缓存容量和多租户隔离几个方面判断是否值得使用。356 收藏
-
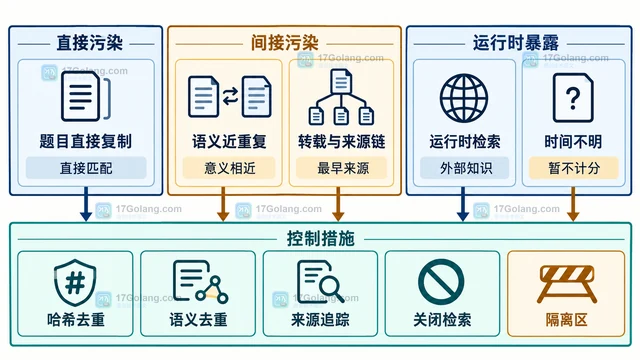 时间切分不能证明评测集绝对无污染,但能用训练截止时间、样本最早来源时间、冻结时间和评测时间建立可审计边界。本文给出三桶切分、重复检测、检索隔离、分窗报告与滚动换题方案。356 收藏