
人工智能技术文章
-
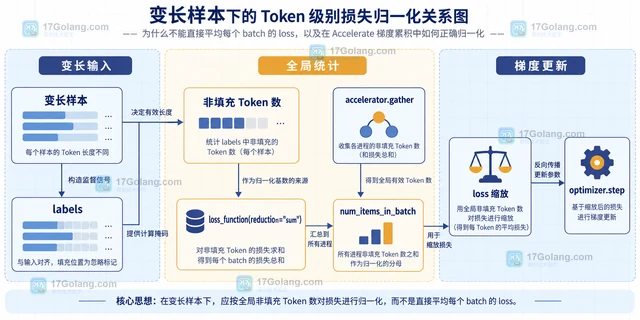 显存有限时,Accelerate 可以用 gradient_accumulation_steps 把多个 micro-batch 合成一次参数更新。本文说明 Accelerator、accumulate(model)、scheduler 与变长 token loss 归一化的配置边界。356 收藏
-
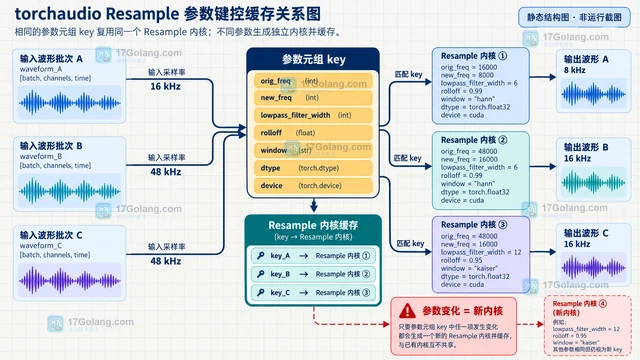 固定采样率的音频批处理不必反复生成重采样卷积核。本文说明 torchaudio.transforms.Resample 与 functional.resample 的缓存边界,并给出按采样率、滤波参数、dtype 和设备分层复用的实现方式。356 收藏
-
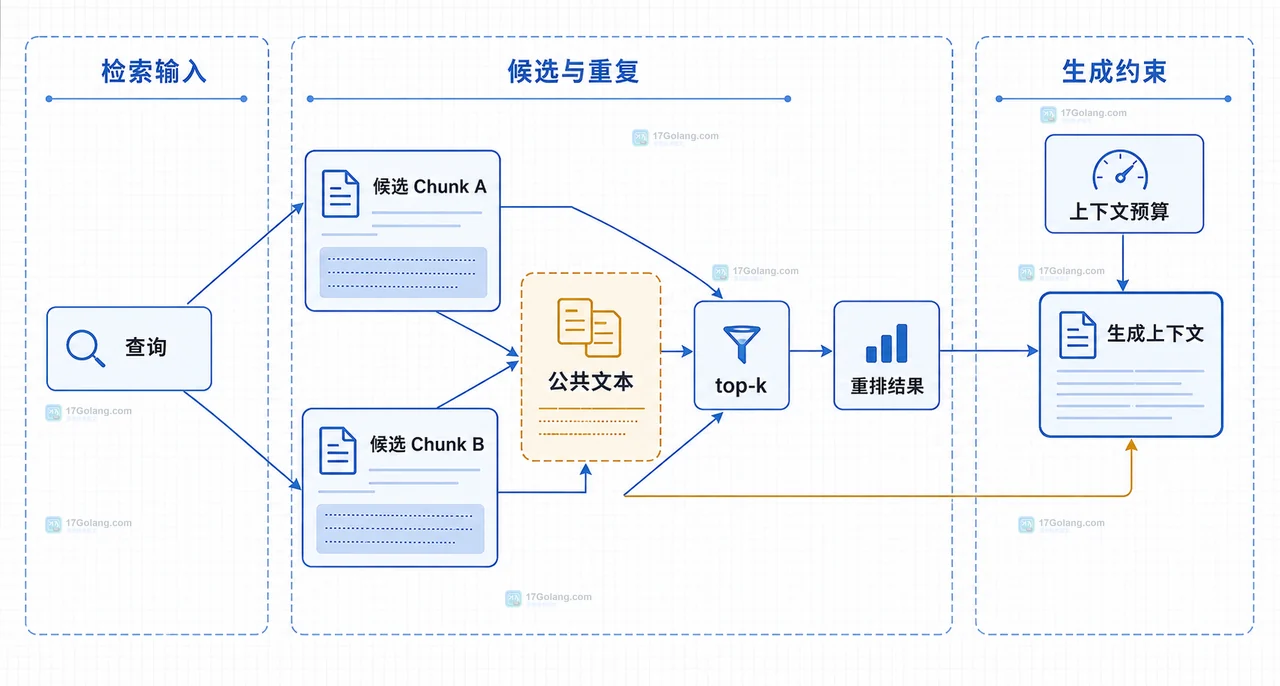 RAG overlap 过高时,不要只看切片数量;应结合 chunk size 的相对比例、召回候选的公共文本和最终上下文长度判断,再用固定问题集对照调参。355 收藏
-
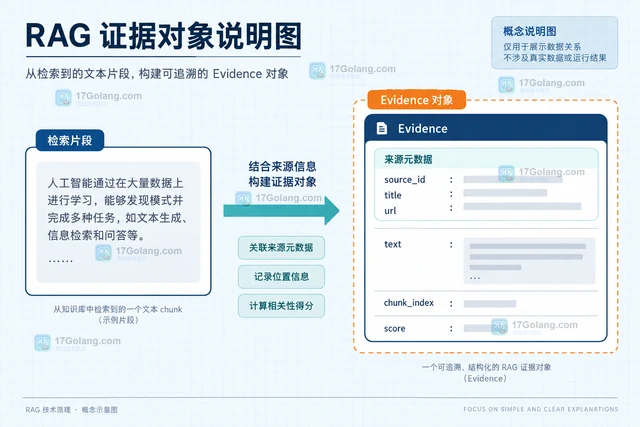 RAG 应用不要只返回一串链接。本文用 source_id、答案段落和引用集合建立可校验的对齐关系,并给出无证据、多来源冲突与前端展示的处理方式。354 收藏
-
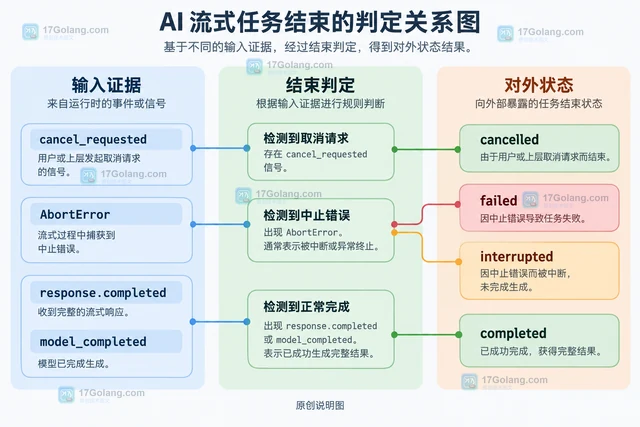 AI 应用的流式请求不能用“连接结束”判断模型完成。本文从一次取消被记成成功的故障入手,拆分 AbortSignal、SSE 完成事件和异常断开,给出可落地的状态字段、前端判定代码与日志边界。354 收藏
-
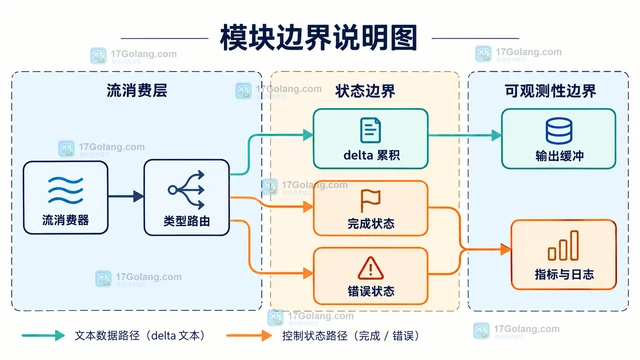 OpenAI API 的 Responses 流由带类型的语义事件组成。本文说明如何只提取 response.output_text.delta 文本增量,并分别处理 response.completed 与 error,避免控制事件混入回答。352 收藏
-
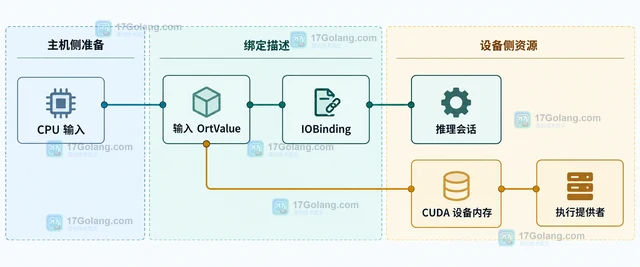 ONNX Runtime 普通 run 路径可能让输入输出在 CPU 与加速设备之间来回搬运。本文以 Python IOBinding 为主线,说明如何准备设备 OrtValue、预分配固定形状输出、调用 run_with_iobinding,并区分动态输出、CPU 回读和内存生命周期边界。352 收藏
-
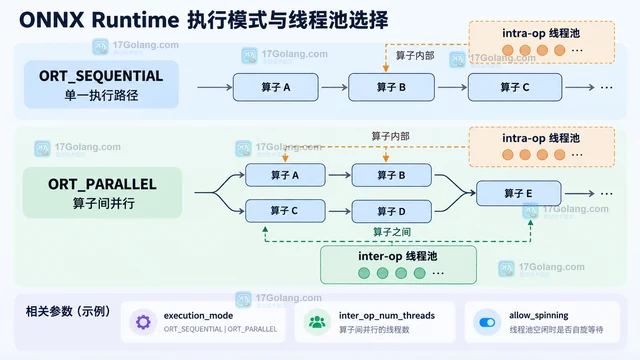 ONNX Runtime 的线程数不是只改一个参数:intra_op_num_threads 控制算子内部并行,inter_op_num_threads 只在 ORT_PARALLEL 下控制算子之间并行。本文用 Python SessionOptions 说明两类线程池、等待策略和多会话场景的配置边界。351 收藏
-
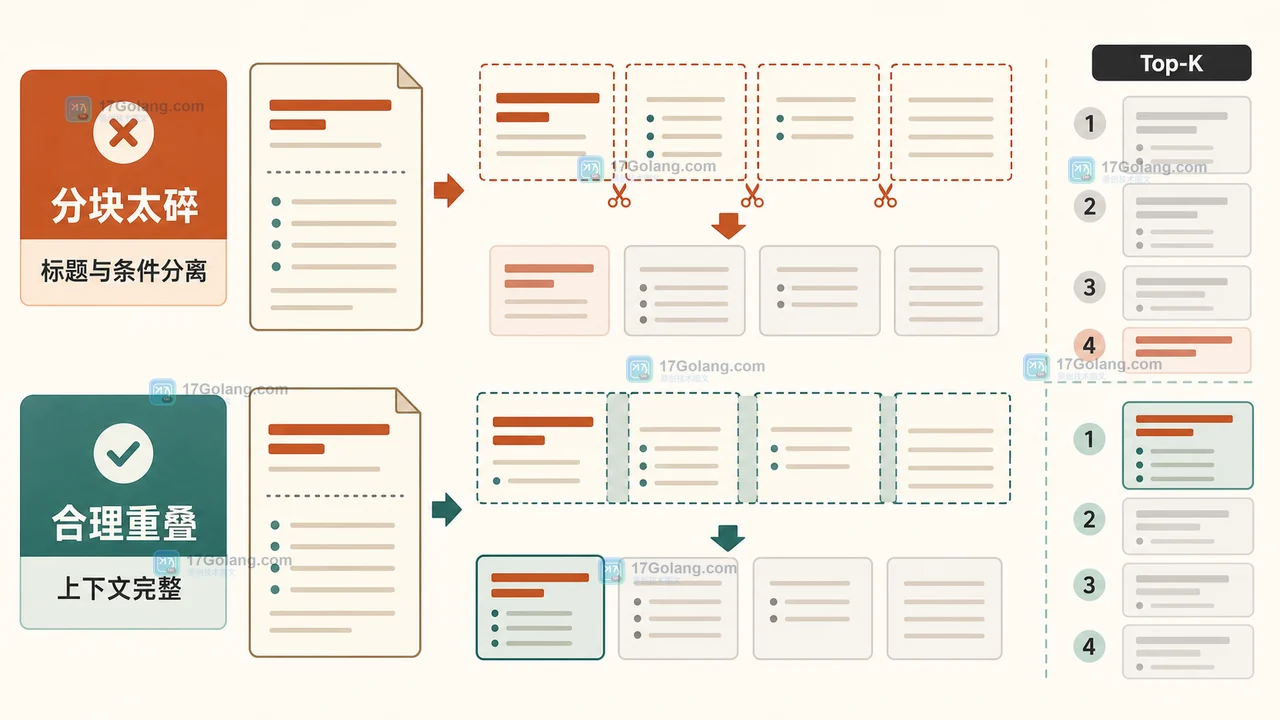 RAG 明明已经写入知识库,回答却像没有检索到内容?从查询改写、文本分块、相似度阈值和召回日志四个位置建立一条可验证的排查路径。350 收藏
-
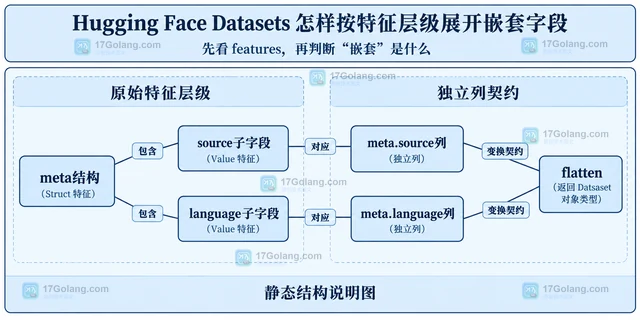 Hugging Face Datasets可用flatten把struct子字段展开成带层级前缀的独立列。本文通过原创样本区分Dataset与Features展开、列表拆行和索引整理,并说明下游列名契约。350 收藏
-
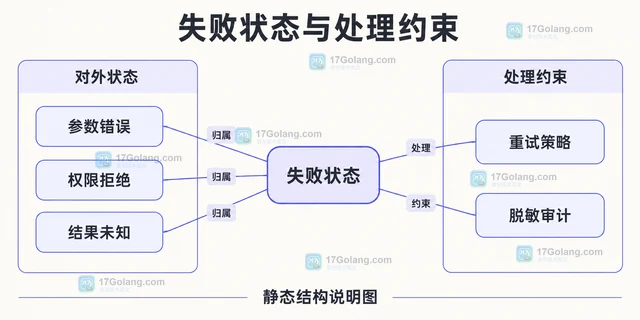 AI Agent工具调用不能把schema通过当作授权通过。本文以工单查询的假设故障区分输入契约、业务约束、可信身份与失败返回,说明权限拒绝、重试和结果未知的处理边界。349 收藏
-
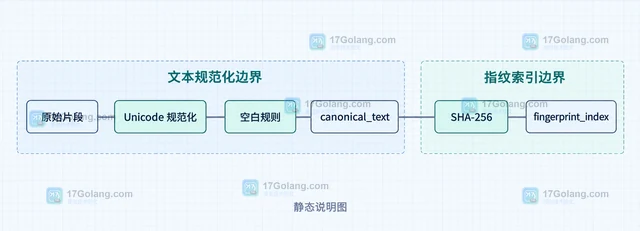 RAG 入库前先做内容指纹,可以在向量化之前拦截完全重复片段,减少重复检索和上下文浪费。本文用 Python 演示文本规范化、SHA-256 指纹、元数据合并,以及近重复候选的处理边界。349 收藏
-
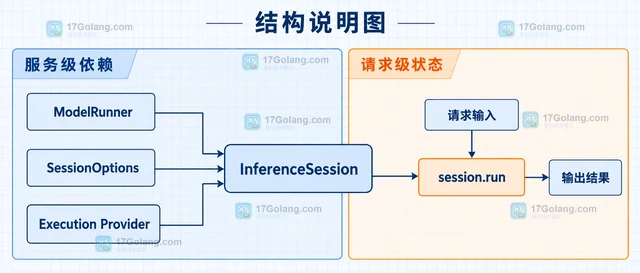 ONNX Runtime 服务中应按模型和会话配置创建一次 InferenceSession,再复用 session.run;并发数仍需按执行提供程序、输入状态和资源预算限制。本文用架构模式说明单会话、信号量、请求级输入与 DirectML 边界。349 收藏
-
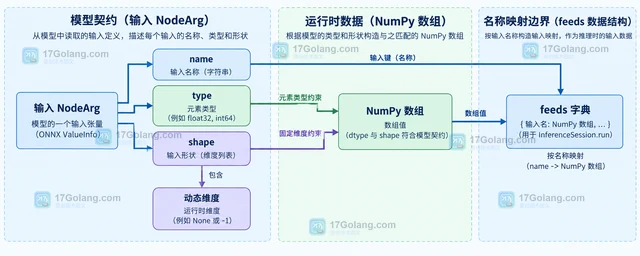 ONNX Runtime 加载模型后,可以通过 InferenceSession.get_inputs() 读取每个输入 NodeArg 的名称、类型和形状。本文说明如何识别动态维度,并按真实输入名构造 feeds 映射。349 收藏
-
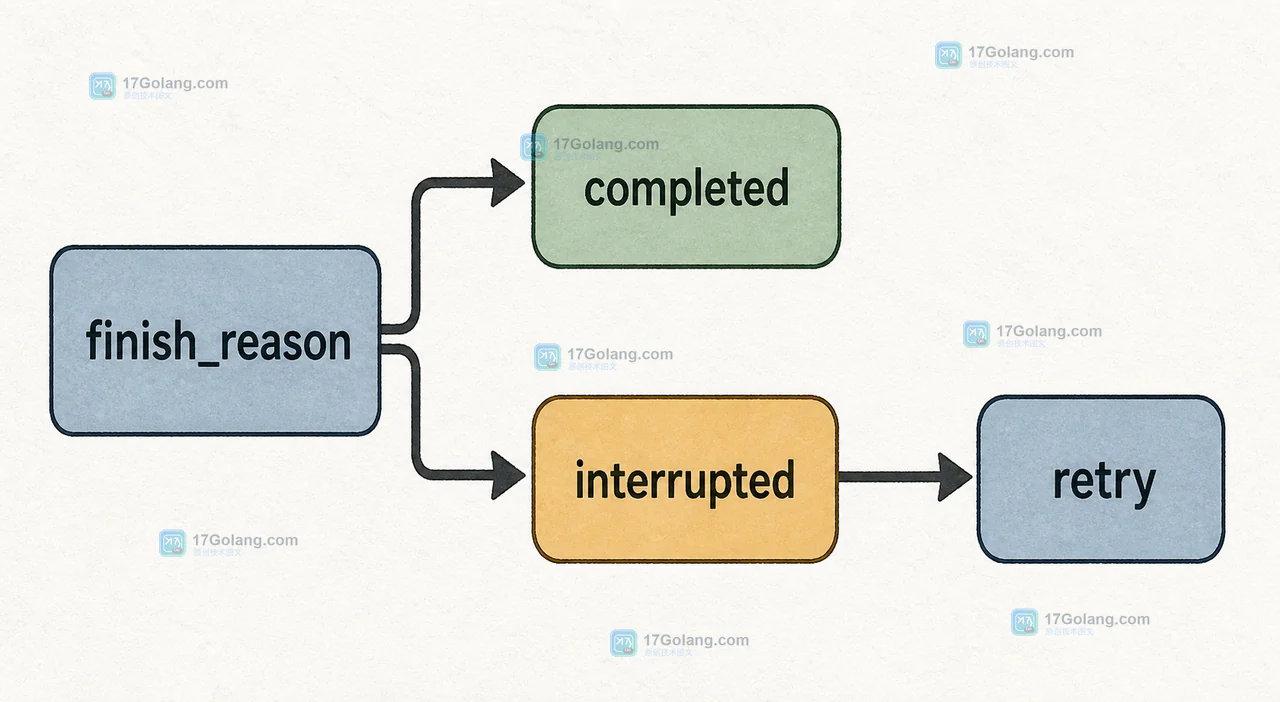 大模型流式响应偶尔停在半句时,不能只把已收到的字符串直接展示。本文用增量 JSON 缓冲、finish_reason 和重连状态拆开定位,并给出可复查的收口方案。348 收藏