
人工智能技术文章
-
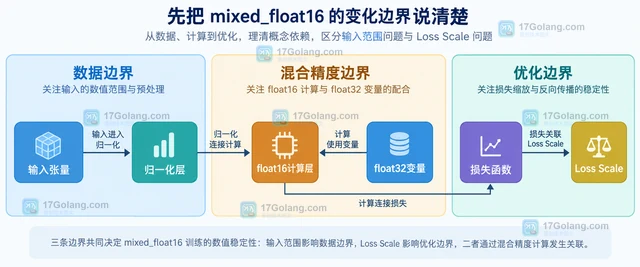 Keras mixed_float16 训练出现 NaN 时,先用 float32 建立对照,再检查输入有限性、数值范围、前向损失和梯度,区分数据问题、低精度敏感计算与 loss scale 问题。本文给出最小排查代码和迁移修复顺序。337 收藏
-
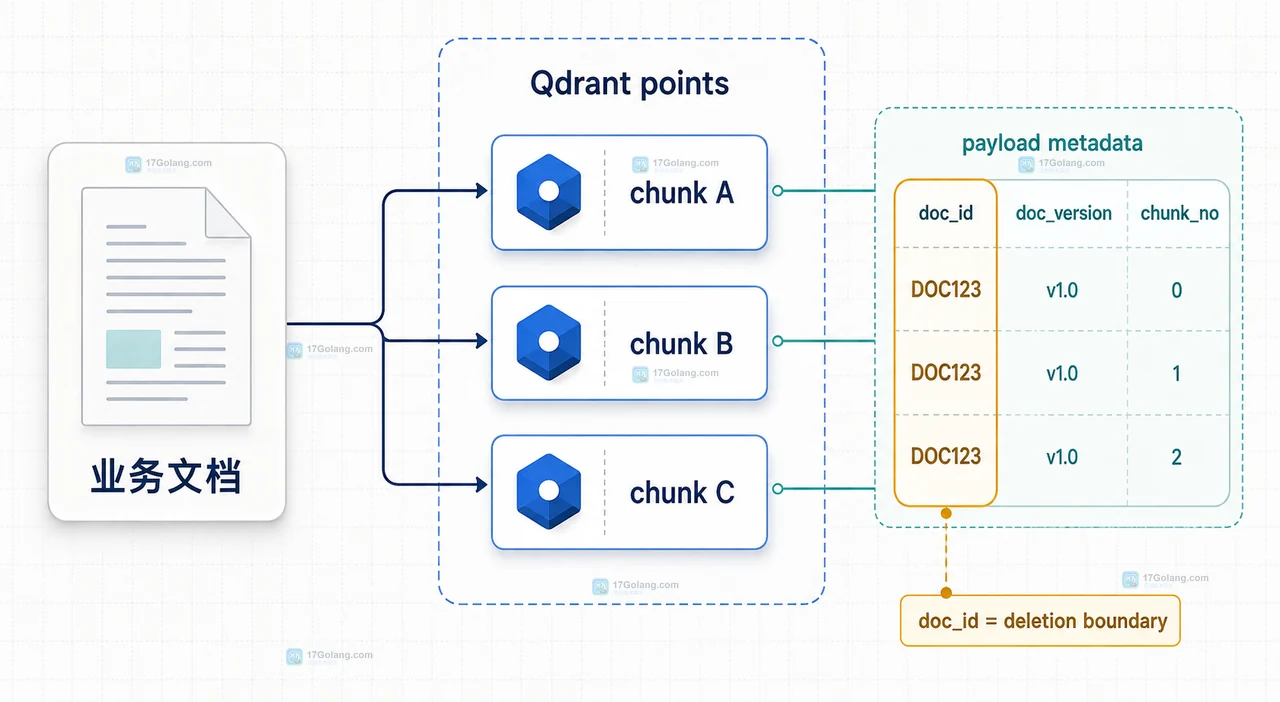 知识库删除原文时,不能只删业务数据库记录,还要依据稳定的 doc_id 清理 Qdrant 中的全部 points。本文说明 payload 设计、按过滤器删除、wait/ordering 选择,以及如何避免并发重建任务把旧向量重新写回。335 收藏
-
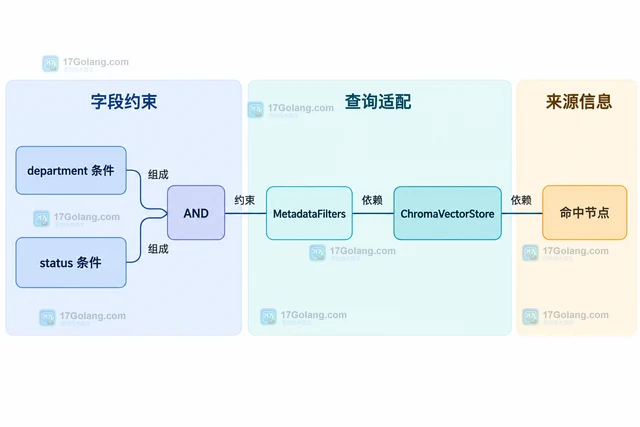 以 Chroma 为例,把节点 metadata 与 MetadataFilters 对应起来,演示等值 AND 过滤、模拟嵌入检索和临时集合清理,并解释字段类型、top-k、空结果及后端支持范围。334 收藏
-
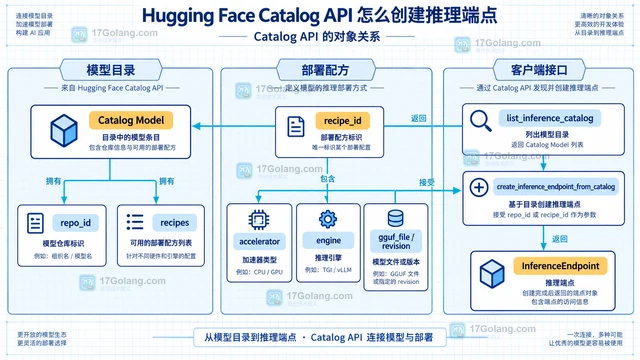 讲清 Hugging Face Catalog API 的模型与配方关系,并用 huggingface_hub 完成目录筛选、精确创建、状态等待和成本控制。333 收藏
-
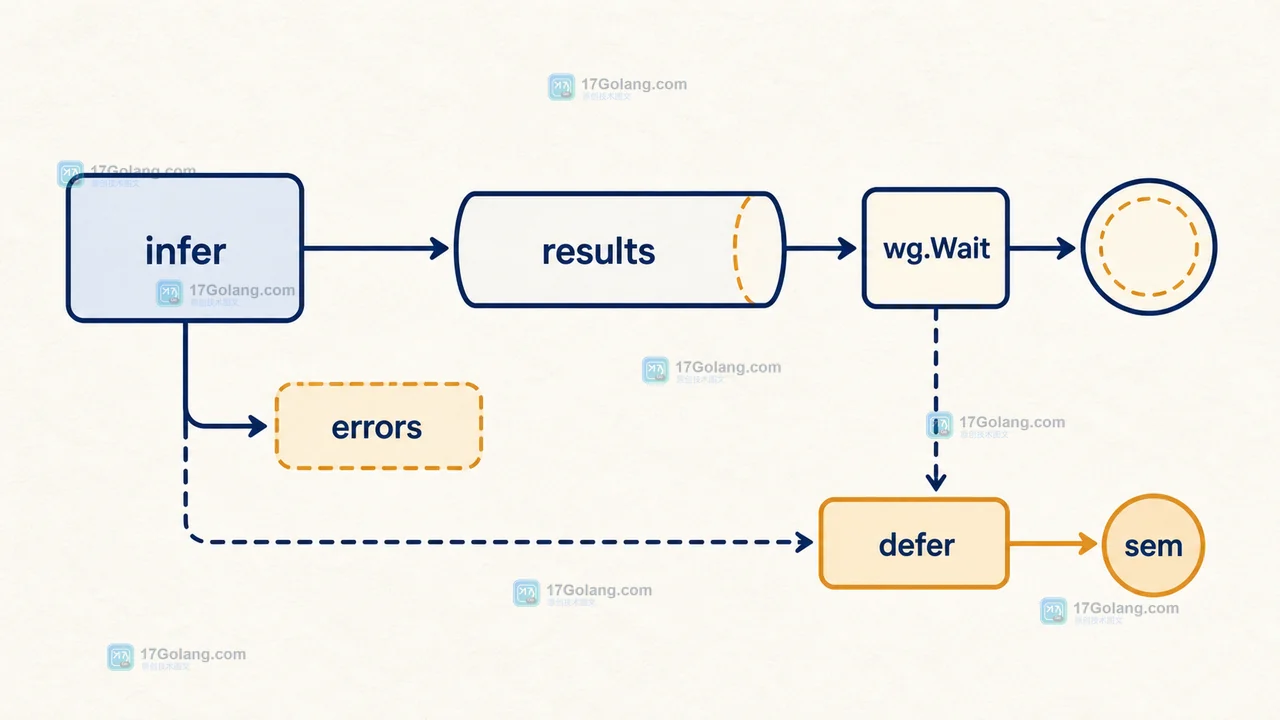 批量推理入口如果直接为每个请求创建 goroutine,短时间内就会把下游模型服务和本地内存一起推高。本文用 Go 的 channel 信号量限制并发,配合 context 取消、结果回收和失败清理,给出一条可以验收的控制路径。331 收藏
-
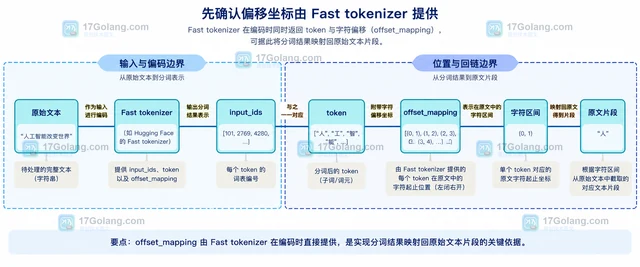 使用 Transformers Fast tokenizer 的 offset_mapping 把 token 位置还原为原始文本片段,并处理特殊 token、批量溢出、成对输入与预分词边界。330 收藏
-
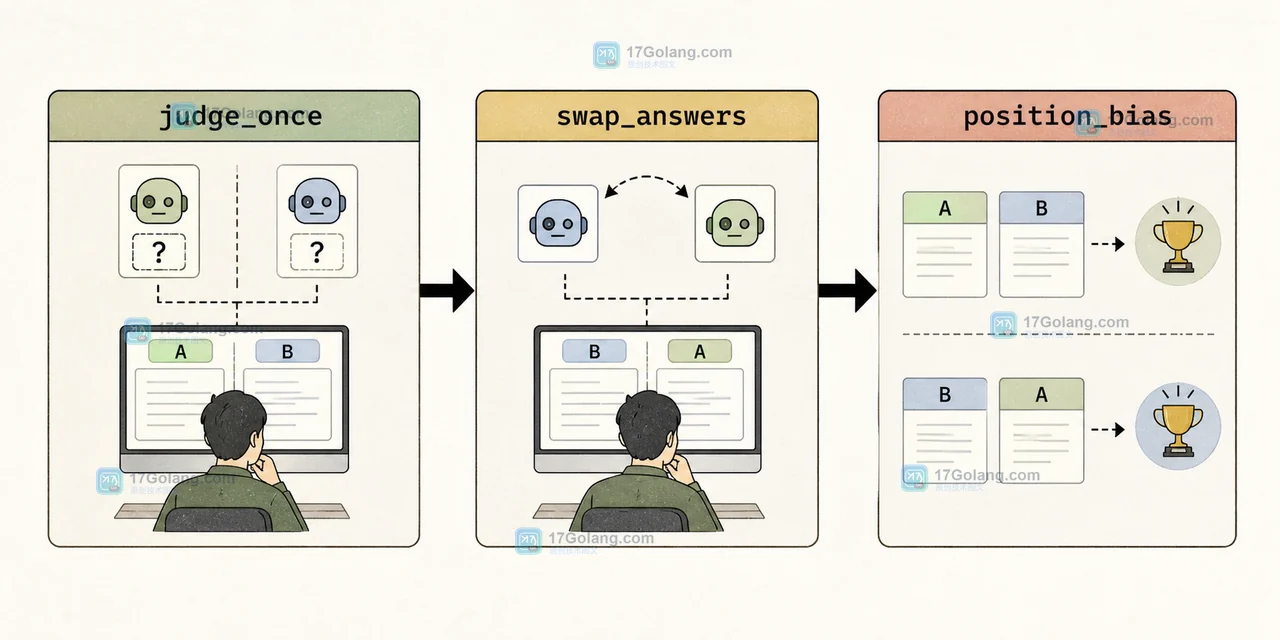 大模型评测中的长答案偏好,往往和位置偏差、格式线索混在一起。本文用成对盲评、交换答案位置和重复试验拆开这几个因素,并给出可复核的 Python 验收流程。329 收藏
-
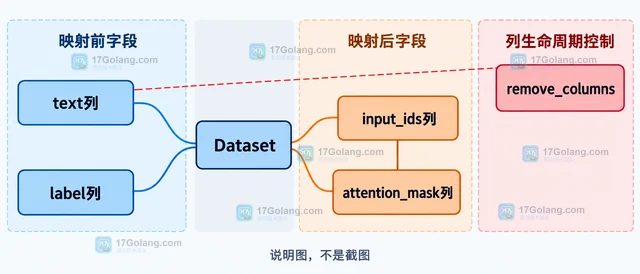 Hugging Face Datasets 的 map 在 batched=True 时按列传入一批样本。本文用一个可复用的 Python 示例说明怎样新增处理列、保留原始列,并用 remove_columns 控制最终字段。329 收藏
-
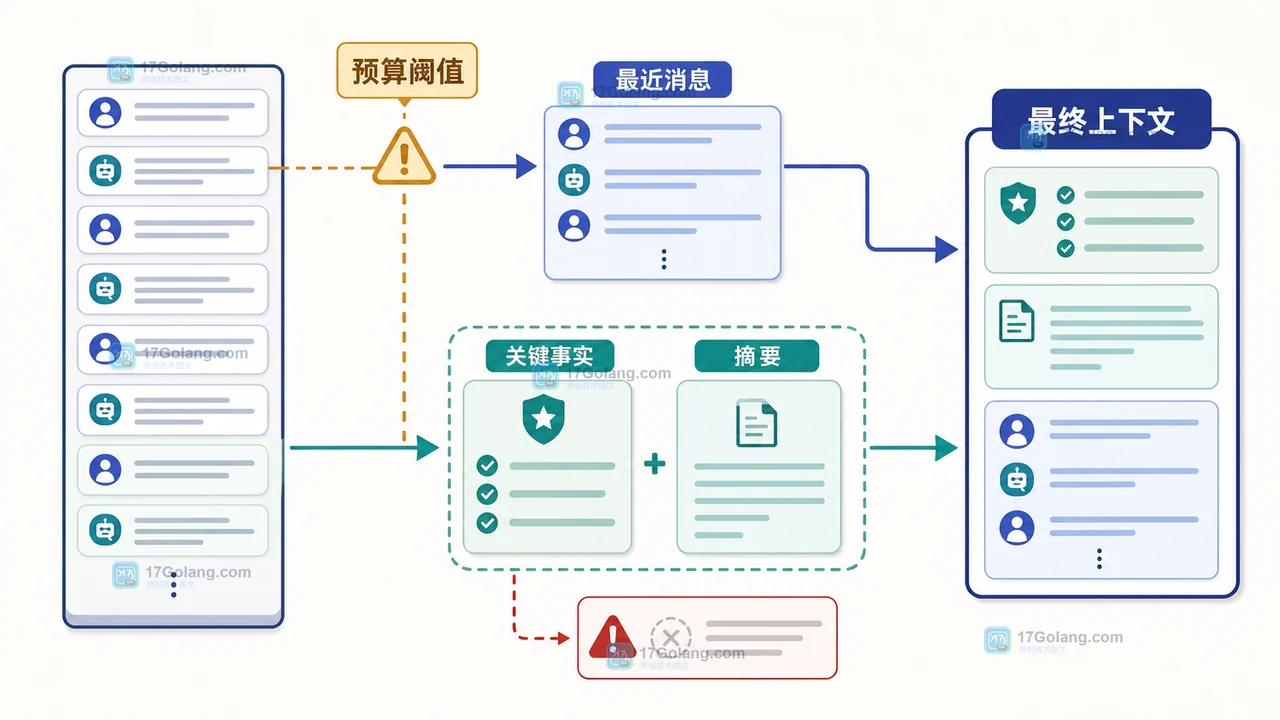 多轮对话越聊越长时,直接截掉旧消息会丢失用户约束,完全保留又会推高延迟和成本。本文给出摘要触发点、最近消息窗口和关键事实保留的组合方案,并用可回放的检查方式判断压缩后对话是否仍然可靠。328 收藏
-
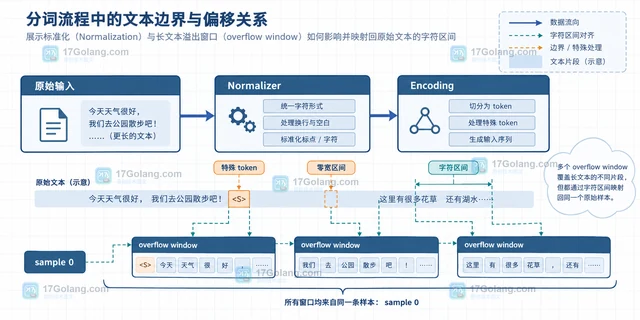 Tokenizers 的 offset mapping 本质是 token 到原始文本的半开字符区间。本文用 Fast Tokenizer 说明 return_offsets_mapping、特殊 token、空白、规范化和溢出窗口的定位方法。328 收藏
-
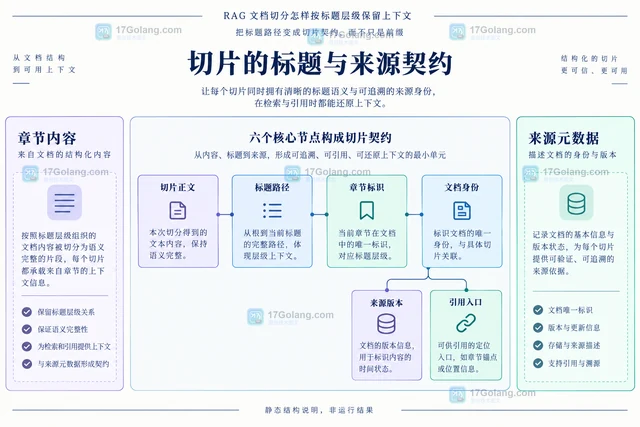 RAG 按标题层级切分应先分章节,再按长度细分并继承标题路径和来源元数据。本文用原创 Markdown 示例说明检索文本、生成上下文、引用定位和旧索引迁移的边界,避免切片只剩孤立正文。328 收藏
-
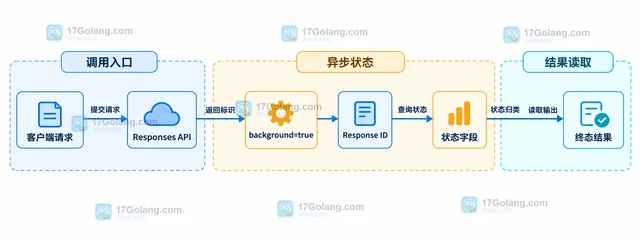 OpenAI Responses API 的 background 模式可以让长耗时任务异步运行。本文用一个可复用的轮询骨架说明如何保存 response_id、区分处理中与终态,并比较取消、流式恢复和数据保留的取舍。327 收藏
-
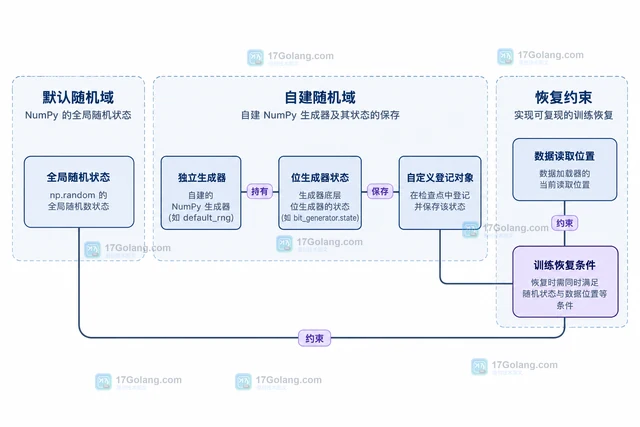 用Accelerate的save_state与load_state保存和恢复训练随机数状态,通过epoch边界示例说明加载时机、自建生成器登记和数据位置区别,避免将固定seed误当断点恢复。326 收藏
-
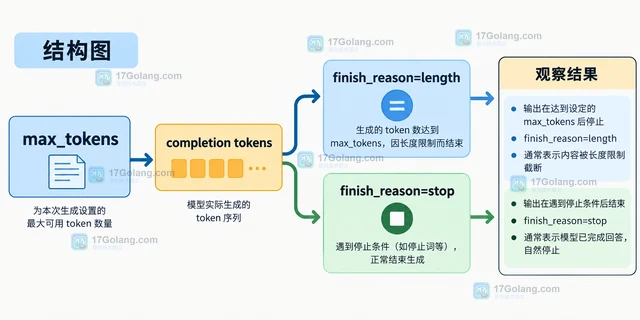 讲清 vLLM 在线服务中请求级 max_tokens 的设置位置、上下文边界与 finish_reason 判断方法,帮助按业务预算控制输出长度。326 收藏
-
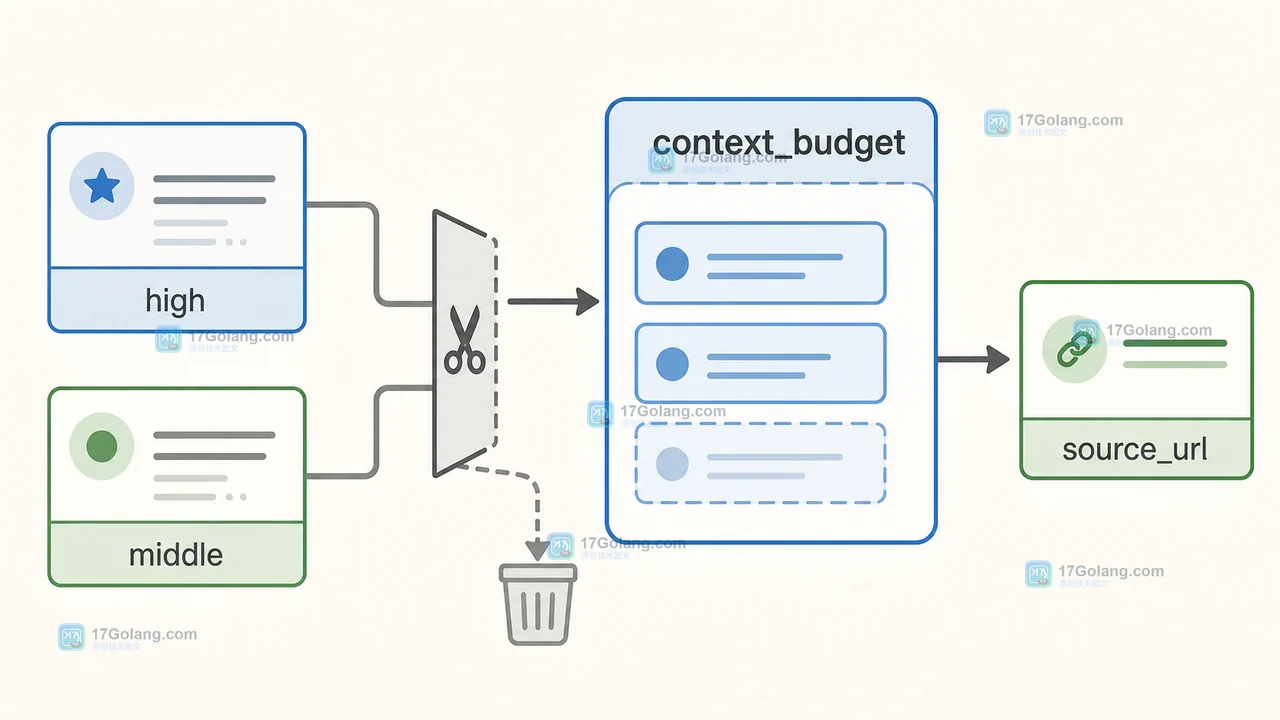 RAG 应用不能把最高相似度直接当成答案可信度。本文用可复现的分层规则,把 query_embedding、similarity_score、上下文预算和引用保留串成一条检索到回答的质量控制链。325 收藏