
人工智能技术文章
-
 StoppingCriteriaList 是 Transformers 生成过程中的停止条件容器。本文用长度、时间和自定义条件说明如何组合它们,并解释按 batch 样本合并布尔结果、scores 依赖和 max_length 冲突。325 收藏
-
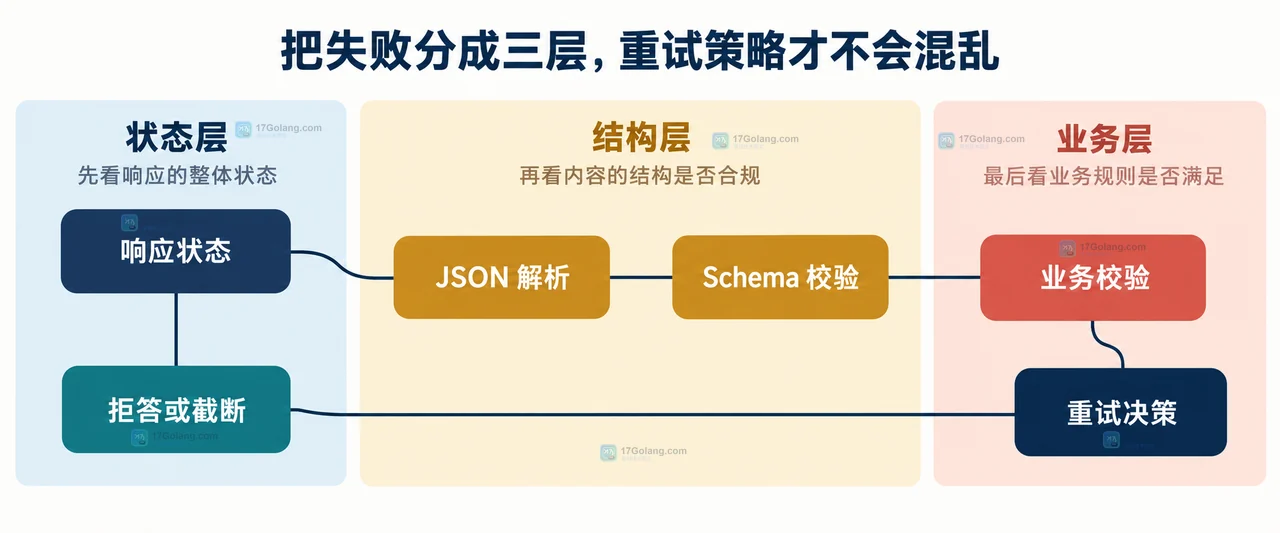 结构化输出校验失败时,不要只记录 ValidationError。本文把原始响应保存、拒答与截断判断、JSON 解析、Schema 校验和业务校验拆开,给出一套可脱敏、可重放、可定位的应用层处理方式。324 收藏
-
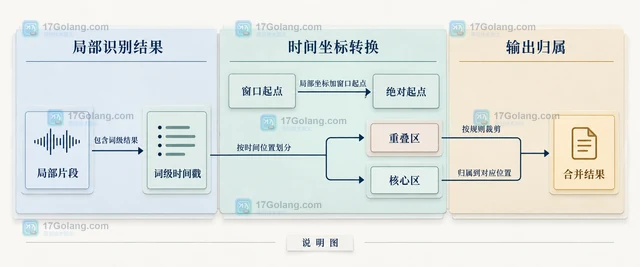 围绕固定窗口、重叠区和绝对时间线,说明长音频语音转文字如何保留边界语音、裁剪重复文本并合并时间戳。324 收藏
-
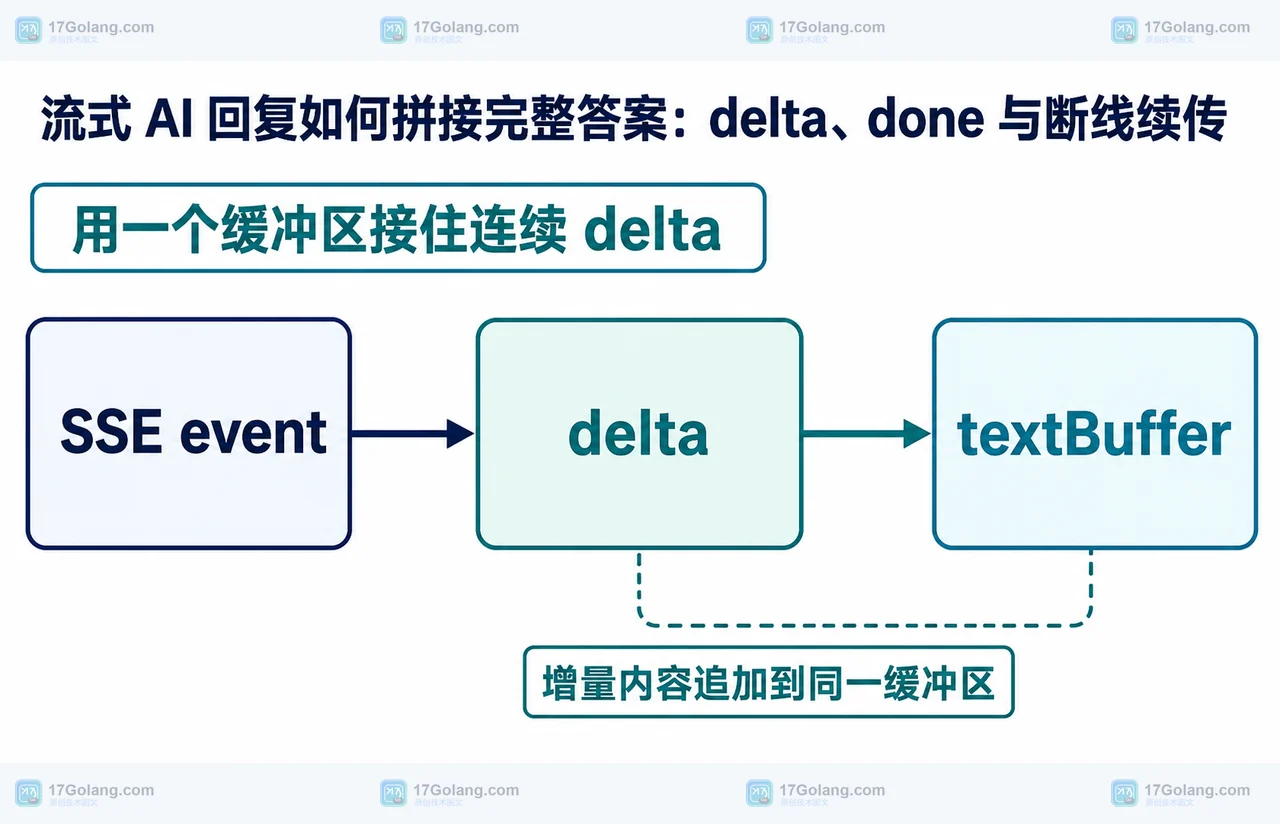 流式 AI 接口返回的是连续事件而不是一段完整文本。本文用浏览器 ReadableStream 拆解 delta、done、缓冲区与断线续传的边界,给出可落地的拼接方案。323 收藏
-
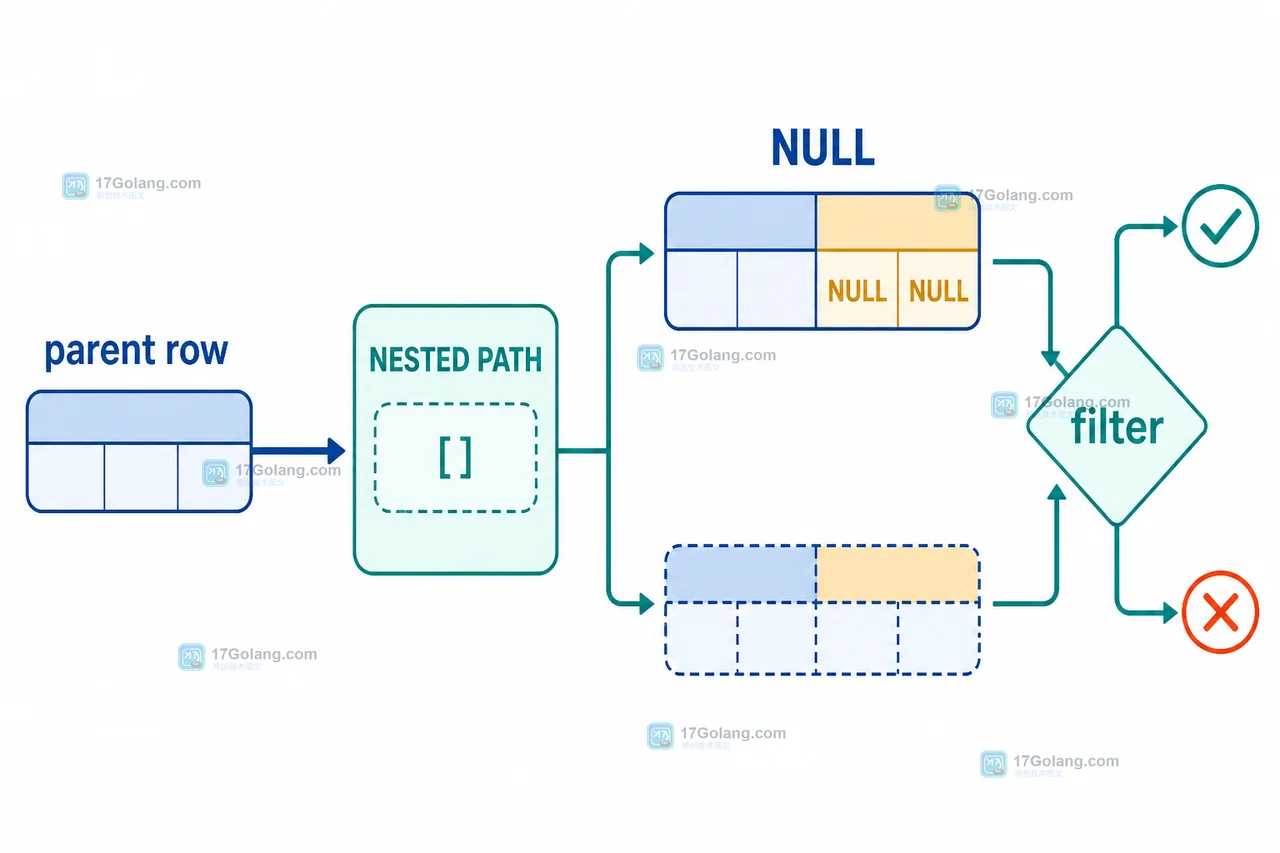 用 MySQL JSON_TABLE 将订单 JSON 中的商品与批次嵌套数组展开成可查询的行,解释 NESTED PATH 的路径继承、行扩展、空数组补 NULL,以及 ON EMPTY 与 ON ERROR 的边界。322 收藏
-
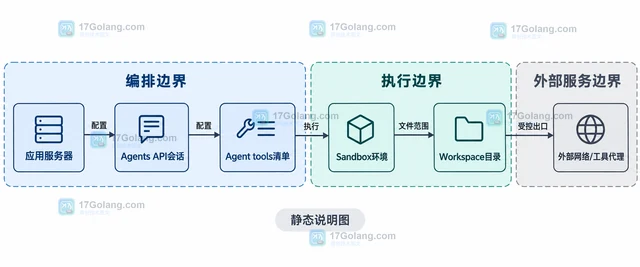 从工具清单、Agents API 执行环境、工作区挂载、网络白名单和凭据代理五个边界说明如何把 Agent 工具限制在沙箱内,避免把 workspace 路径误当成完整隔离。321 收藏
-
 Gemini API 的 URL Context 能读取公开网页,但应用不能只看模型有没有输出。本文用 Go 检查 url_context_result、引用标注、输入 token 与失败回退,建立一条可验收的网页上下文链路。320 收藏
-
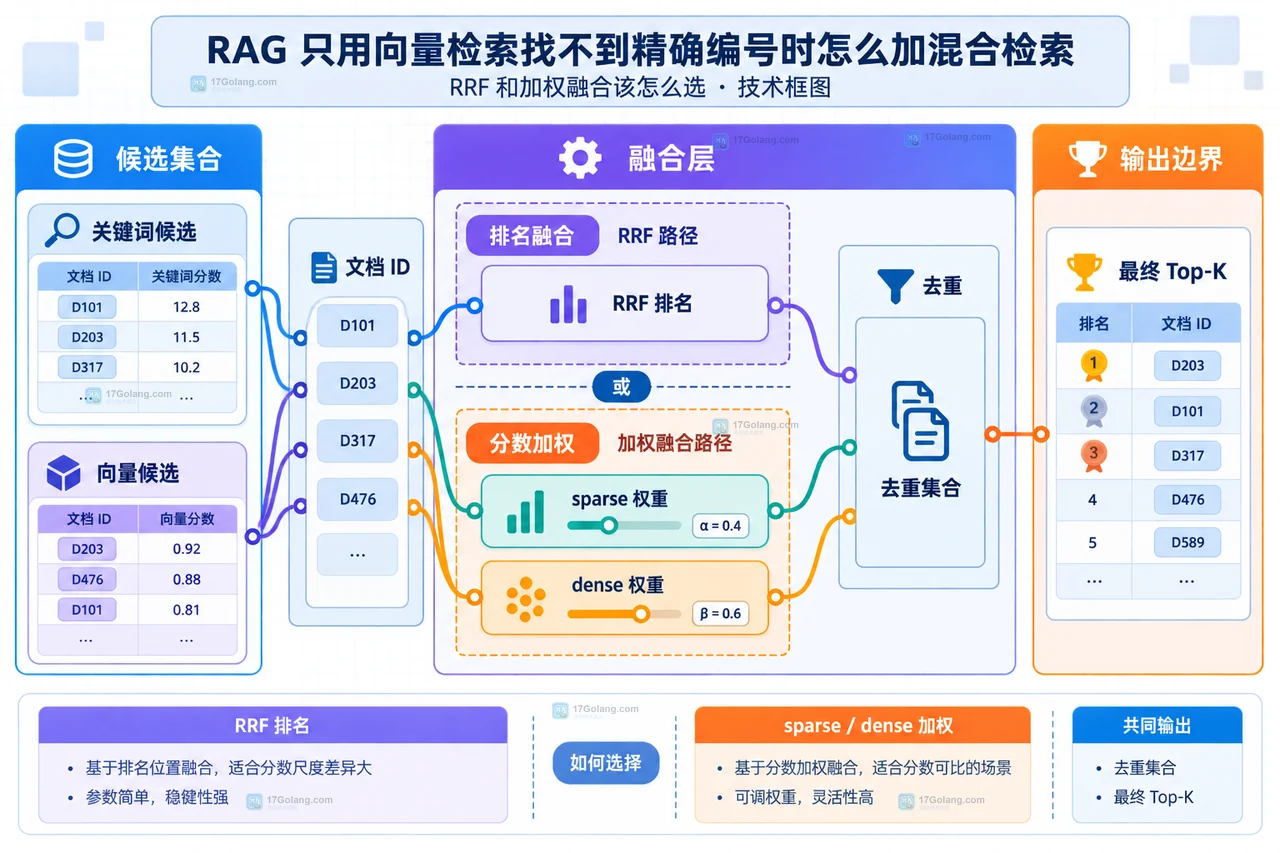 RAG 遇到订单号、设备编号、产品型号等精确词时,单纯向量检索可能把关键文档排到后面。本文用关键词检索加向量检索的混合召回,再用 RRF 或可解释权重合并结果。320 收藏
-
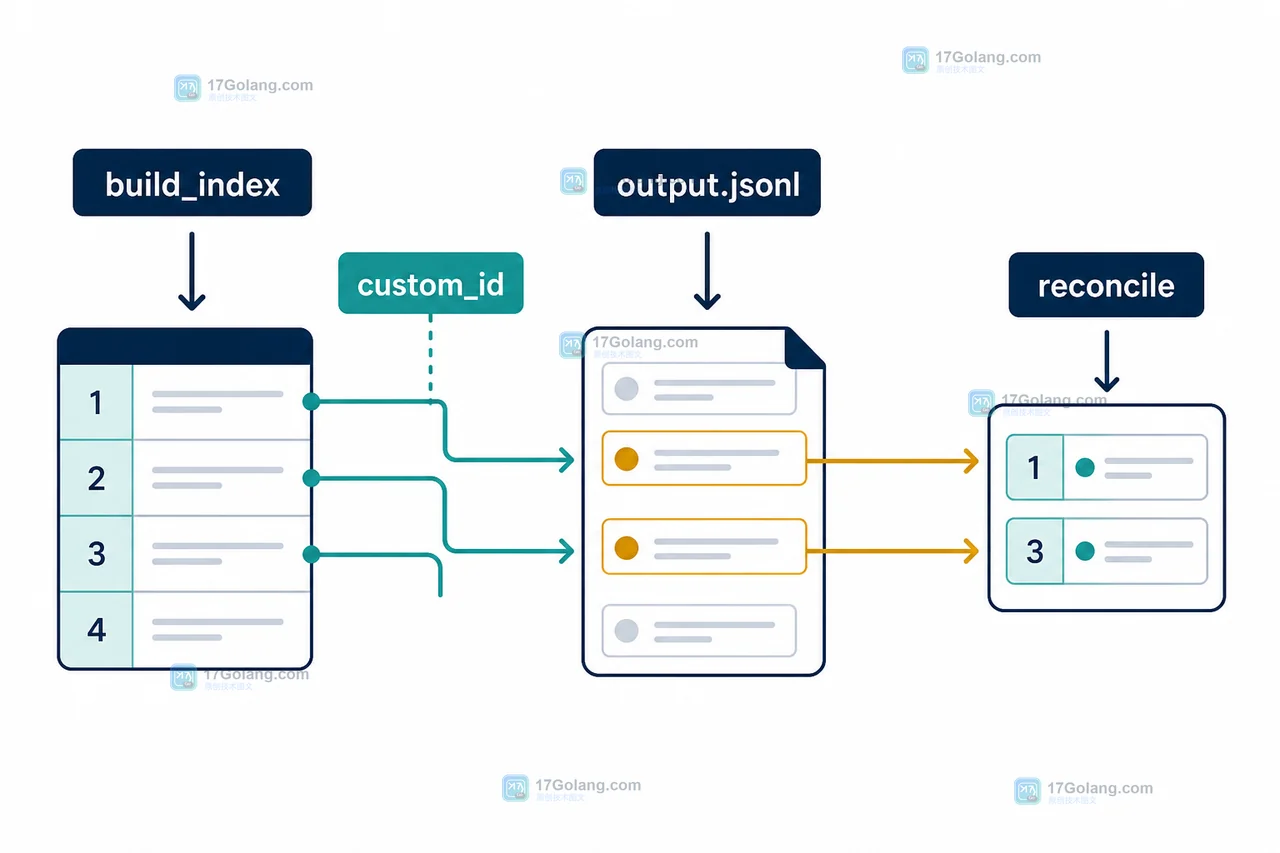 多模态批处理完成后,输入行与输出行可能顺序不同,失败请求也可能单独落在错误文件。本文用 custom_id 建立稳定主键,再按 JSONL 逐行解析、分离成功与失败,并给出可重跑而不重复记账的对账流程。319 收藏
-
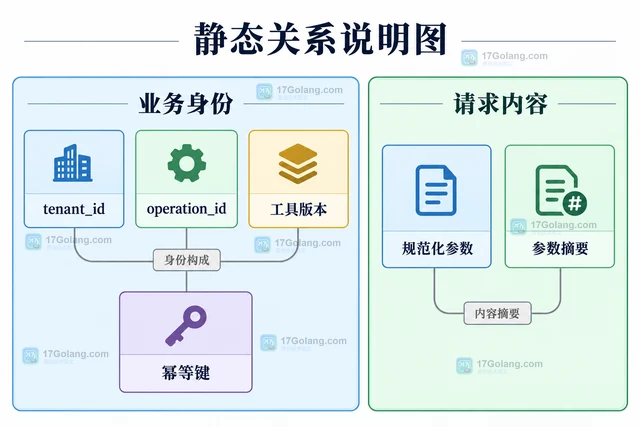 AI 工具调用的幂等键应绑定一次已授权的业务操作,配合原子占位、参数摘要和结果复用。本文用最小决策代码解释重复执行、参数冲突及远程超时后的不确定状态。319 收藏
-
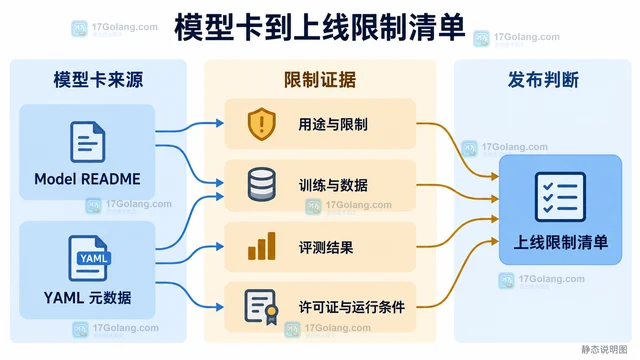 模型卡不是模型宣传页,而是上线前整理适用范围、潜在限制、数据与评测证据的入口。本文把 Hugging Face 模型卡字段整理成限制清单,并给出缺失字段的记录方式。318 收藏
-
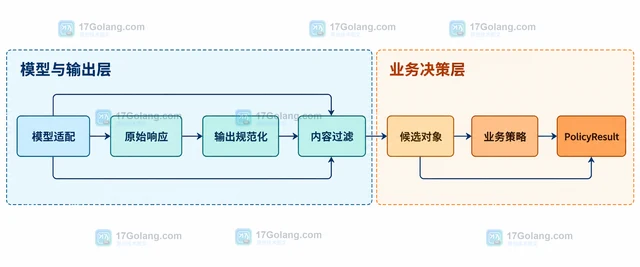 把模型输出规范化、内容过滤和业务授权拆成独立边界,用统一的 allow、deny、review 结果和原因码减少误判、重试与审计混乱。317 收藏
-
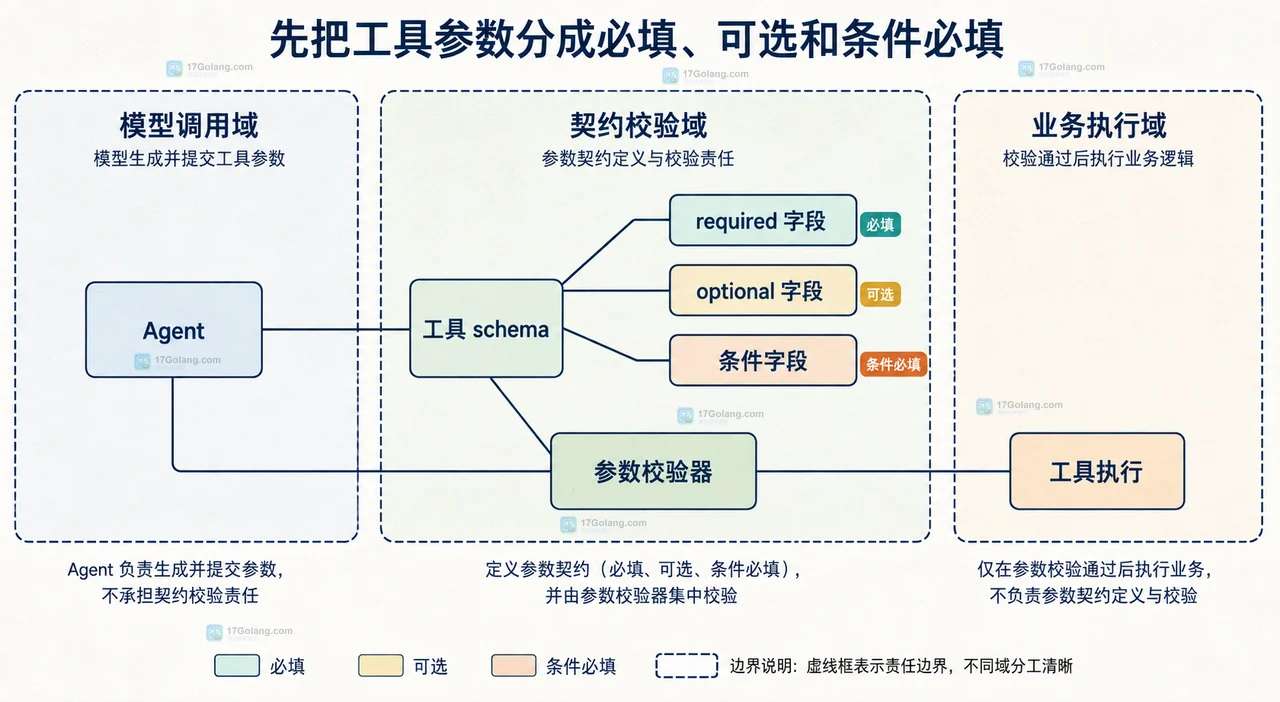 AI Agent 调用工具时经常漏传必填字段,问题通常不在提示词,而在工具契约没有收紧。本文用 JSON Schema 拆分必填、类型、额外字段和失败回传,给出可落地的校验与重试边界。316 收藏
-
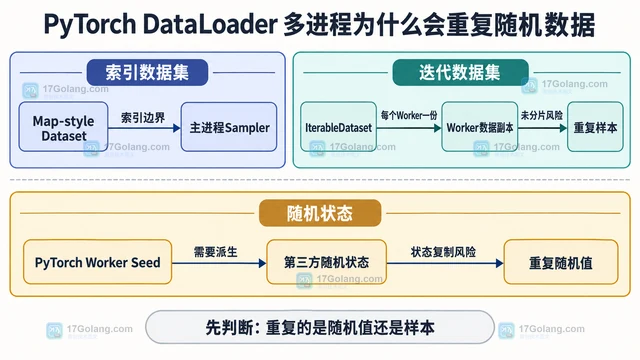 排查 PyTorch DataLoader 多进程中的重复随机值与重复样本,说明 worker seed、第三方随机库、IterableDataset 分片和 generator 的正确配置。316 收藏
-
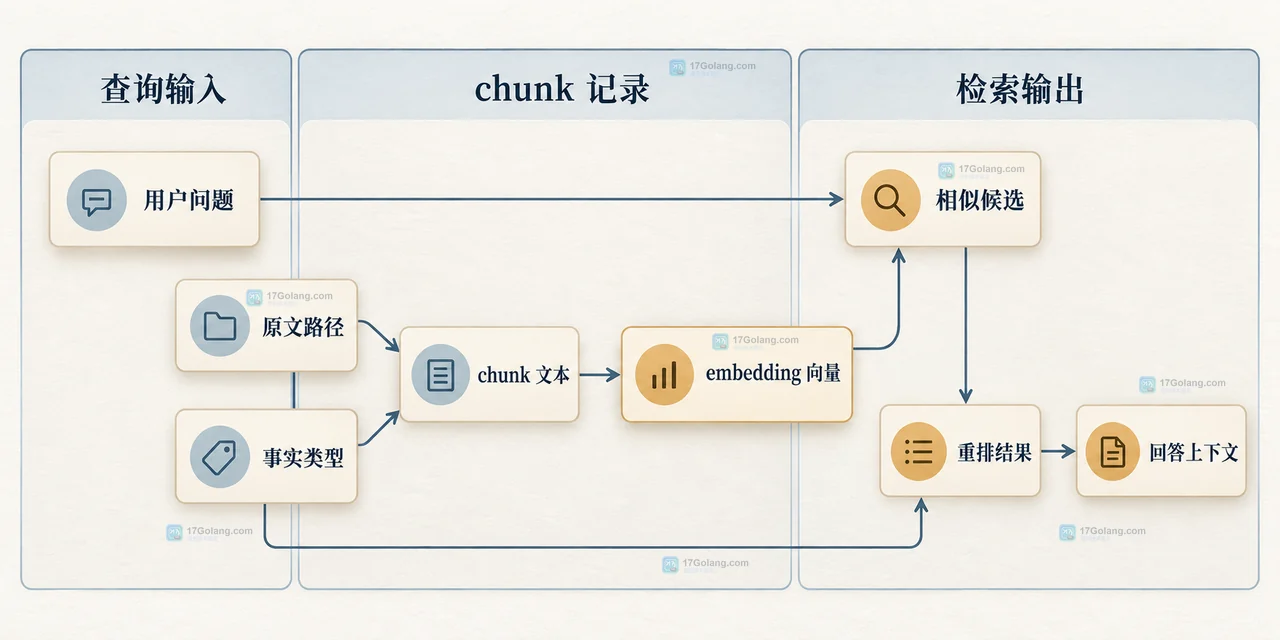 Embedding 文本切块不要只按固定字符数截断;应先保留主体、条件、动作、结果和例外,再用结构边界、适量 overlap 与可追溯元数据保护事实完整性。314 收藏