
人工智能技术文章
-
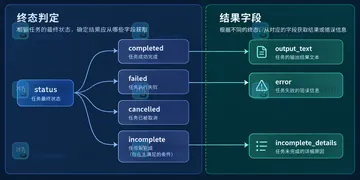 OpenAI Responses API 使用 background=true 后,先保存 response.id,再通过 Responses 取回接口轮询 queued 或 in_progress 状态;本文说明如何读取 output_text,并处理 failed、cancelled、incomplete 等终态。314 收藏
-
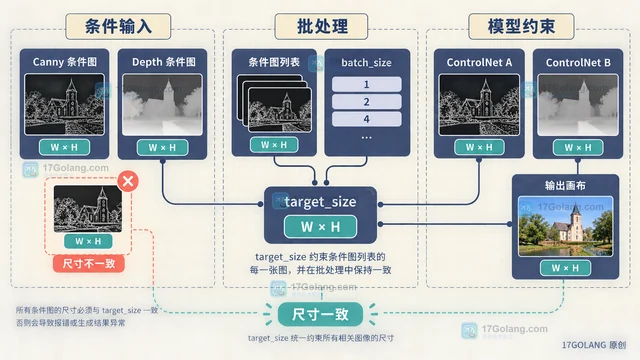 讲清 Diffusers ControlNet 条件图与生成画布的尺寸匹配方法,覆盖等比补边、居中裁切、多 ControlNet 和批量输入检查。314 收藏
-
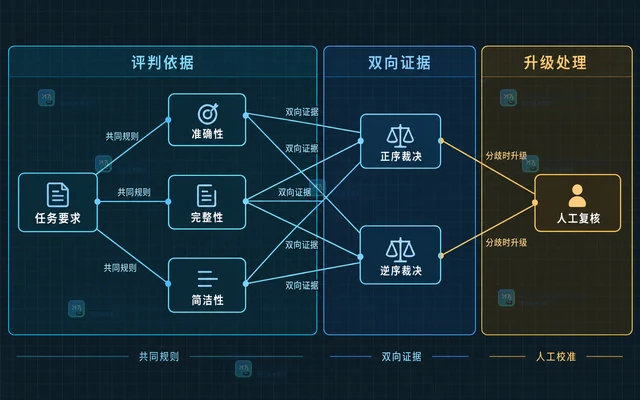 减少大模型裁判的位置偏差,不能只在提示词里要求公平,而应对同一回答对同时运行 A-B 与 B-A 两种顺序,统一还原答案身份,只合并一致判定,并把翻转样本升级为不确定或人工复核。314 收藏
-
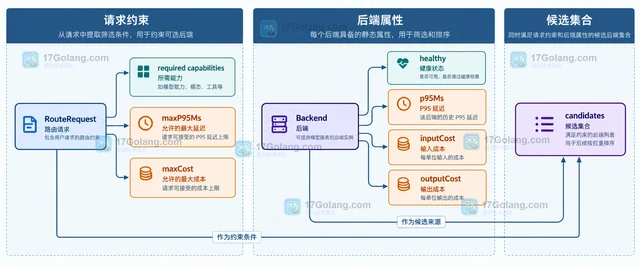 模型路由不应该只看一次调用的速度或单价。把延迟、成本、能力、健康状态和回退边界拆开,先用硬约束筛选,再按业务权重排序,才能让后端选择稳定可解释。314 收藏
-
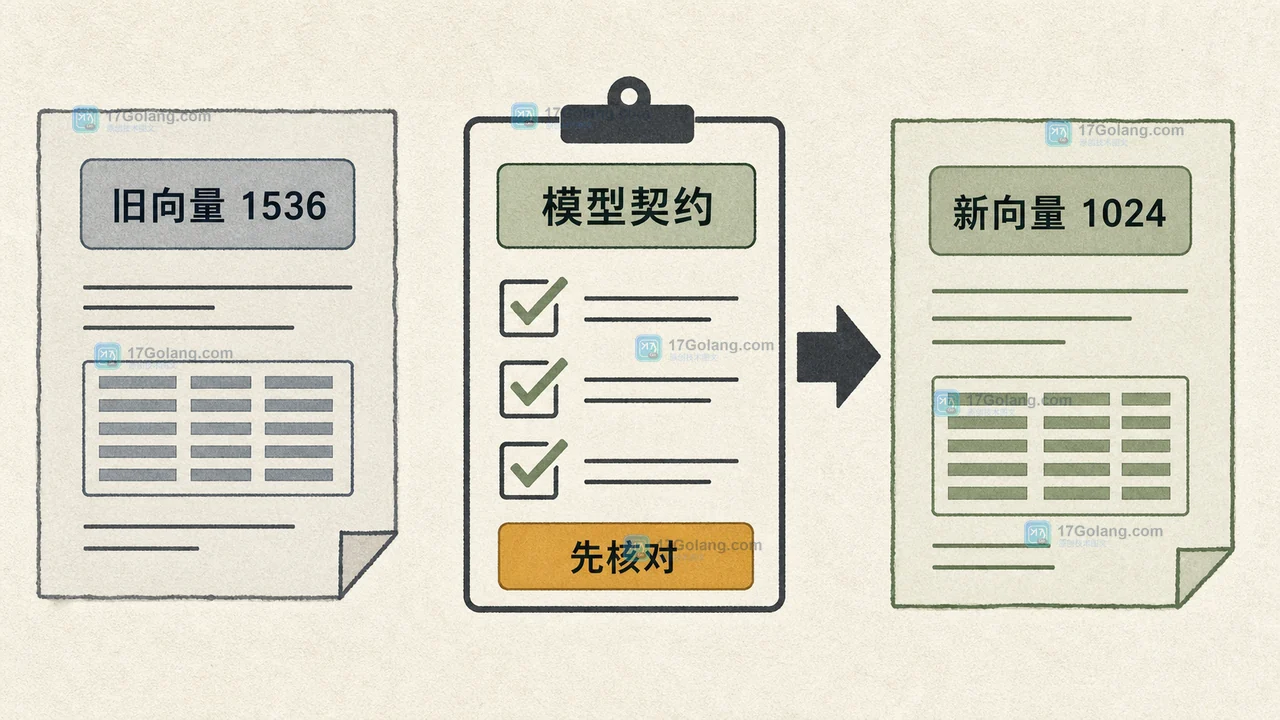 Embedding 模型升级或调整 dimensions 后,旧向量、查询向量和数据库索引可能不再兼容。本文用维度契约、双写灰度和检索验收三步,说明如何安全迁移并避免静默召回下降。313 收藏
-
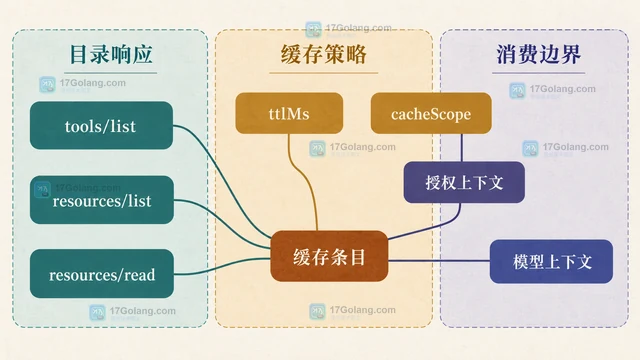 MCP 客户端不应只靠固定 TTL 缓存工具描述和资源。本文按 tools/list、resources/list、resources/read 拆分缓存键,结合 ttlMs、cacheScope 与变更通知设计可恢复的一致性策略。313 收藏
-
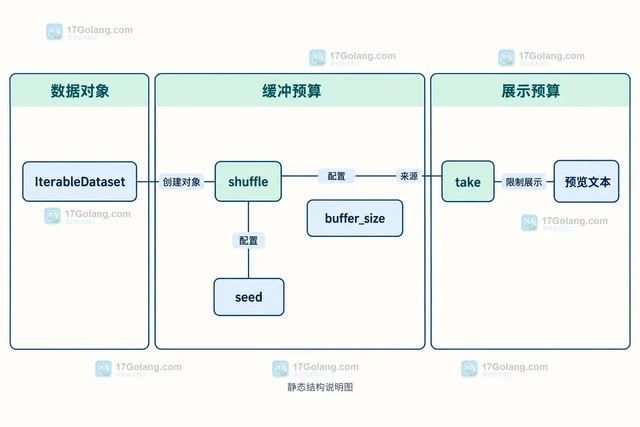 Datasets streaming 大数据集读取教程:使用 JSONL 和 IterableDataset 做有界预览,配置 shuffle 缓冲区,处理空数据与字段错误,避免全量累积内存。313 收藏
-
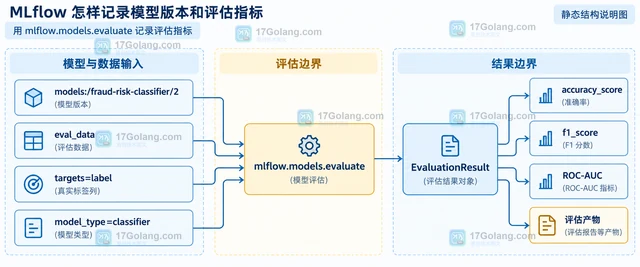 用一个完整的 MLflow Run 串起参数、手工指标、模型制品、注册模型版本和测试集评估结果:先固定实验与注册模型名,再用 registered_model_name 生成版本,最后通过 mlflow.models.evaluate 读取 accuracy、F1 等指标。313 收藏
-
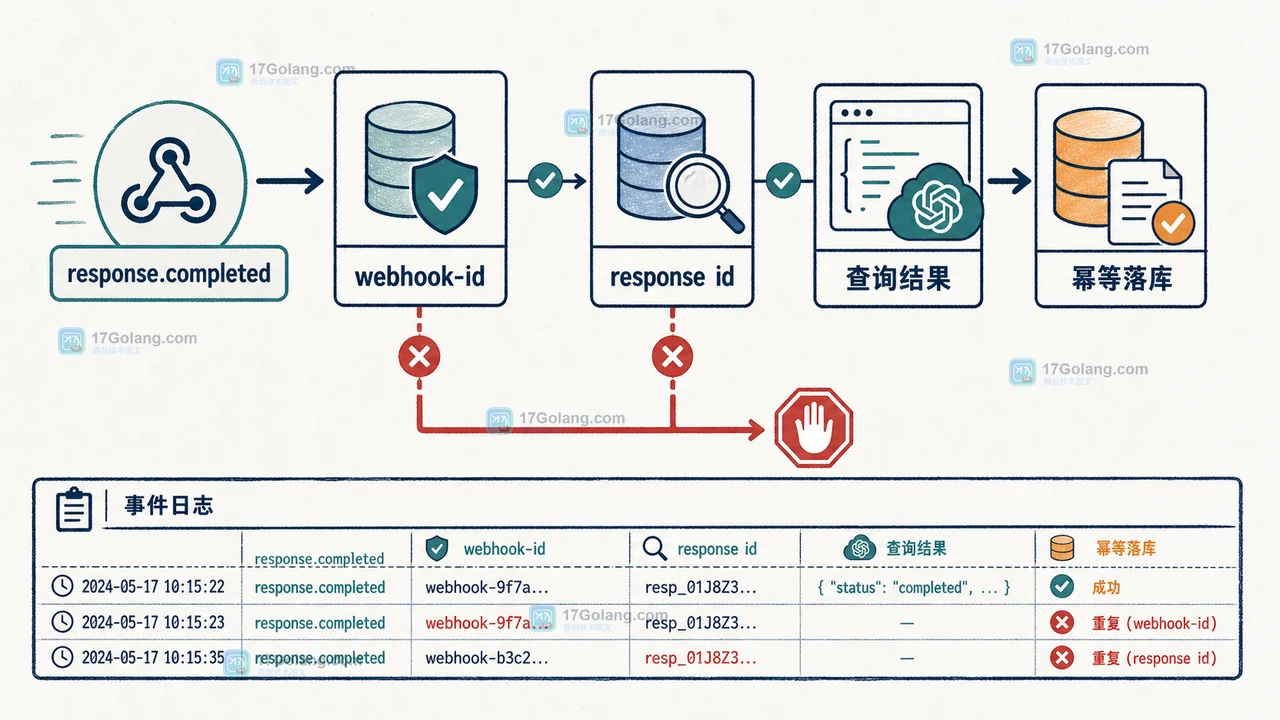 OpenAI Responses API 进入后台模式后,response.completed 会通过 Webhook 通知服务端。本文用 Python 说明如何保留原始请求体、调用官方 SDK 验证签名、处理时间窗口与重复事件,避免把未验证的回调直接当成任务完成信号。312 收藏
-
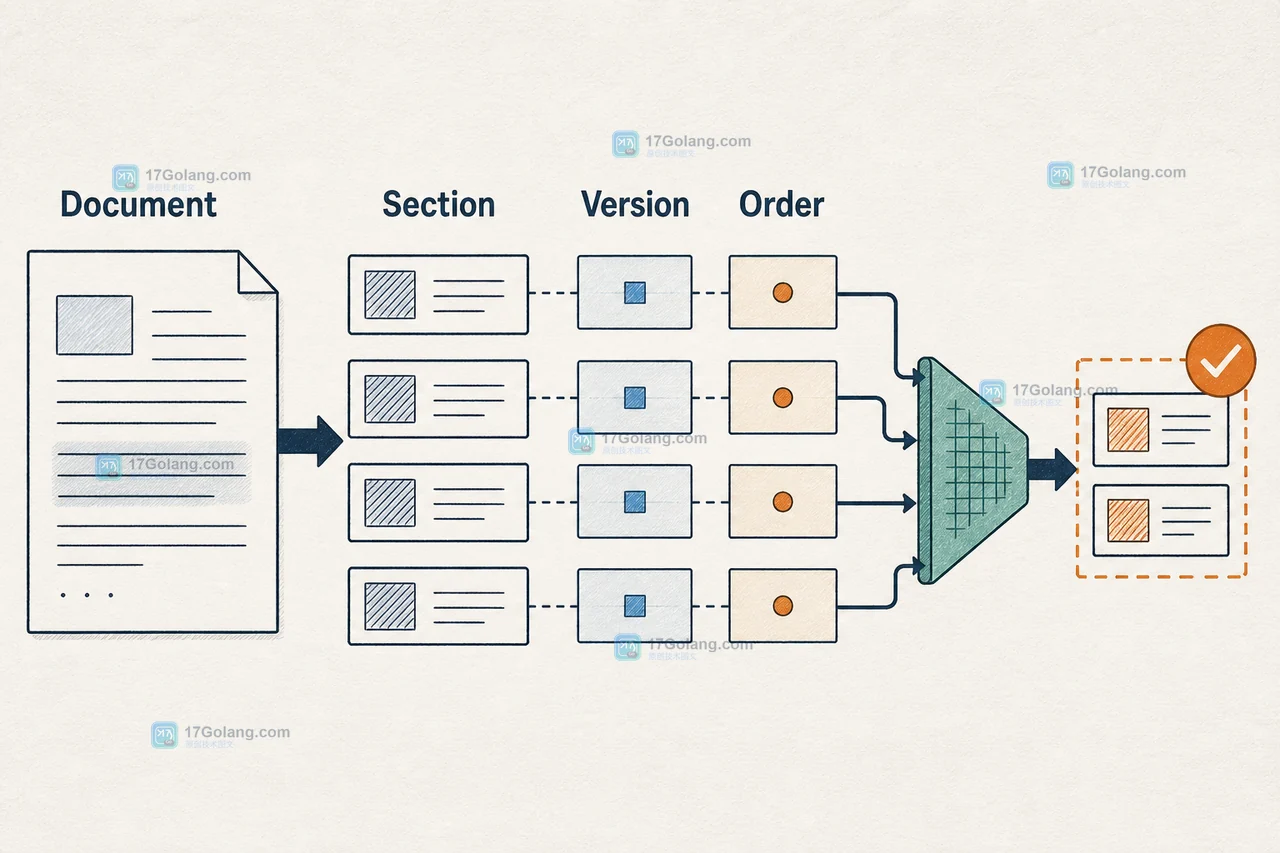 RAG 不是把检索结果越多越好。长文档切块过粗、候选混杂或没有在重排后裁剪上下文,模型就会被无关段落淹没。本文用 Go 拆开分块元数据、dense 与 sparse 候选、重排 top 10 和上下文预算,给出可回放的验收路径。312 收藏
-
 介绍视觉模型读取表格图片时的区域化证据链:用稳定 region_id 组织裁剪图和字段范围,结合多图输入与 JSON Schema 保存可回溯的字段证据,并处理成本、空值和跨页边界。312 收藏
-
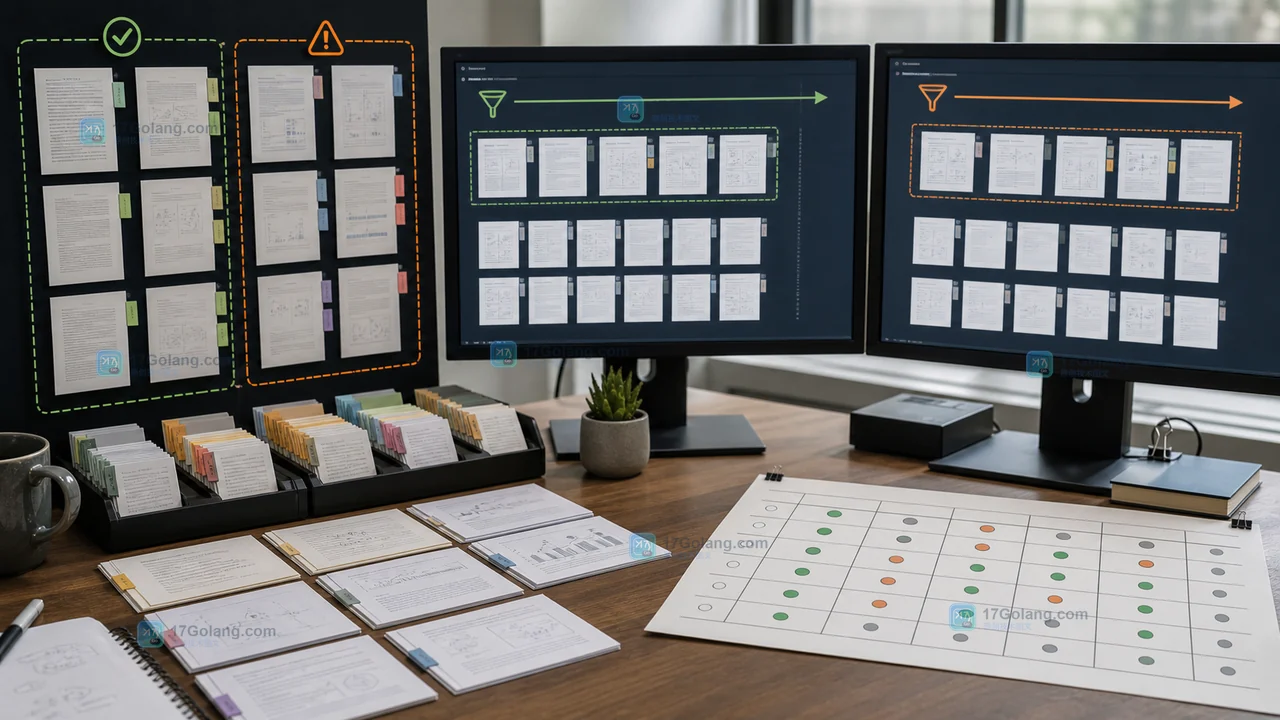 同一批文档、相近的问题,向量检索却可能召回不同结果。本文从查询向量归一化、元数据过滤和评测样本三个边界入手,给出一个能复现波动、定位原因并验证修复的最小流程。311 收藏
-
 RAG 处理 PDF、Excel 或 Markdown 表格时,固定长度切片容易丢失表头和来源。本文用行级知识块、metadata 和检索组合保留表格关系。311 收藏
-
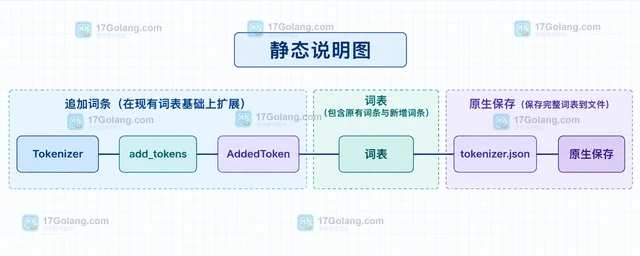 用 Hugging Face Tokenizers 添加领域词条后,如何保存并重新加载自定义词表?本文区分追加词条与重新训练词表,分别说明 save()、from_file() 与 save_pretrained() 的使用边界。311 收藏
-
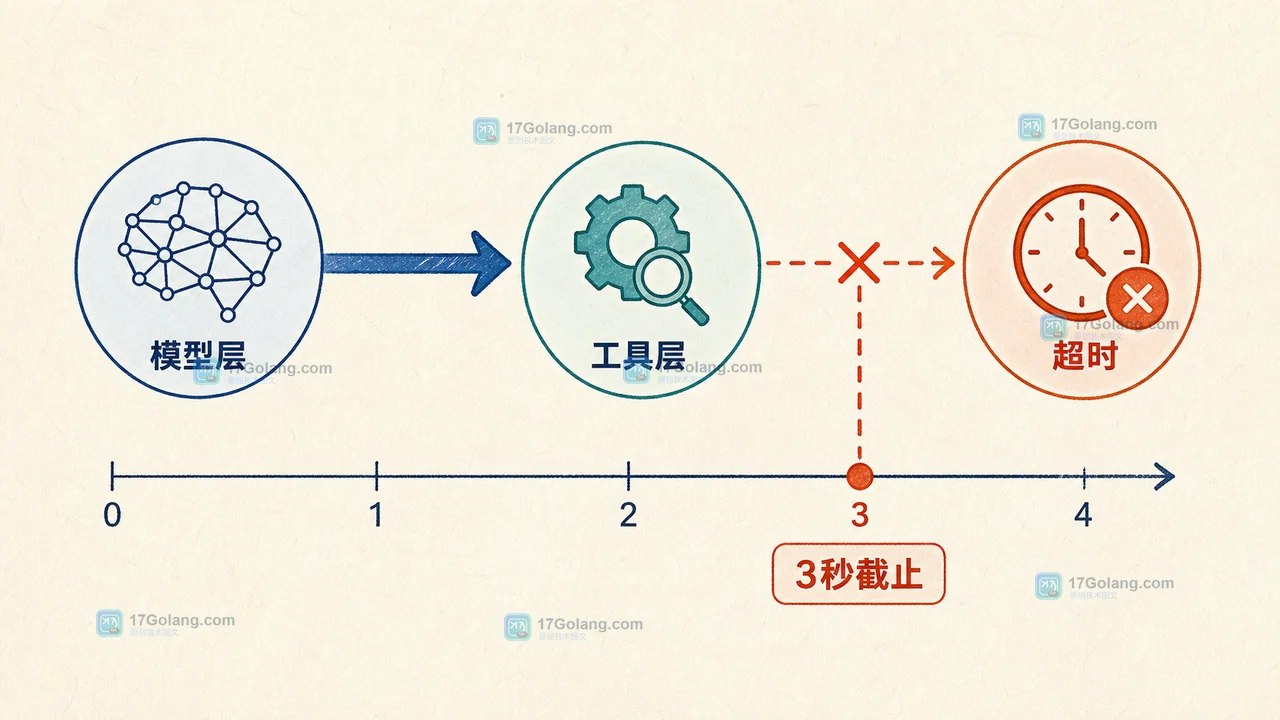 AI 应用调用搜索、数据库或业务接口时,超时不只是返回一条错误消息。本文用 Go context 把截止时间、取消信号、工具结果和用户状态串成一条可验收的链路,说明何时停止、如何记录以及怎样避免重复执行。310 收藏