
人工智能技术文章
-
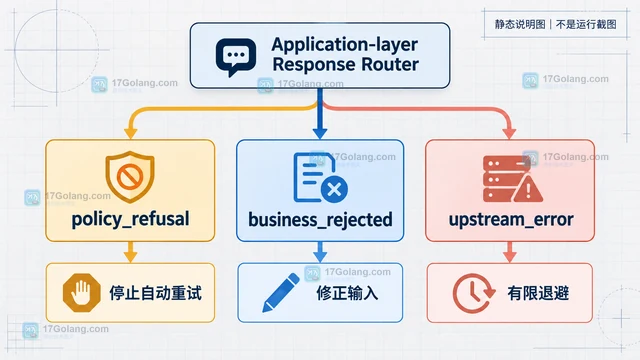 从应用层响应分支出发,把安全拒答、业务失败和上游错误拆开记录,建立稳定错误码、重试边界与日志字段。310 收藏
-
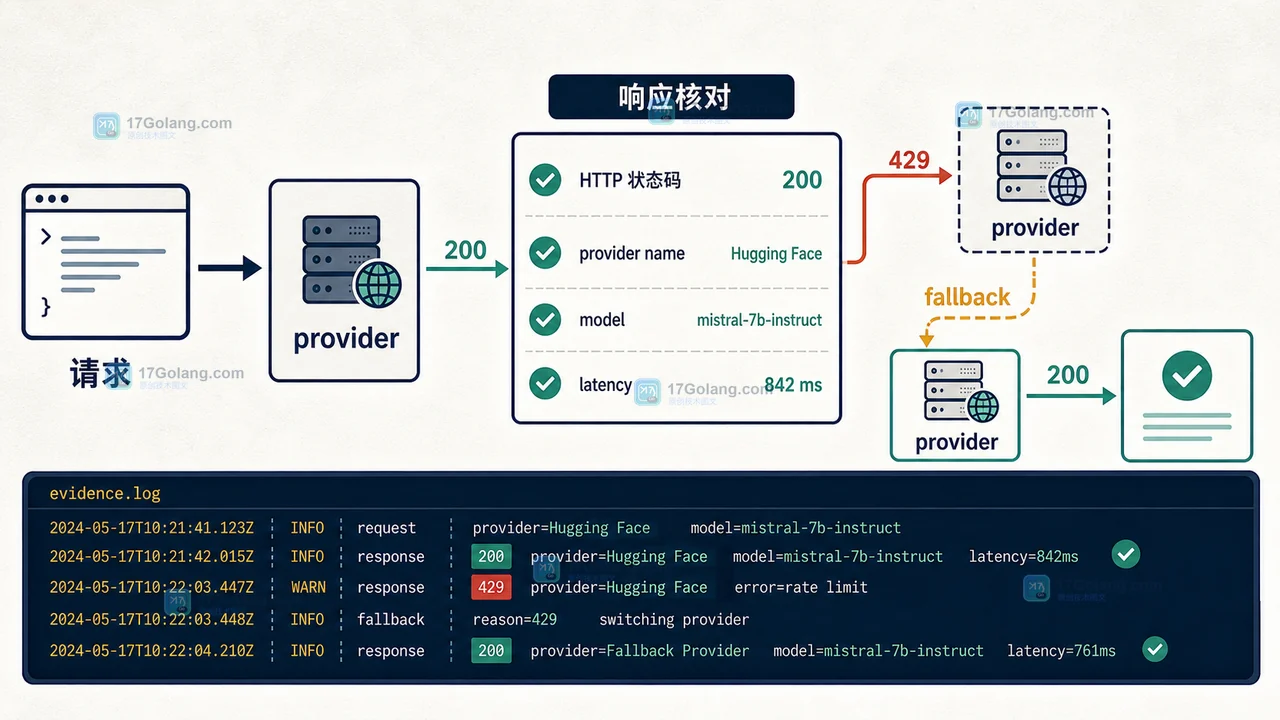 Hugging Face Inference Providers 可以让同一套客户端接入多个推理服务。本文从 provider=auto 的默认路由开始,说明何时固定具体 provider、如何设计 fallback、如何记录实际路由和响应字段,避免模型可用但结果格式悄悄变化。309 收藏
-
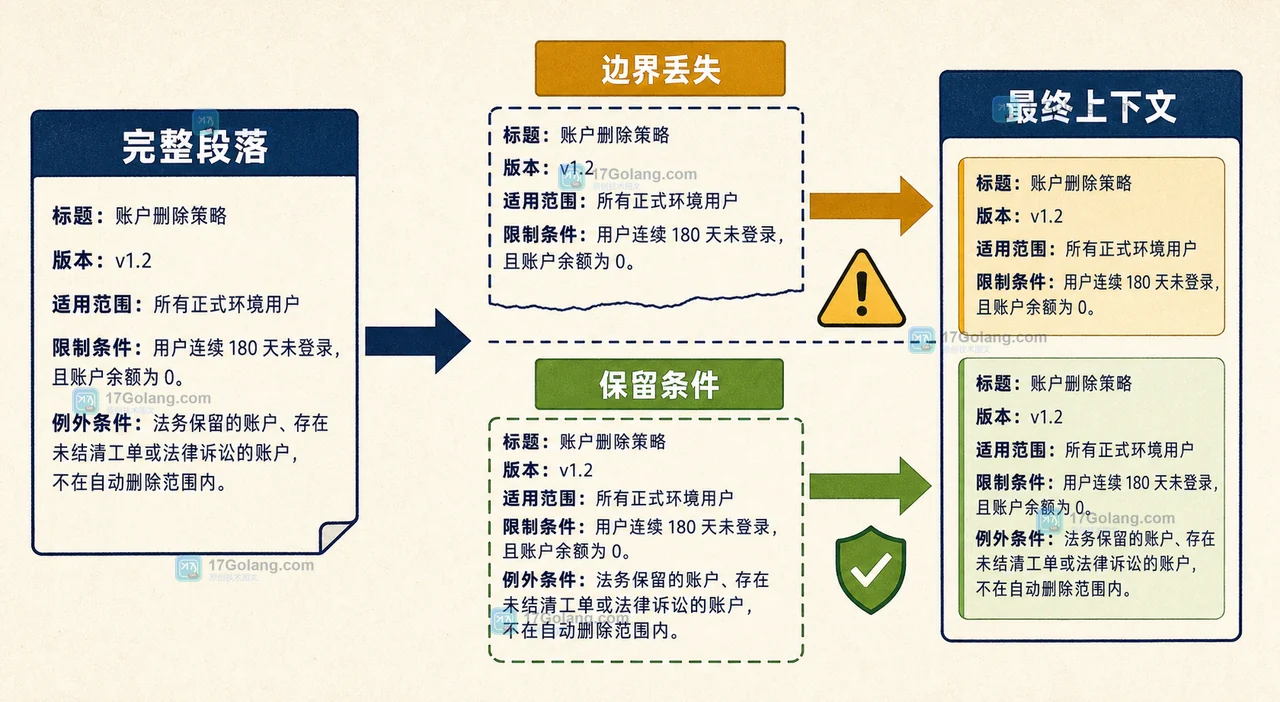 RAG 系统检索到了相关资料却仍然答非所问,通常不是模型单点失误。本文用一个可复现的小实验,依次检查召回内容、切片边界、排序分数和上下文拼接,最后给出可回归的验证方法。309 收藏
-
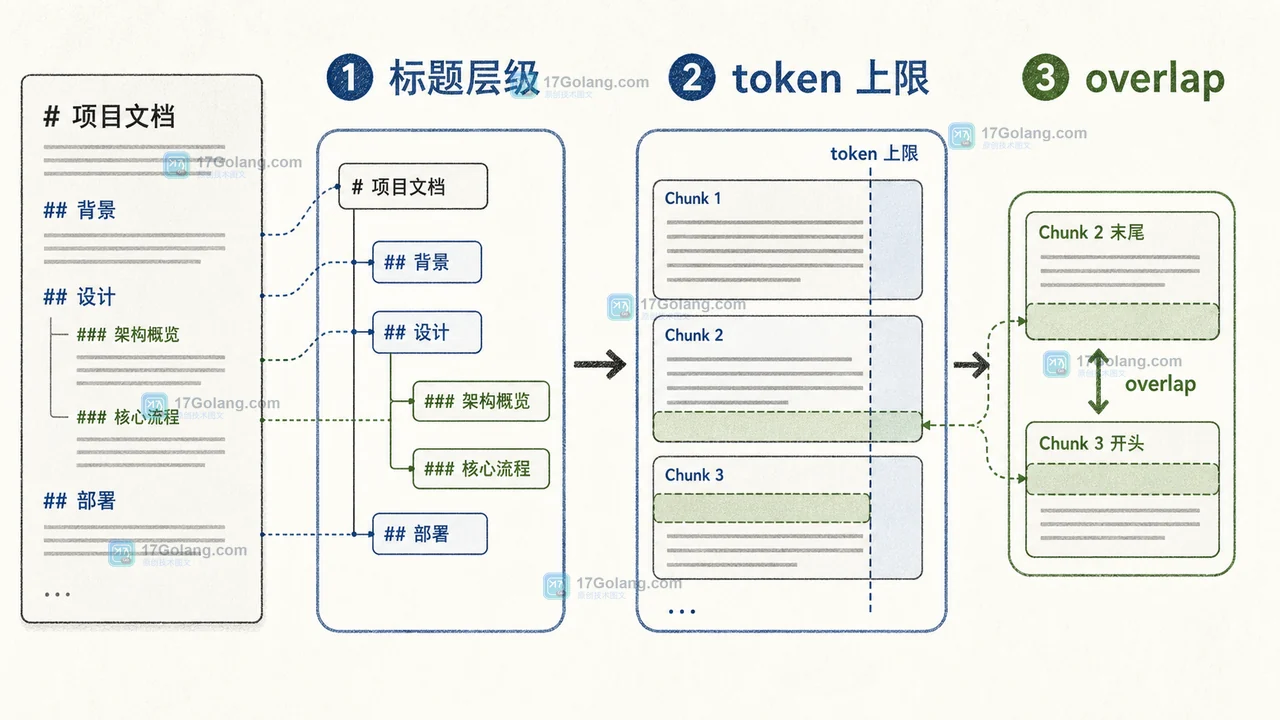 RAG 的 chunk overlap 不是越大越好。本文从标题层级切片、token 上限和检索命中三个可测边界出发,给出一套可复现的初始参数、验证方法和调整顺序。309 收藏
-
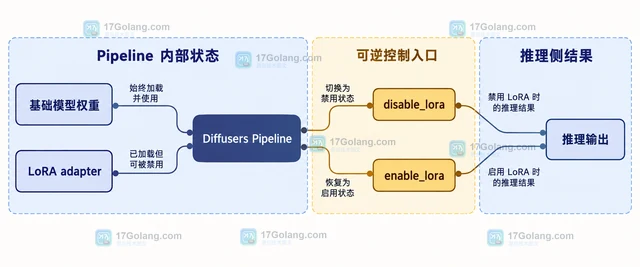 Diffusers 临时禁用 LoRA 不需要卸载权重,调用 disable_lora() 可回到基础模型推理,随后用 enable_lora() 恢复;本文同时区分卸载、删除和多适配器场景。309 收藏
-
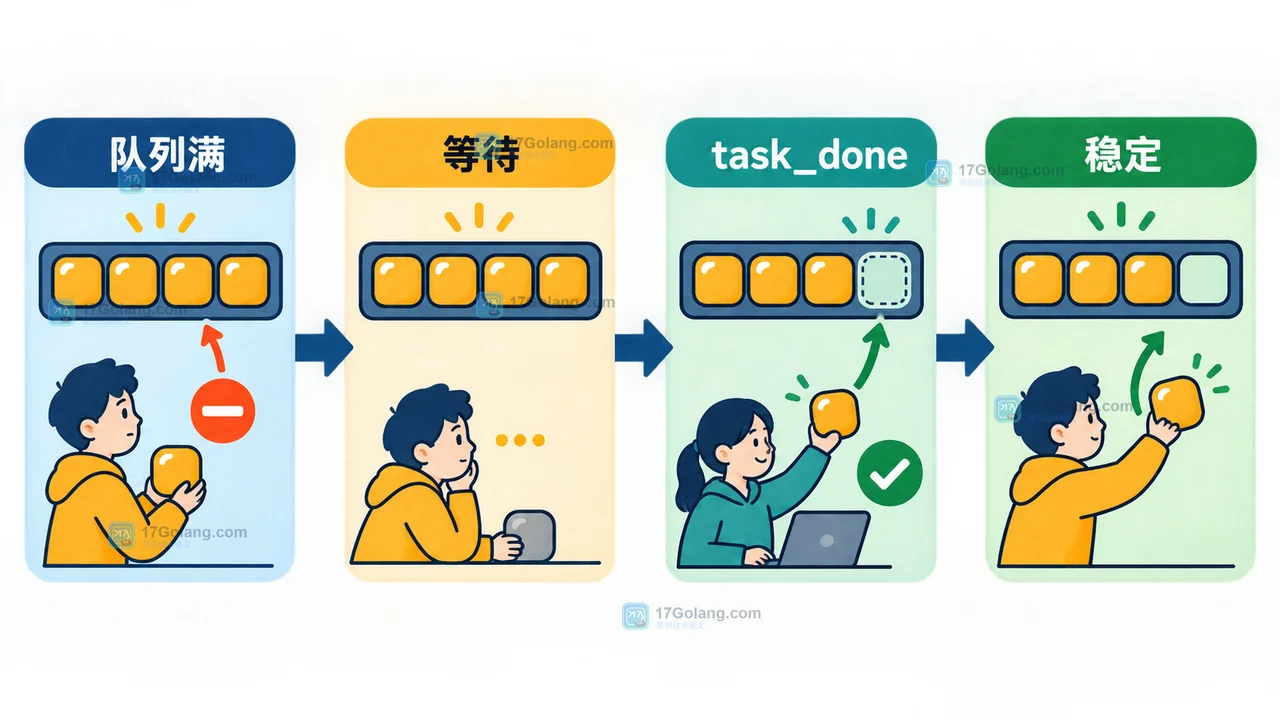 本地视觉模型服务最容易被忽略的问题,不是单次推理慢,而是上传任务无限排队。本文用 Python asyncio.Queue(maxsize=2) 建立背压,让生产者在队列满时等待,并用 inference_mode、task_done 和显存检查验证流水线是否真的稳定。308 收藏
-
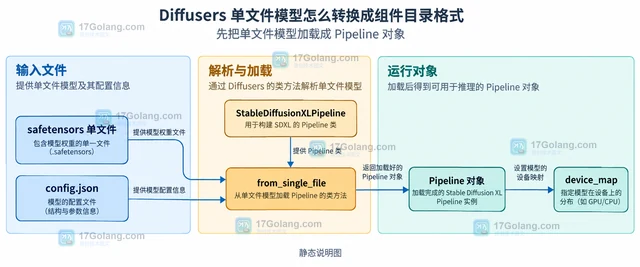 Diffusers 单文件模型不能靠改后缀变成组件目录。正确做法是用匹配的 Pipeline.from_single_file() 读取权重,再用 save_pretrained() 保存配置、组件子目录和权重文件;配置推断失败时显式提供 config。308 收藏
-
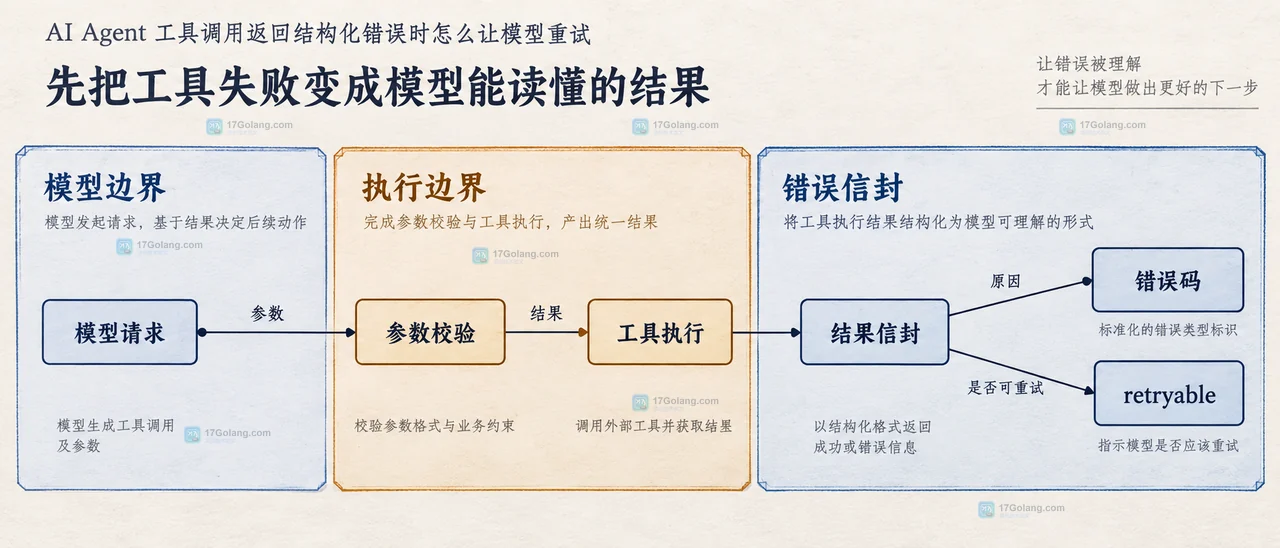 AI Agent 工具调用失败时,不要无条件重放模型请求。本文用统一错误信封、错误码分层、原始 call_id 回传和有限重试预算,让模型只重试可修复问题,并避免副作用重复执行。307 收藏
-
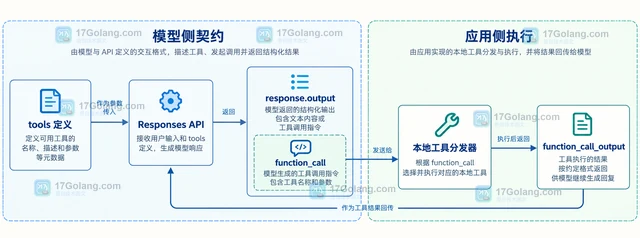 Responses API 不会替应用执行自定义函数。正确做法是读取 function_call,执行本地工具,再用同一个 call_id 回传 function_call_output,让模型继续处理下一次工具调用或生成最终答复。307 收藏
-
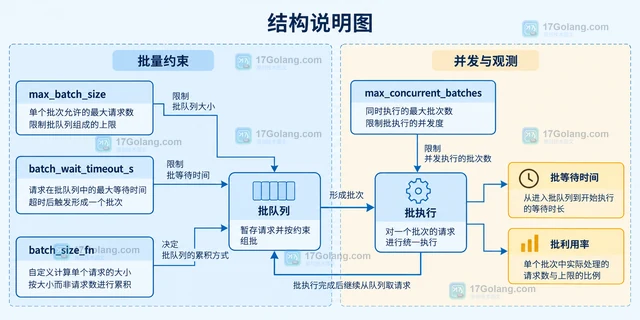 本文围绕 Ray Serve DeploymentHandle 的异步批处理,说明 DeploymentResponse 的提交与等待方式、@serve.batch 的参数边界、等长结果约束,以及如何用批等待和利用率指标判断参数是否合适。307 收藏
-
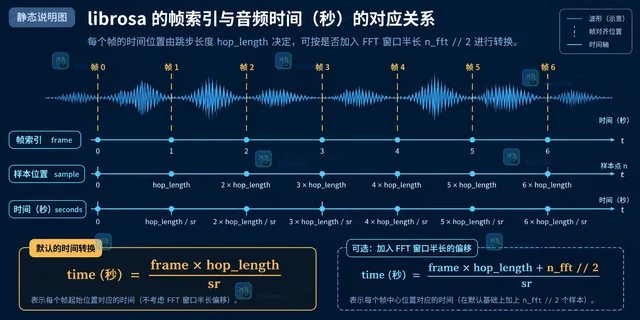 librosa 的 onset_detect 默认返回帧编号,可用 frames_to_time 按 sr 和 hop_length 换算成秒,也可以直接设置 units="time"。本文说明参数一致性、n_fft 偏移和回溯检测的时间边界。306 收藏
-
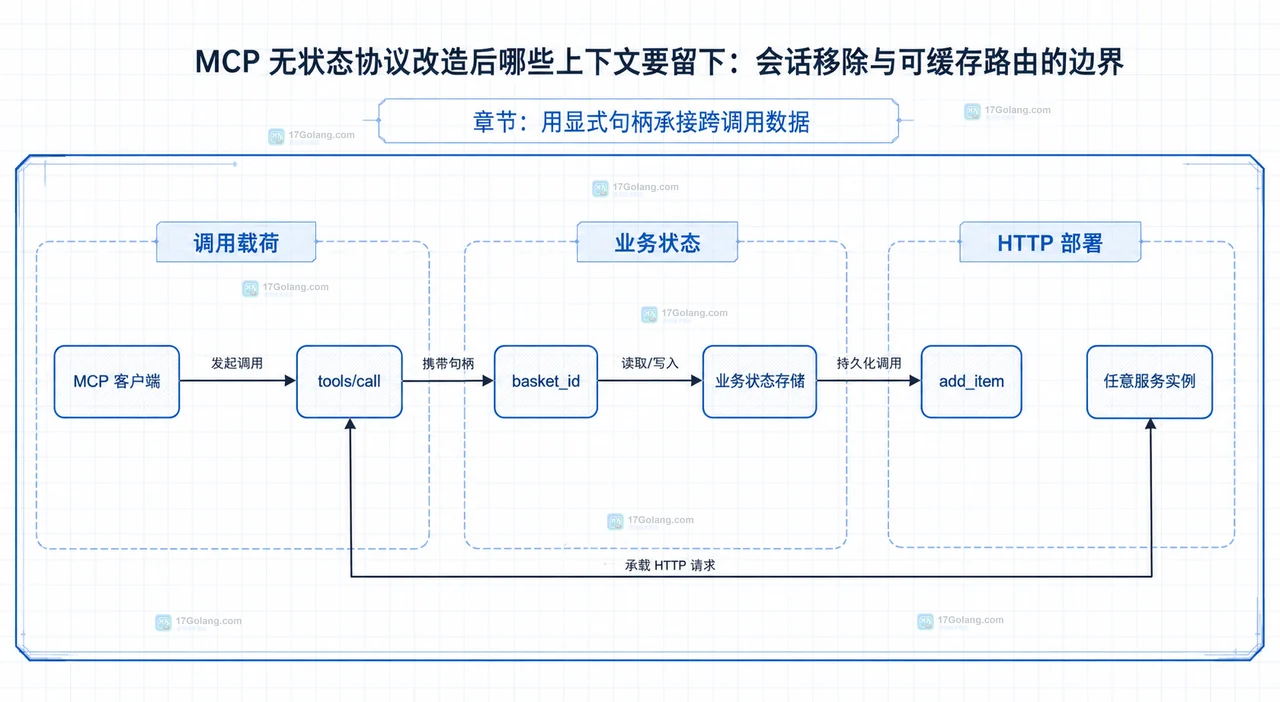 MCP 2026-07-28 无状态改造移除了协议层会话,但业务状态仍需显式保存。文章用 basket_id、Mcp-Method、ttlMs、cacheScope 与 Trace Context 梳理迁移边界。305 收藏
-
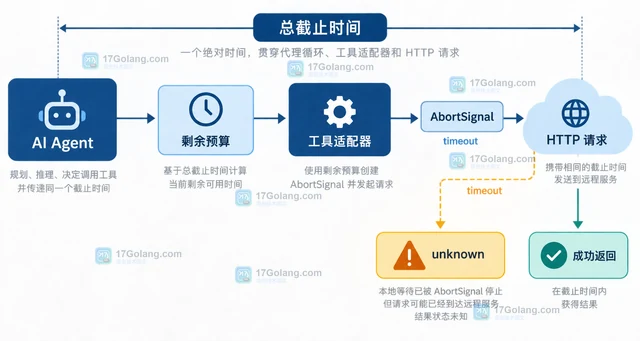 AI Agent 调用外部工具时,超时只解决等待上限,幂等键才解决重复副作用。本文用统一 deadline、幂等账本和结果分类,给出可落地的调用边界与排查清单。305 收藏
-
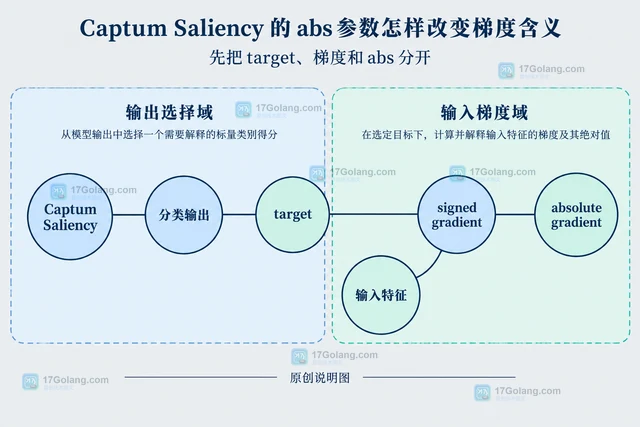 Captum Saliency 的 abs 默认会把输入梯度取绝对值。本文用固定线性分类器对比 abs=True 与 abs=False,说明方向、幅度、target 和输入形状各自代表什么,以及如何避免把梯度误当成概率或因果结论。303 收藏
-
 面向离线推理任务,介绍如何用 Transformers pipeline 接入流式数据、按样本长度和显存选择 batch_size,并为显存不足与失败批次保留可恢复的降级路径。301 收藏