
人工智能技术文章
-
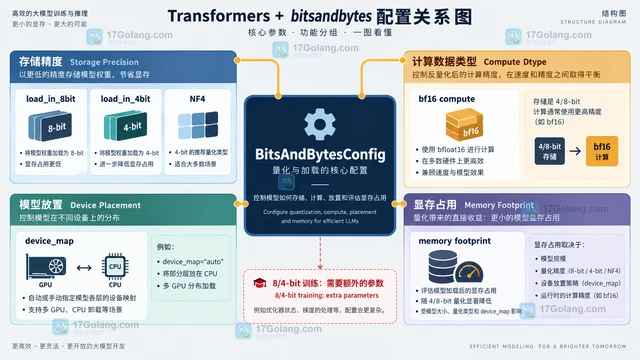 Transformers 量化配置选择的关键不只是显存大小,还要看推理、QLoRA 微调、精度容忍度和硬件后端。本文用 BitsAndBytesConfig 对比 int8 与 int4 的适用边界,并给出检查清单。113 收藏
-
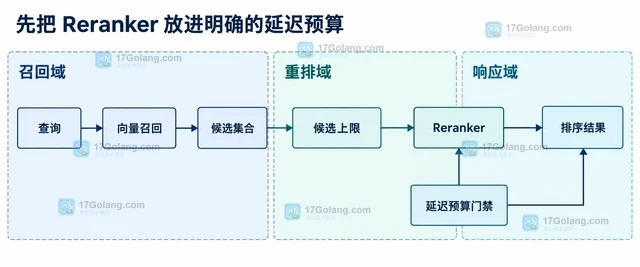 Reranker 通常只应处理召回后的有限候选。本文从延迟预算、候选规模、输入长度、批量和超时降级几个方面,给出一套可落地的检索重排控制方案。113 收藏
-
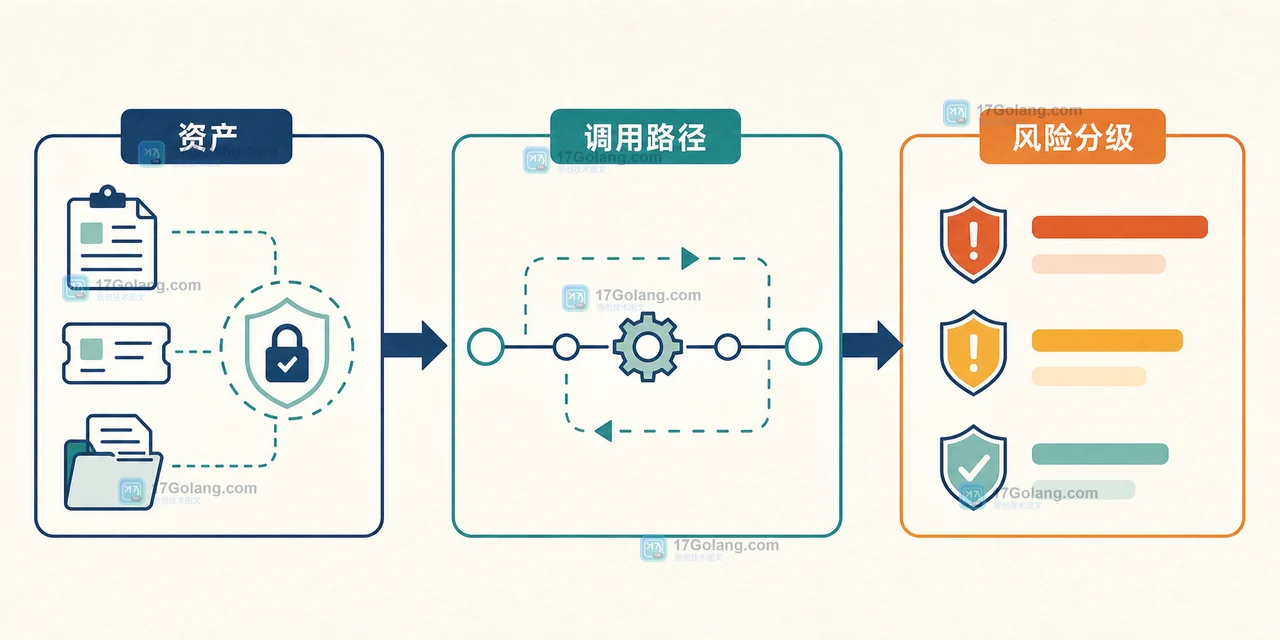 MCP 工具调用遇到超时,不能简单地把所有失败都重试。本文从资产保护、调用路径和错误分级入手,设计一套包含超时、重试、幂等、审计与人工接管的收口方案。111 收藏
-
 RAG 中不要让模型猜来源。给每个检索片段保留稳定 chunk_id,让模型返回可校验的 citations,再由应用层回填标题、页码和原文位置。111 收藏
-
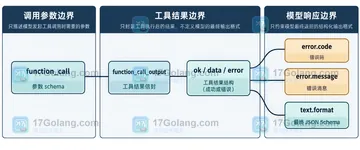 Responses API 的结构化输出不会自动校验工具返回值。本文用统一错误信封、function_call_output 和严格 JSON Schema 保留错误码、消息与可重试标记,并说明为什么还要保存原始工具结果。111 收藏
-
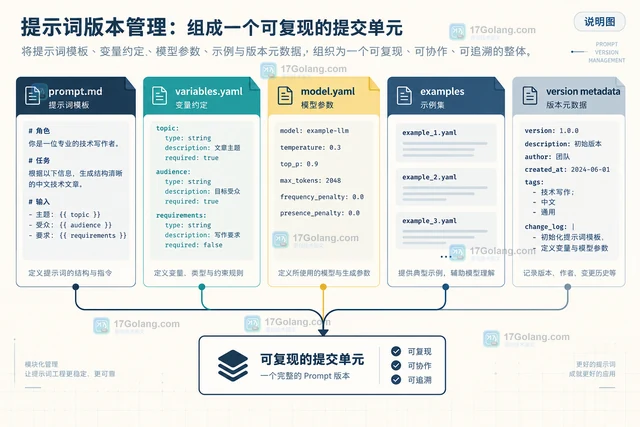 把提示词模板、变量契约和固定回归样例放进同一次 Git 提交,配合输入哈希、模型参数与可回退版本,解决改完提示词却无法复现和比较的问题。111 收藏
-
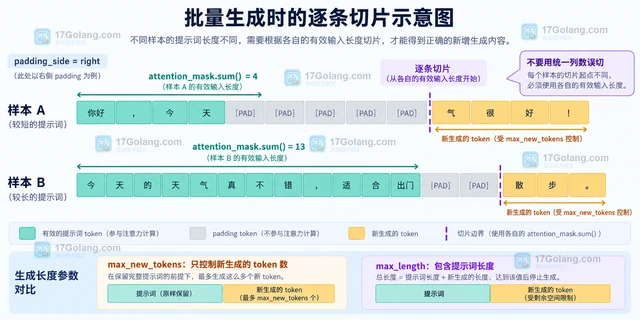 Transformers 的 generate 返回完整序列时,GPT 类 decoder-only 模型会把输入提示词和新增 token 一起返回。本文用 token 长度切片、批量 padding 和 max_new_tokens 说明如何稳定取出真正生成的文本。111 收藏
-
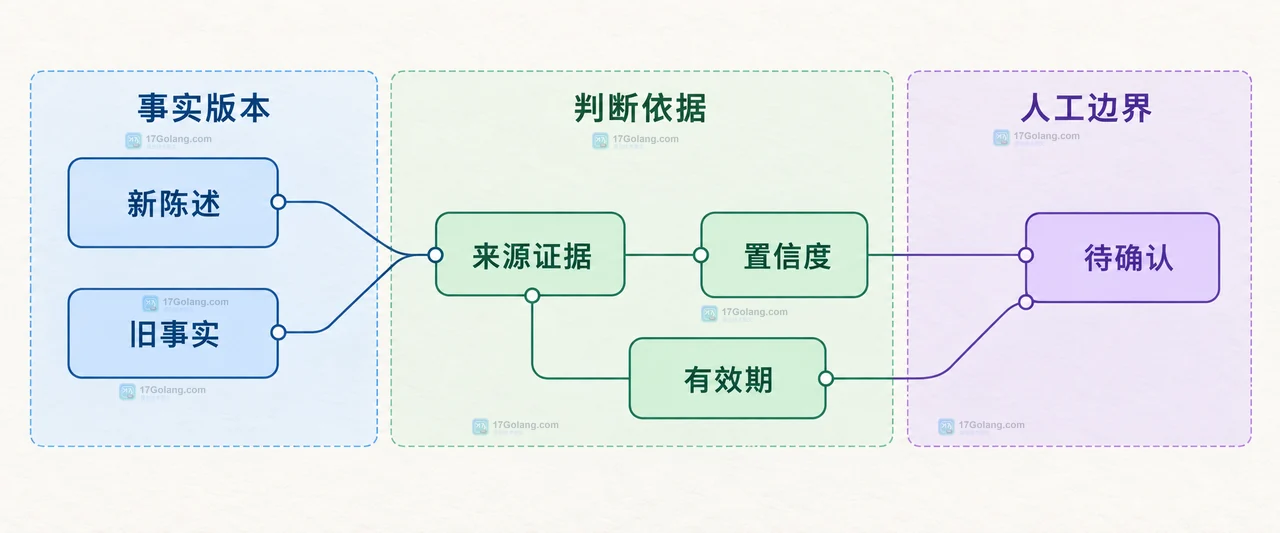 AI Agent 记忆不应把所有对话永久保存。本文用会话、任务和用户事实三层模型,说明字段设计、写入门槛、分层检索与冲突处理方法。110 收藏
-
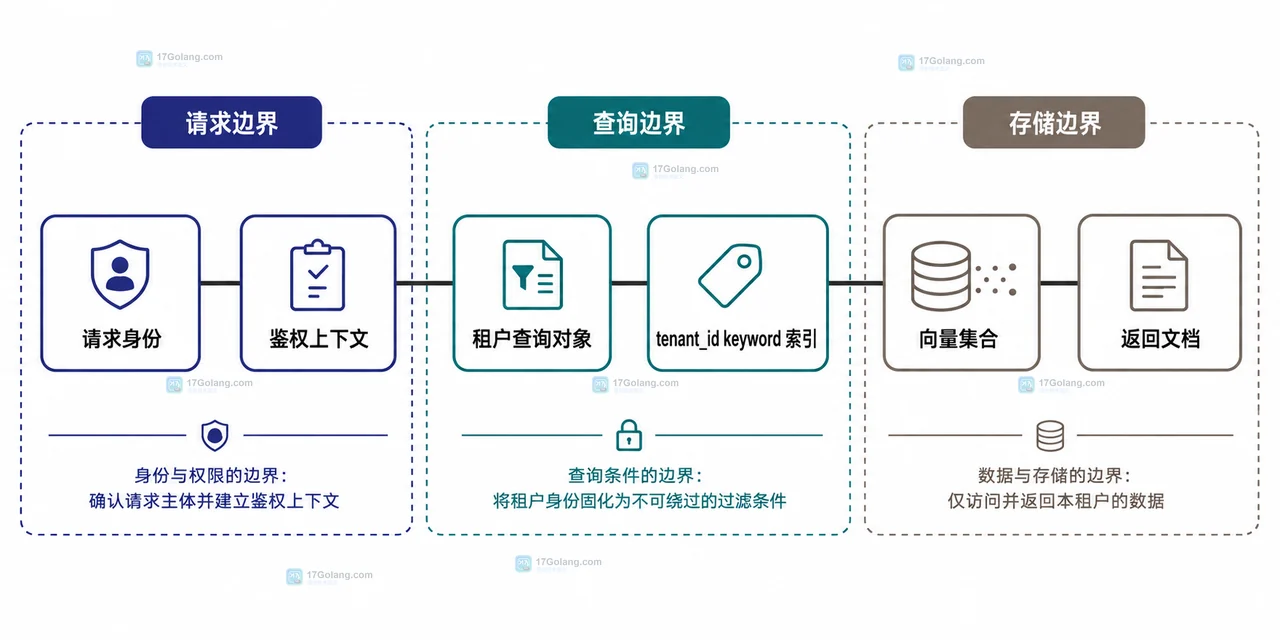 多租户向量检索不能只依赖相似度。本文说明如何从服务端鉴权上下文得到 tenant_id,为记录建立精确过滤字段,并比较共享集合、分区键和独立集合的隔离边界。108 收藏
-
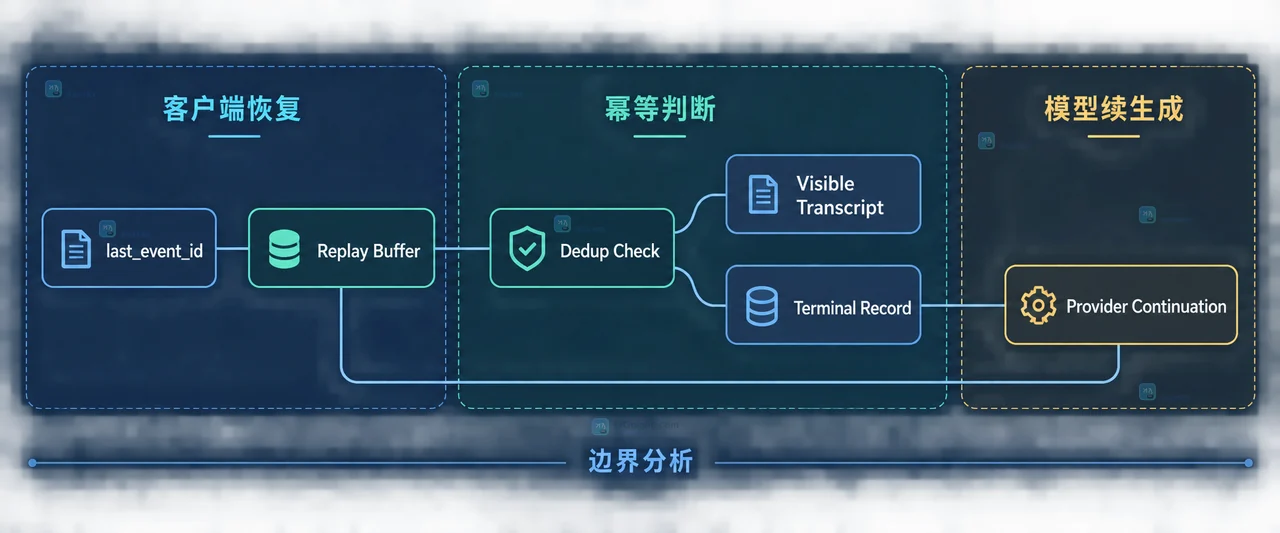 模型流式输出中断时,不要直接把请求重发并拼接全文。先保存 request_id、事件序号和幂等键,重连时重放已确认事件,再按供应商能力决定是否续生成,才能避免重复展示和状态错乱。108 收藏
-
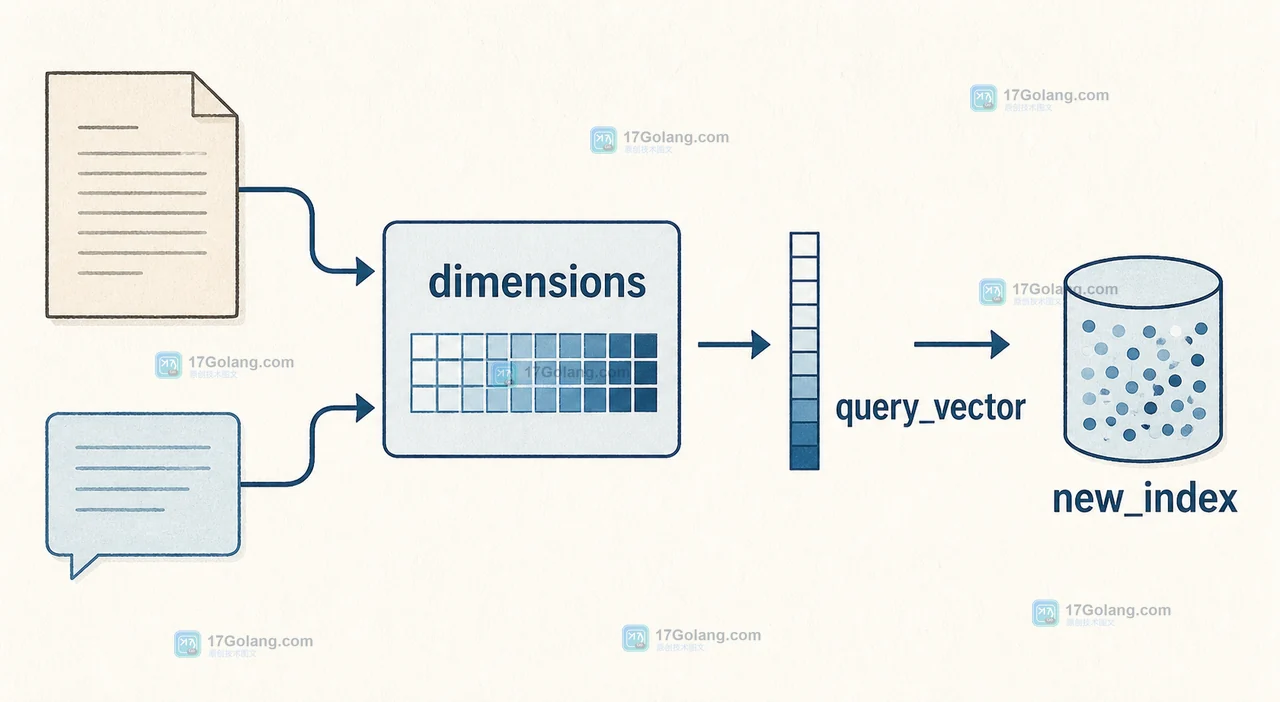 向量检索系统里,模型、dimensions 参数和索引维度必须形成一份可检查的契约。本文用 OpenAI Embeddings 的请求参数、双索引回填和查询路由,说明如何迁移维度而不让新旧向量混在一起。105 收藏
-
 OpenAI Batch API 的输出顺序不保证与输入一致,custom_id 才是回配原始请求的稳定关联键。本文用 JSONL、成功结果、错误结果和重试设计说明如何可靠映射批量任务。105 收藏
-
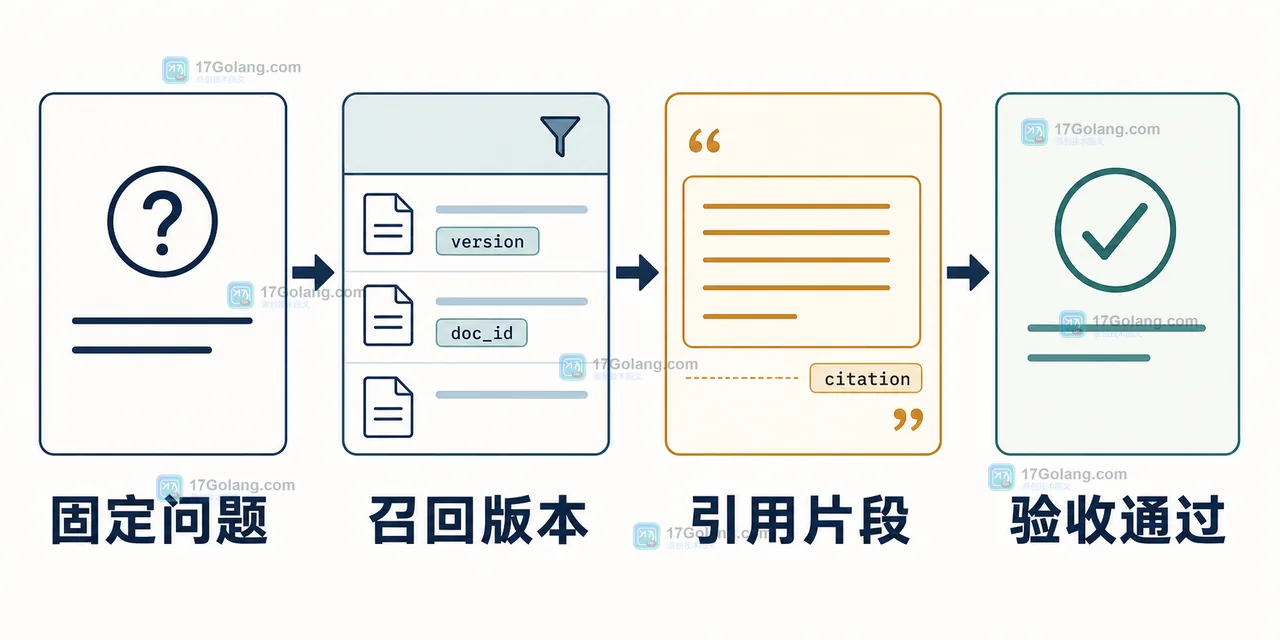 RAG 知识库更新后仍返回旧答案,通常不是模型突然失忆,而是旧分片仍能被召回。本文用文档版本、元数据过滤和固定问题集建立一条可验收的更新流程,覆盖发布、回滚和灰度边界。104 收藏
-
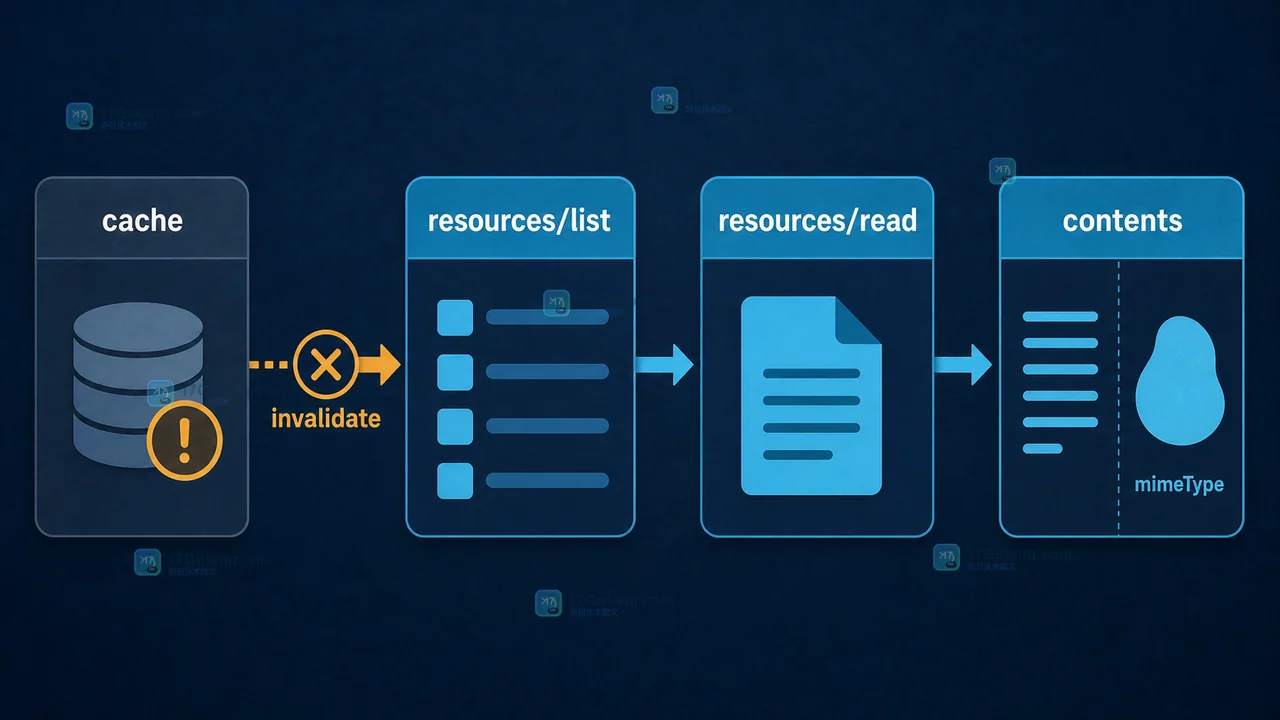 MCP 客户端拿到 resources/read 的空结果时,问题通常不在模型,而在 URI 没有按原值传递、内容类型判断错误或把资源列表缓存成了永久数据。本文按一次可复现的排查顺序,拆开 URI、contents、文本与二进制资源,以及缓存失效边界。104 收藏
-
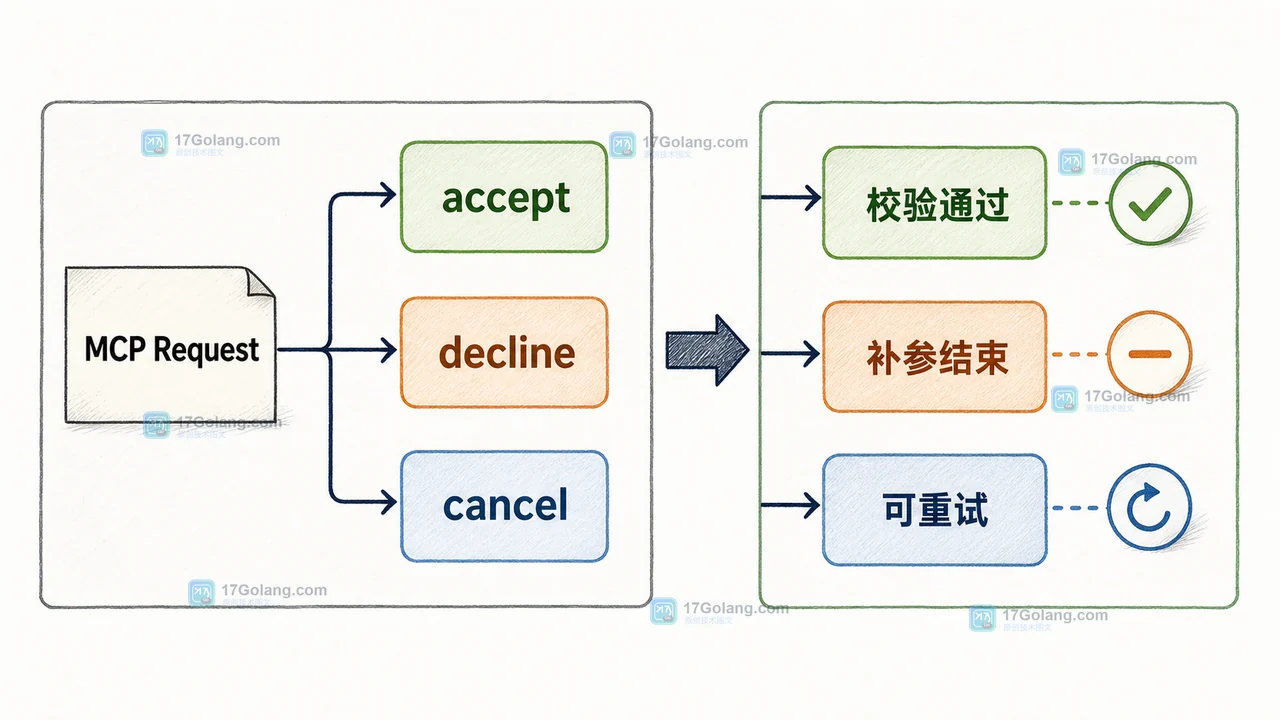 MCP Elicitation 让服务器可以在工具调用过程中向用户请求缺失信息,但客户端必须处理接受、拒绝和取消三种结果。本文用一个日期范围查询示例,说明如何设计请求、校验结构化数据并安全收口。103 收藏