-
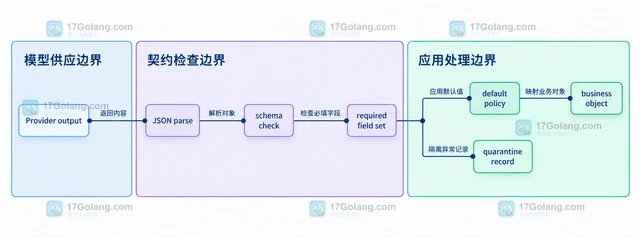
AI 结构化输出遇到字段缺失时,先用 JSON Schema 明确必填与可选字段,再在应用解析边界执行缺失检查、默认值和异常隔离。本文以 Hugging Face Inference Providers 的结构化输出为背景,给出一套可迁移的处理方式。
-
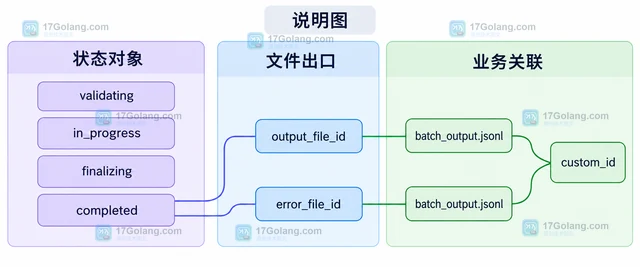
用 JSONL 准备请求,上传为 Batch 输入文件,再通过 input_file_id 创建 24 小时完成窗口的离线任务,并按 output_file_id 取回结果。
-
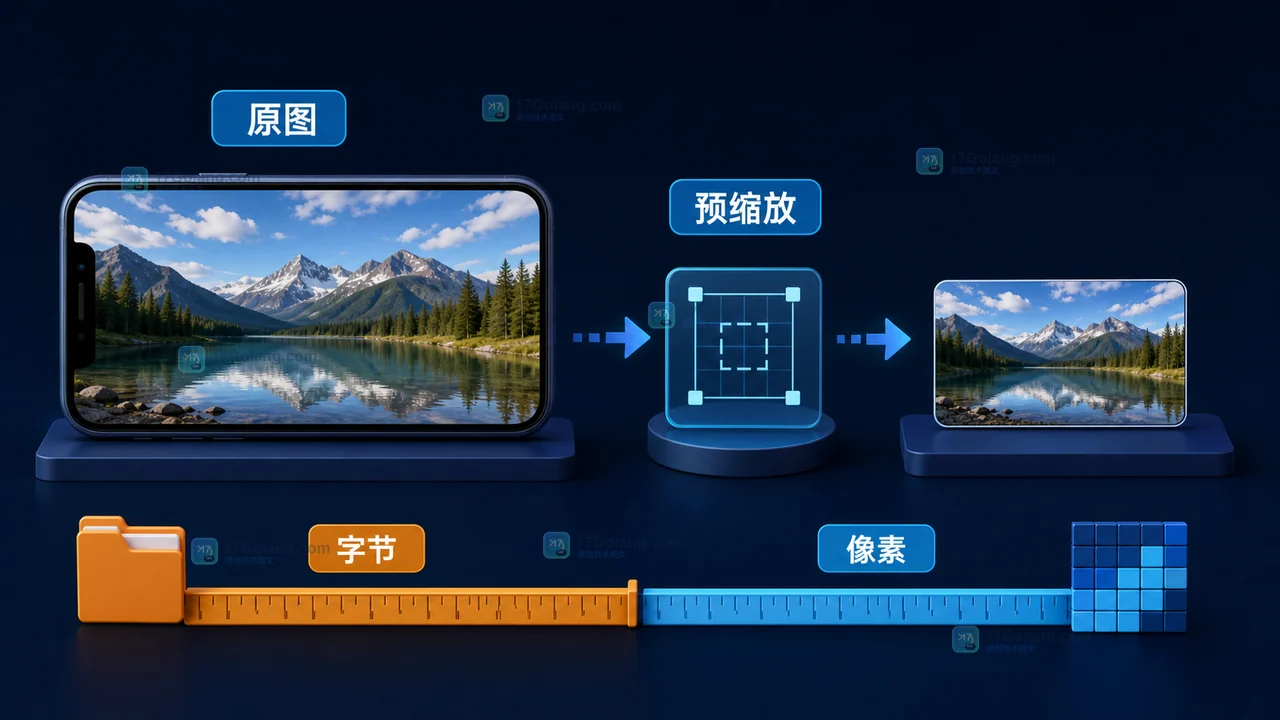
视觉模型遇到 20MB 以上图片时,真正棘手的是尺寸预算、上传方式和重试边界同时变化。本文从请求前预缩放、分块上传到失败回收,拆解一条可验证的图片输入链路,并说明什么时候应该拒绝重试。
-
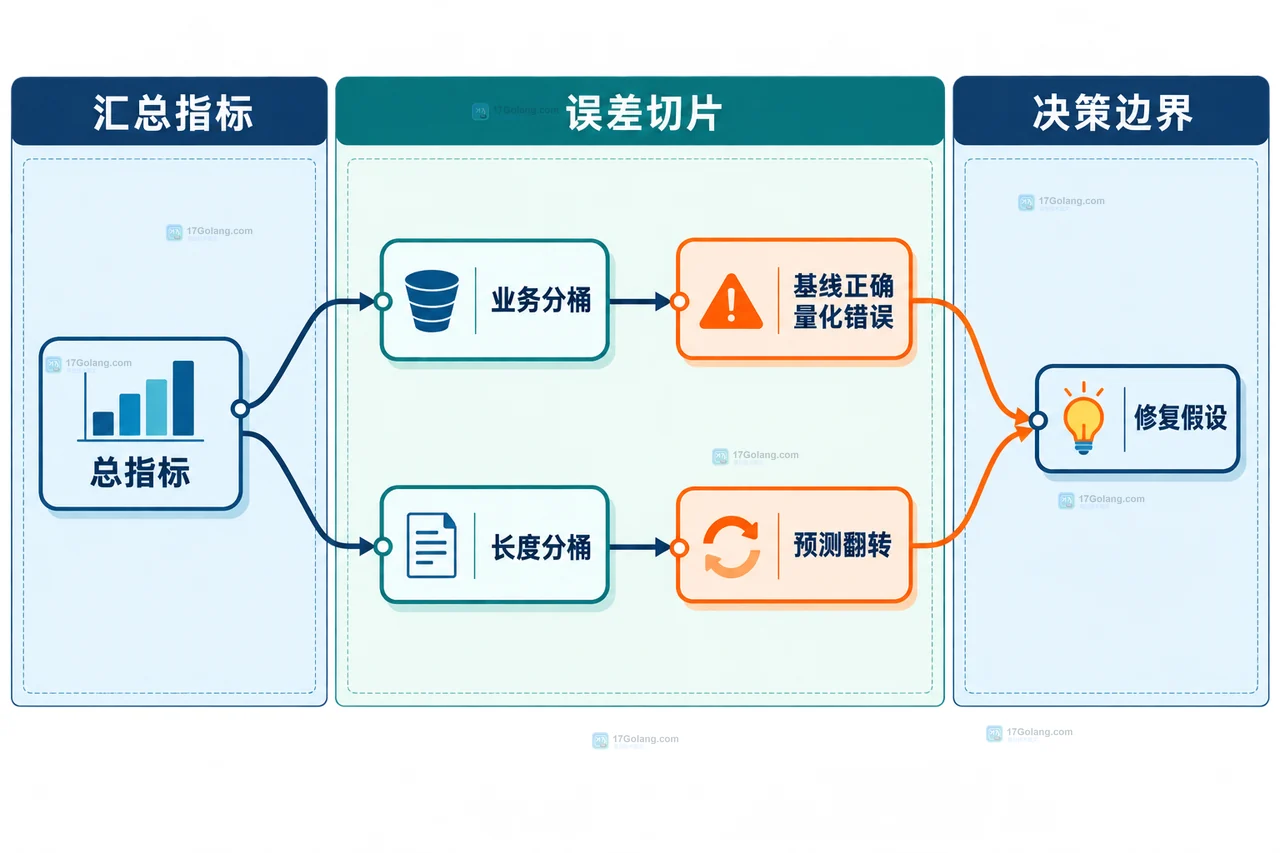
量化模型精度下降时,不要只看一个总分。本文用固定输入、配对预测和分桶误差,区分评测条件不一致、长输入敏感与校准集覆盖不足,并给出可复用的对照脚本。
-
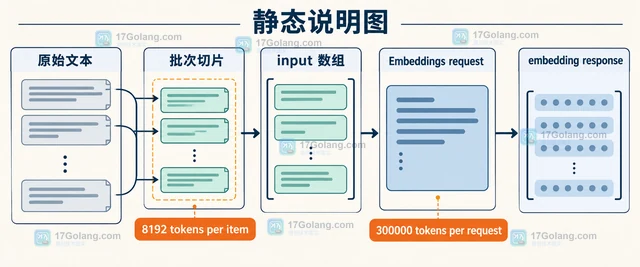
OpenAI Embeddings 支持在一次请求中传入多条文本。本文用 Python 组织可控批次,说明单条输入、整批 token、返回 index、失败重试和 dimensions 的边界。
-
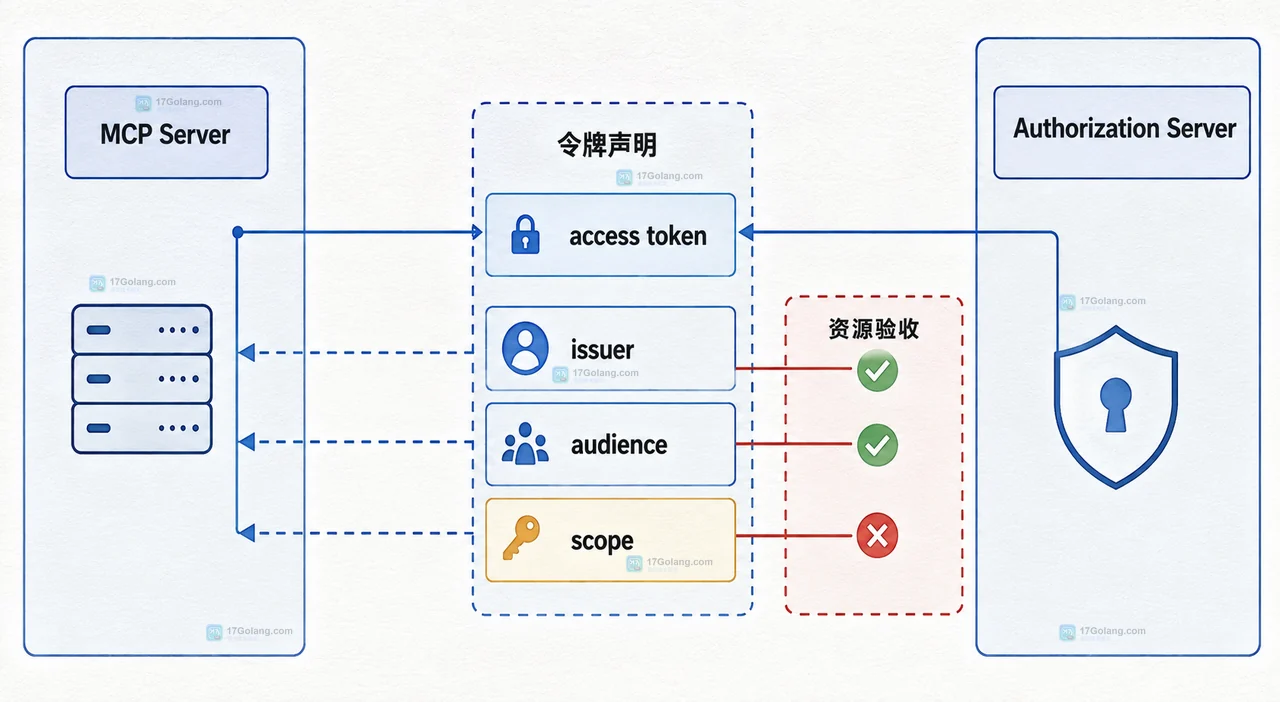
远程 HTTP MCP 的 OAuth 授权不能只把 Bearer token 透传过去。客户端要以 MCP 服务器的 canonical URI 作为 resource,同时放入授权请求和令牌请求;服务端还要校验 token 是否确实签发给自己。本文用一个最小实现拆开这条受众绑定链路,并说明 401、403 与跨服务器误用的边界。
-
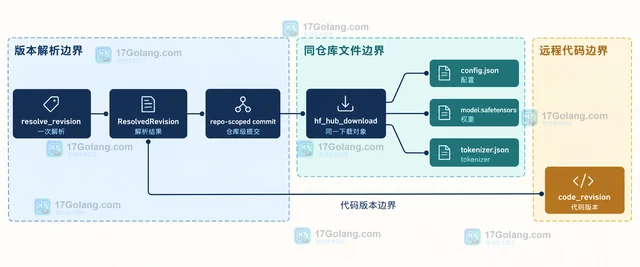
Hugging Face Hub 的 revision 可以指向分支、标签或提交版本。本文从单文件、整仓库和 Transformers 加载三种场景说明怎样固定模型版本,并用 resolve_revision 解决多组件下载时版本漂移的问题。
-
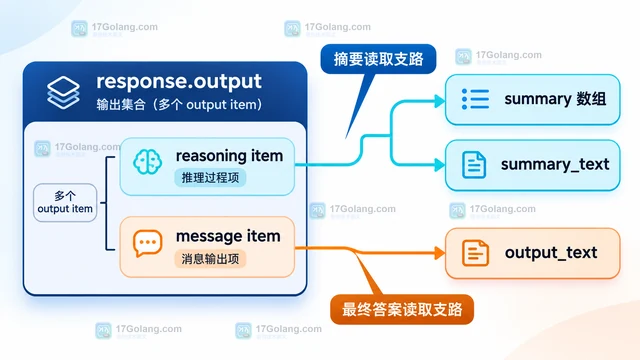
Responses API 不会默认返回 reasoning summary。本文用 reasoning.summary 开启摘要,遍历 reasoning output item 读取 summary_text,并说明 effort、output_text 与模型支持差异。
-

RAG 系统把 Markdown 表格按换行或固定字符数切开后,检索结果常常只剩半行字段,模型看似答对却无法说明数据关系。本文用 Markdown AST 识别表格边界、保留表头与行上下文,再用可验收的切片结果接入向量索引。
-
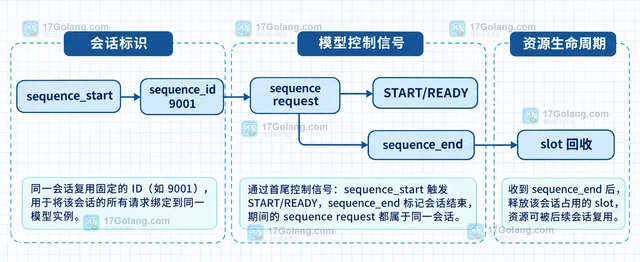
本文围绕 Triton sequence batcher 的 direct scheduling,说明 sequence_id、模型实例、batch slot 和 sequence 控制信号如何配合,让同一会话持续落到同一有状态模型实例;同时区分 direct 与 oldest 策略中 correlation ID 的职责。
-
在 Transformers generate 中自定义 StoppingCriteria,用 tokenizer 生成的 token 序列匹配 等标记,并处理批量生成、提示词误匹配和兜底长度限制。
-
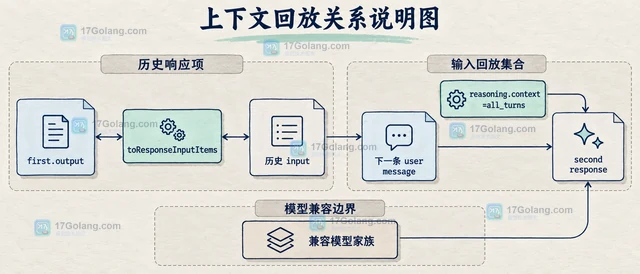
Responses API 在 store=false 或零数据保留场景下仍可延续推理上下文。本文说明如何原样保留 reasoning output item、回放 encrypted_content,并处理 all_turns、模型家族和数据边界。
-
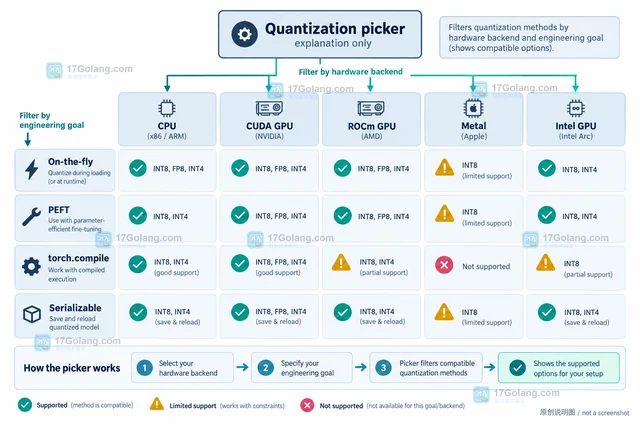
Transformers quantization picker 不是按 4-bit 或 8-bit 盲选,而是结合硬件后端、显存、KV cache、在线量化、PEFT 和编译目标筛出可行方法。本文给出一套按硬件落地的选择步骤与最小验证代码。
-
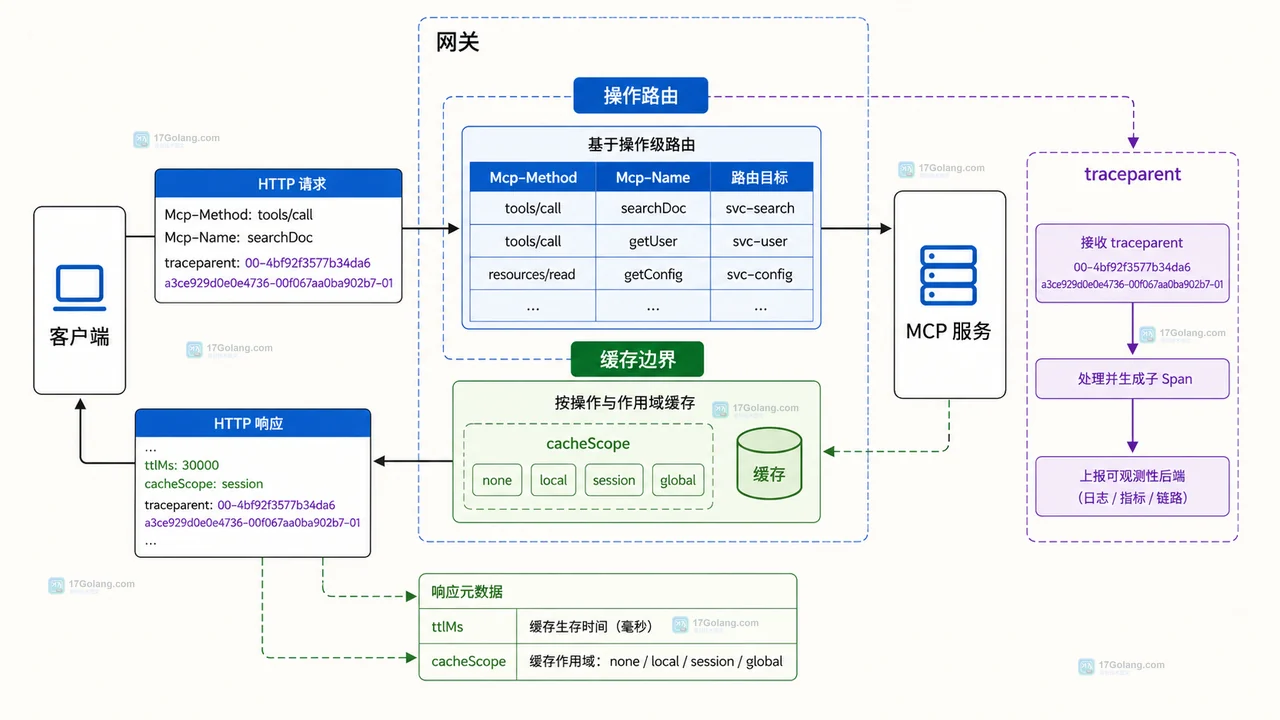
MCP 2026-07-28 将协议层改为无状态,但业务仍可能有状态。本文用显式句柄、请求级路由、缓存范围和 Trace Context 拆解迁移边界。
-
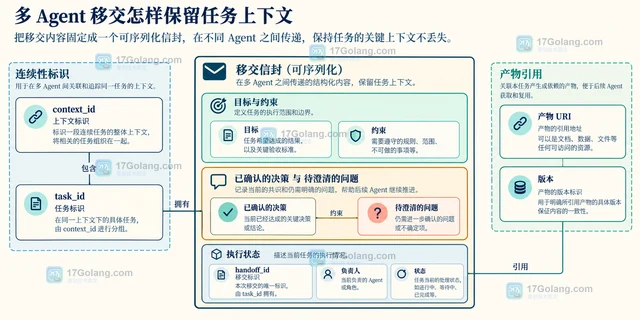
多 Agent 系统移交失败,通常不是模型不会推理,而是接手方没有拿到结构化目标、约束、已确认决定和当前产物。本文用移交信封、contextId/taskId 分层、上下文裁剪、版本与回滚说明怎样保留真正有用的任务上下文。
