
人工智能技术文章
-
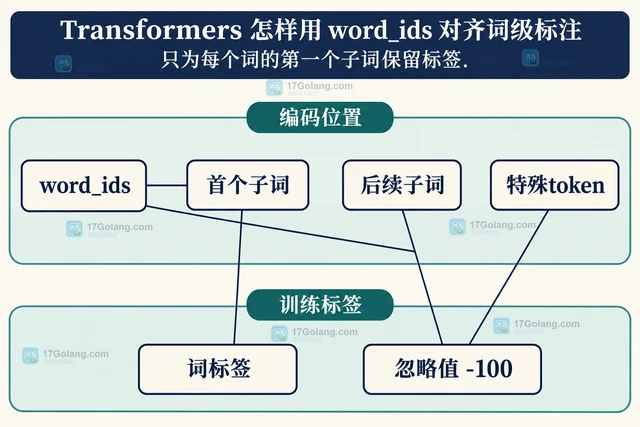 Transformers word_ids 将 token 映射到原始词索引。本文给出 Fast tokenizer 批量词级标注示例,说明首子词监督、特殊位置忽略、截断及标签补齐的处理。378 收藏
-
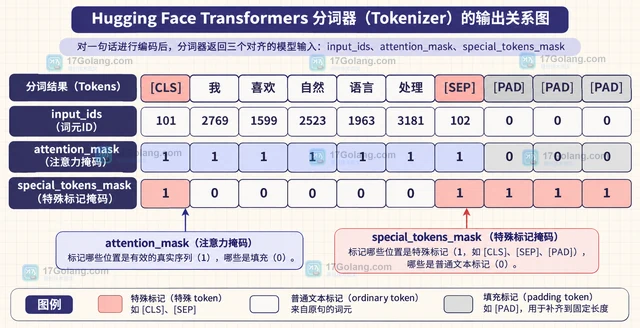 Transformers 的特殊 token 位置掩码由 return_special_tokens_mask=True 返回,1 表示 [CLS]、[SEP]、[PAD] 等特殊 token,0 表示普通序列 token。文章区分它与 attention_mask 的用途,并给出句对、padding 以及手动拼接 token ID 时的处理方式。367 收藏
-
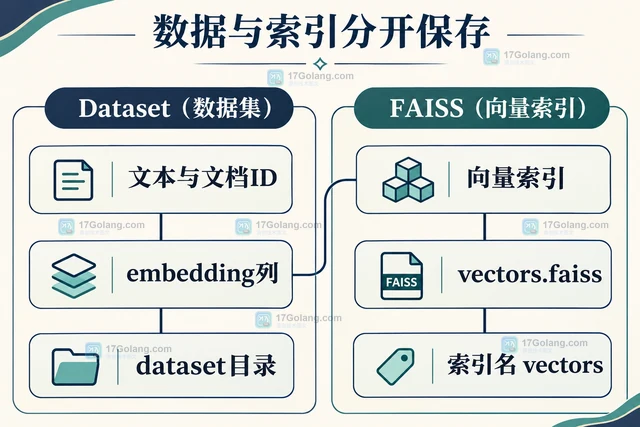 Hugging Face Datasets 可用独立文件保存与载入 FAISS 索引。本文给出数据快照和索引分开落盘的示例,说明索引名称、行顺序及载入失败的排查方法。403 收藏
-
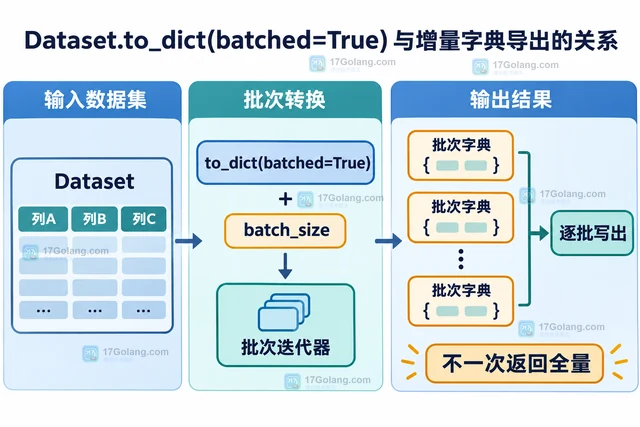 用 Dataset.to_dict(batched=True) 按 batch_size 分批导出列式字典,并对比 to_json、行式记录和 IterableDataset 的使用边界,避免一次聚合全量数据。241 收藏
-
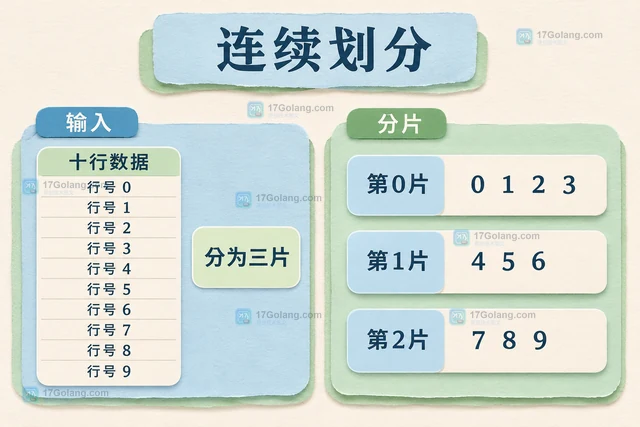 比较 Hugging Face Dataset 连续分片与交错分片的行号分配,说明分块处理、原序合并及流式接口的差异。123 收藏
-
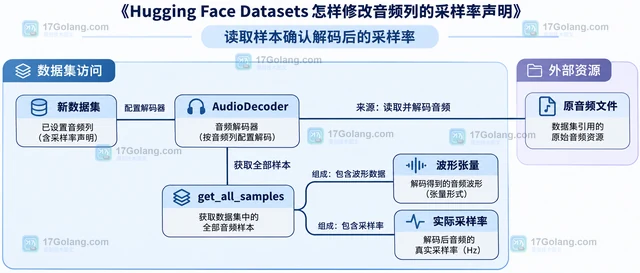 Hugging Face Datasets 可用 cast_column 和 Audio 设置音频列目标采样率。通过本地文件示例区分特征声明、按需解码重采样与原文件导出,并说明新旧返回接口的差异。215 收藏
-
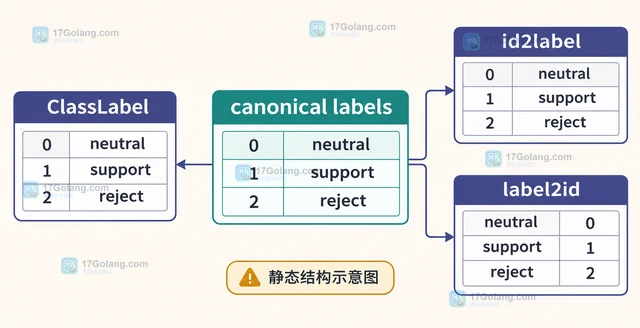 用同一份有序标签表同步 Hugging Face Datasets 的 ClassLabel 与模型的 id2label、label2id,避免训练和评估阶段出现标签名称错位。366 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · Hugging Face Datasets DatasetDict train_test_split stratify_by_column 机器学习数据集
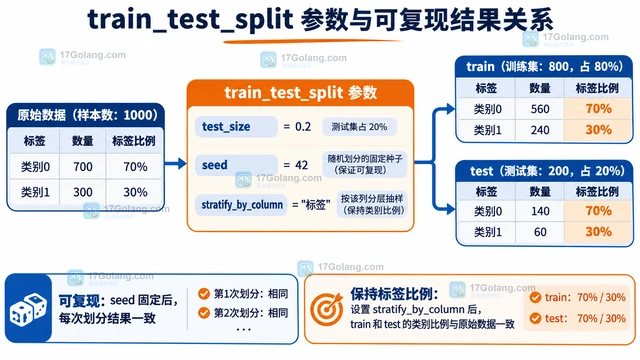 Hugging Face Datasets 的 train_test_split 默认会随机切分;给 stratify_by_column 传入标签列名,才能让训练集和测试集尽量保持类别比例。本文用人工构造的 Dataset 说明 test_size、seed、标签类型与稀有类别的处理边界。410 收藏
-
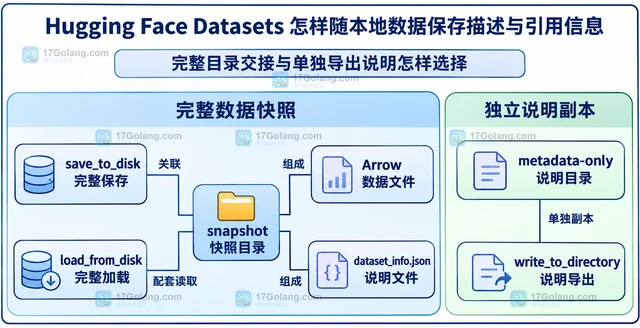 Hugging Face Datasets 可通过 DatasetInfo 绑定描述与引用,再用 save_to_disk 随本地快照保存。本文给出人工演示数据的完整写法,区分配套加载、单独导出说明及交付目录的使用边界。268 收藏
-
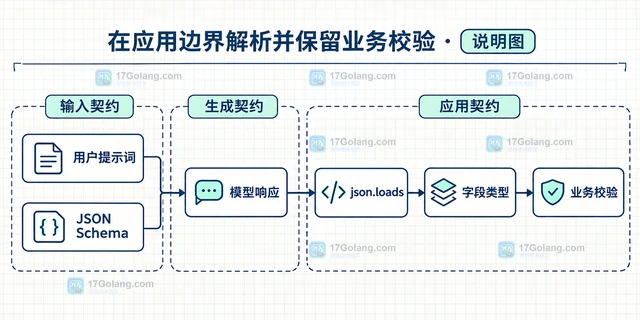 本文用一个工单分类示例说明 vLLM OpenAI 兼容服务如何通过 structured_outputs.json 接收 JSON Schema,约束字段、类型和枚举值,并在应用层继续完成 JSON 解析与业务校验。240 收藏
-
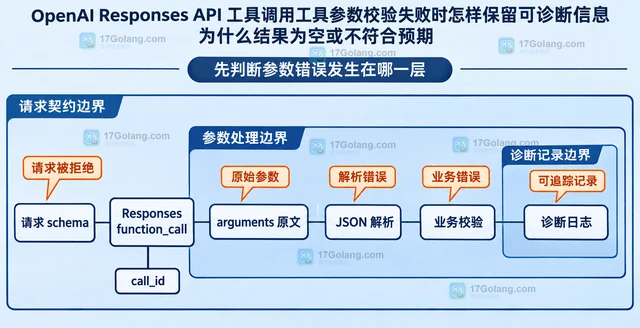 Responses API 的工具调用出现参数校验失败时,空的 output_text 不一定代表没有结果。本文区分 schema 请求拒绝、function_call 返回和应用侧校验失败,给出保留原始参数、call_id 与结构化错误的处理方式。354 收藏
-
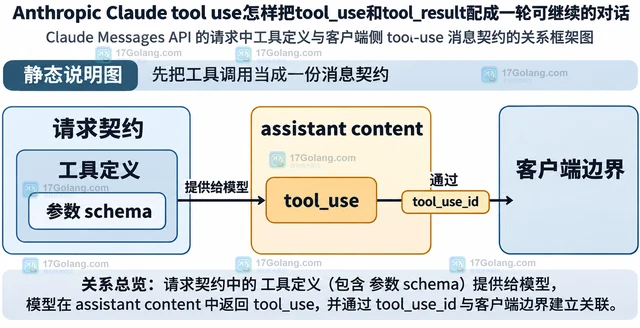 Claude 客户端工具调用最容易错在消息回填:先保存完整的 assistant tool_use,再执行白名单工具,最后用原 tool_use_id 把结果放进 user 的 tool_result。本文用 Python 示例讲清消息顺序、错误处理和审计边界。158 收藏
-
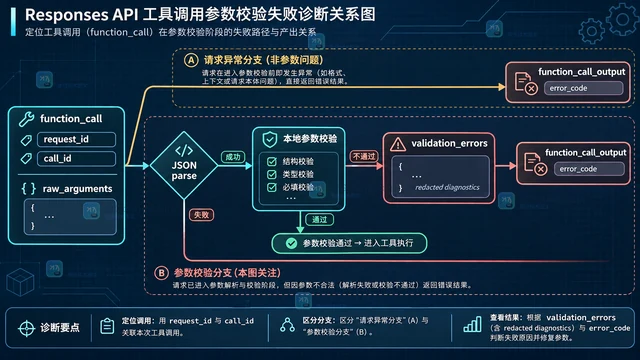 用一个 Python 最小示例拆开 Responses API 工具调用的 schema 拒绝、参数 JSON 解析和本地校验失败,保留 request_id、call_id 与脱敏诊断,并说明严格模式的边界。106 收藏
-
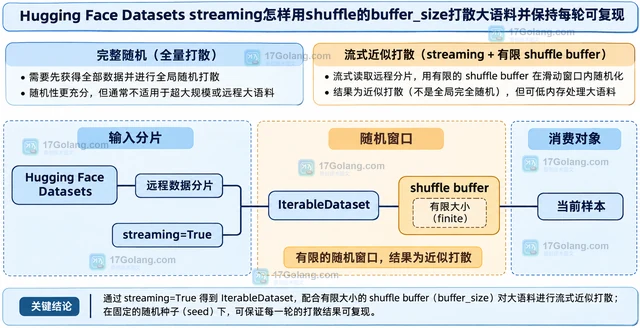 Hugging Face Datasets 的 IterableDataset.shuffle 使用有限缓冲区近似打散流式语料。本文说明 buffer_size、seed、shuffle 顺序与 set_epoch 的关系,帮助你在多轮读取中保持可复现而不误解随机范围。113 收藏
-
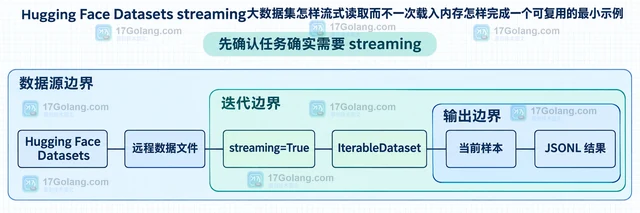 用 Hugging Face Datasets 的 streaming=True 创建 IterableDataset,按需读取大数据集并写入 JSONL,同时说明 take、shuffle、skip、shard 与随机访问的适用边界。306 收藏